Hochleistungsfähiges Edge Tunneling: Zero-Copy I/O, NAT Traversal und QUIC 0-RTT Architektur
Meistern Sie die Low-Level-Tunnel-Optimierung. Erfahren Sie, wie Linux splice/vmsplice, UDP-Hole-Punching, PCP und QUIC 0-RTT Latenz reduzieren und CPU-Overhead eliminieren.
Quick answer
Hochleistungsfähige lokale Tunnel: Zero-Copy, CGNAT & QUIC: localhost tunnel answer
A localhost tunnel gives your local app a public HTTPS URL without opening router ports, which is useful for demos, QA, mobile testing, and provider callbacks.
How do I expose localhost without opening ports?
Use a reverse HTTPS tunnel. Your machine connects outbound to the tunnel service, and the public URL forwards requests back to your local app.
When should I use a localhost tunnel?
Use one for webhook testing, OAuth callbacks, client demos, QA previews, mobile device checks, and short-lived development reviews.
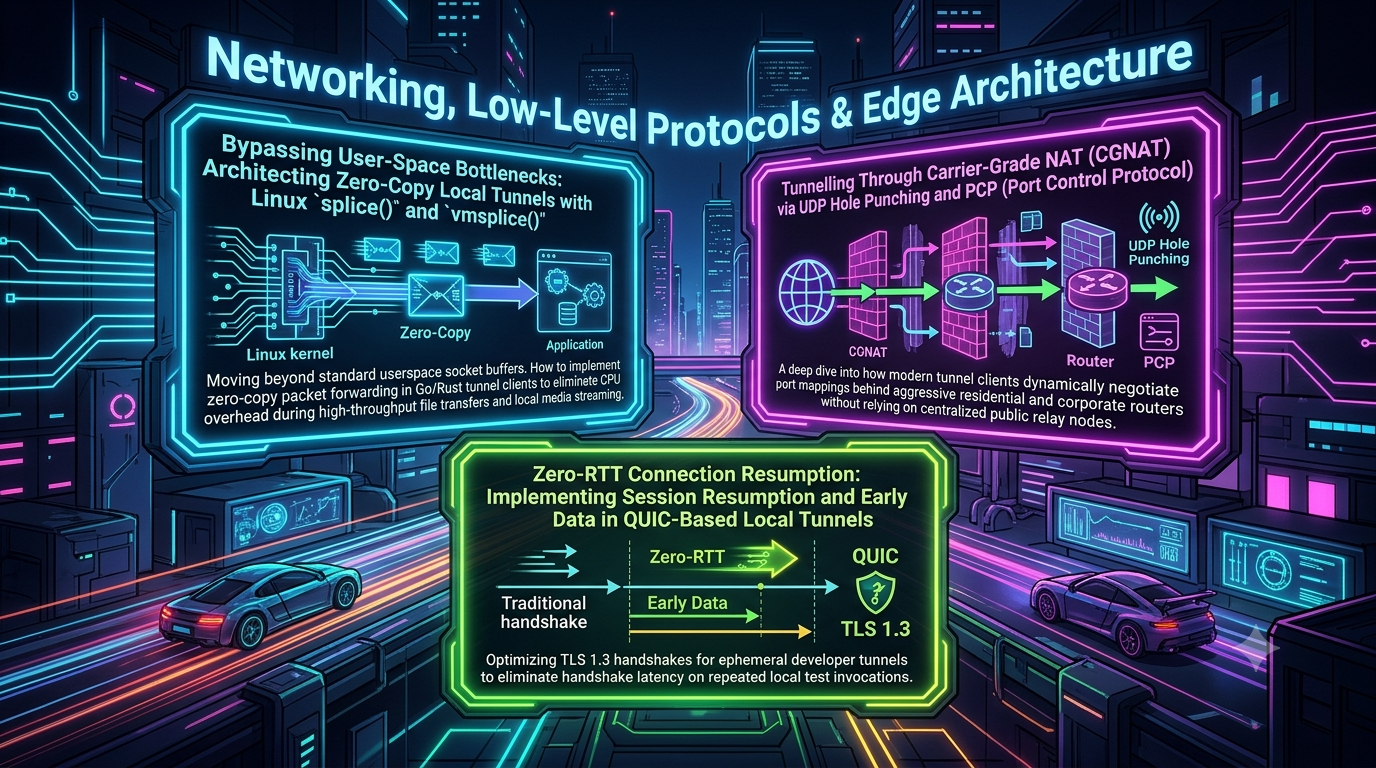
Ein schneller, robuster Tunnel-Client bedeutet, die Grenzen auf drei verschiedenen Ebenen zu umgehen:
- Kernel-zu-Userspace-Overhead: Jedes Byte, das ein Proxy weiterleitet, wird zweimal über die Kernel-/User-Grenze kopiert, und jeder Chunk kostet zwei Systemaufrufe.
- Netzwerktopologie: harte (endpointabhängige) NATs und Carrier-Grade NAT (CGNAT) behindern direkte Peer-to-Peer-Pfade.
- Transport-Latenz: eine frische TCP + TLS-Verbindung benötigt Round-Trips für das Handshake, bevor das erste Request-Byte gesendet werden kann, was kurze Anfragen beeinträchtigt.
Dieser Leitfaden behandelt die Kernel-Primitives, Protokolle und Design-Trade-offs für jede Ebene. Er zeigt auch, wo jede Technik aufhört zu helfen, weil die drei Ebenen auf eine Weise interagieren, die leicht falsch verstanden werden kann. Jeder Codeausschnitt wurde kompiliert und ausgeführt, entweder gegen einen Loopback-Echo-Test oder gegen einen Mock-Server.
Teil 1: Das Kopieren im User-Space mit splice() reduzieren
Ein herkömmlicher User-Space-Forwarder liest von einem Socket in einen Anwendungs-Puffer, schreibt diesen Puffer dann in einen anderen Socket:
[ Traditionelles Forwarding ]
Kernel : [ Socket A recv buffer ] --read()--3e (Kopie) --+
                                                       v
User   :                              [ Anwendungs-Puffer ]
                                                       |
Kernel : [ Socket B send buffer ] 3c--write()-- (Kopie) -+
Bei Massenübertragungen kostet dies zwei Kopien pro Chunk, zwei Systemaufrufe pro Chunk und einen User-Space-Puffer, der um die CPU-Cache konkurriert.
Was splice() macht
Laut Linux man page verschiebt splice() Daten zwischen zwei Dateideskriptoren, ohne zwischen Kernel- und User-Address-Space zu kopieren. Mindestens einer muss eine Pipe sein. Der Aufruf ist seit Linux 2.6.17 vorhanden, und seit 2.6.31 können beide Deskriptoren Pipes sein. Zusammen mit vmsplice(2) und tee(2) gibt es einem Programm Kontrolle über einen Kernel-Puffer, der mit dem gleichen Puffer-Typ wie Pipes implementiert ist.
[ Splice-Pipeline ]
Kernel : [ Socket A ] --splice--3e [ Pipe-Puffer ] --splice--3e [ Socket B ]
User   :   (keine Nutzdaten hier sichtbar)
Die Signatur:
#define _GNU_SOURCE
#include <fcntl.h>

ssize_t splice(int fd_in, loff_t *off_in,
               int fd_out, loff_t *off_out,
               size_t len, unsigned int flags);
Drei Details werden häufig falsch wiedergegeben:
SPLICE_F_MOVEbewirkt bei modernen Kernel nichts. Laut Man-Page war die ursprüngliche Implementierung fehlerhaft, daher wird das Flag seit Linux 2.6.21 akzeptiert, hat aber keine Wirkung. Verlassen Sie sich nicht auf das Page-Moving-Verhalten.SPLICE_F_NONBLOCKmacht die Pipe-Seite der Operation nicht-blockierend. Der Aufruf kann trotzdem blockieren, wenn der andere Deskriptor ein blockierender Socket ist. Setzen Sie daherO_NONBLOCKauf die Sockets.SPLICE_F_MOREdeutet an, dass in einem späterensplice()mehr Daten folgen, was bei der Pipe-zu-Socket-Route nützlich ist.
„Kein Kopieren in den User-Space“ ist nicht dasselbe wie „Null-Kopien überall“. Die Man-Page verspricht nur ersteres.
Wo vmsplice() passt (und wo nicht)
vmsplice(2) verbindet User-Speicher mit einer Pipe. Wenn die Pipe zum Schreiben offen ist, mappt sie Ihre Speicherbereiche in die Pipe. Beim Lesen kopiert sie tatsächlich Daten in Ihre Puffer. Das macht vmsplice relevant, wenn Ihr eigener Code Daten erzeugt (z.B. einen vorgefertigten Frame), nicht für Socket-zu-Socket-Forwarding, bei dem nichts den User-Space berührt.
Der Nachteil ist, dass die Pipe Ihre Seiten mappt, anstatt sie zu kopieren. Sie dürfen den Speicher erst modifizieren, wenn das Kernel ihn verbraucht hat. SPLICE_F_GIFT geht noch einen Schritt weiter und erklärt die Seiten für gut, sodass die Anwendung sie nur noch lesen darf. Es erfordert außerdem seitenbündige Adressen und Längen.
Wann splice hilft, und wann nicht
Splice ist nur sinnvoll, wenn der Tunnel Bytes weiterleitet, die nicht gelesen oder transformiert werden müssen:
- Reines TCP-zu-TCP-Forwarding (ein TCP-Tunnel, der einen undurchsichtigen Stream trägt, oder ein TLS-Pass-Through-Pfad): splice passt.
- TLS im User-Space beendet, oder QUIC: Die Anwendung muss Klartext sehen, um zu verschlüsseln oder zu entschlüsseln, daher kann splice nicht helfen. Das Kernel-TLS-Offload (kTLS) kann diese Lücke bei TCP verringern: Die Dokumentation beschreibt
sendfile-Support auf dem Sendepfad, sodass Klartext ohne User-Space-Kopie an einen TLS-Socket gelangen kann. - QUIC und andere UDP-Protokolle können kein splice verwenden. Hier helfen Batching-Methoden. Googles QUICHE-Bibliothek nutzt UDP GSO (
UDP_SEGMENT), sodass einsendmsgmehrere Segmente tragen kann, undsendmmsgbatching, um mehrere Pakete in einem Aufruf zu senden (QUICHE-Quelle). - io_uring bietet ebenfalls splice über
io_uring_prep_splice(3), was nützlich ist, wenn Sie bereits auf einer completion-basierten Schleife aufbauen.
Go: zuerst die Standardbibliothek verwenden, nur bei Bedarf selbst bauen
Go’s net-Paket splicet bereits unter Linux. Wenn ein *net.TCPConn die Quelle eines io.Copy in eine andere TCP-Verbindung ist, nutzt die Laufzeit intern einen splice-Pfad und fällt auf eine normale Kopie zurück, wenn das nicht anwendbar ist (net/splice_linux.go). Für die meisten Proxies ist io.Copy(dst, src) zwischen zwei *net.TCPConn-Werten die richtige Lösung.
Eine selbst geschriebene Version lohnt sich nur, wenn Sie Kontrolle über Dinge brauchen, die die Standardbibliothek nicht bietet, z.B. Pipe-Größe, Chunk-Größe oder per-Connection-Abrechnung. Die unten stehende Version integriert sich mit Go’s netpoller über syscall.RawConn, sodass ein would-block die Goroutine parket statt zu spinnen:
//go:build linux

package main

import (
	"errors"
	"fmt"
	"net"

	"golang.org/x/sys/unix"
)

// SplicePipe ist eine Kernel-Pipe, die als Puffer zwischen zwei Sockets dient.
type SplicePipe struct{ r, w int }

// NewSplicePipe erstellt eine nicht-blockierende Pipe und setzt ihre Größe. Unprivilegierte
// Prozesse sind durch /proc/sys/fs/pipe-max-size (standard 1 MiB) begrenzt.
func NewSplicePipe(size int) (*SplicePipe, error) {
	var fds [2]int
	if err := unix.Pipe2(fds[:], unix.O_CLOEXEC|unix.O_NONBLOCK); err != nil {
		return nil, fmt.Errorf("pipe2: %w", err)
	}
	if _, err := unix.FcntlInt(uintptr(fds[0]), unix.F_SETPIPE_SZ, size); err != nil {
		unix.Close(fds[0])
		unix.Close(fds[1])
		return nil, fmt.Errorf("F_SETPIPE_SZ(%d): %w", size, err)
	}
	return &SplicePipe{r: fds[0], w: fds[1]}, nil
}

func (p *SplicePipe) Close() { unix.Close(p.r); unix.Close(p.w) }

// Copy verschiebt Bytes von src nach dst, bis src EOF erreicht.
func (p *SplicePipe) Copy(dst, src *net.TCPConn, chunk int) (int64, error) {
	srcRC, err := src.SyscallConn()
	if err != nil {
		return 0, err
	}
	dstRC, err := dst.SyscallConn()
	if err != nil {
		return 0, err
	}

	var total int64
	for {
		// Phase 1: socket -3e pipe.
		var n int64
		var serr error
		rerr := srcRC.Read(func(fd uintptr) bool {
			for {
				n, serr = unix.Splice(int(fd), nil, p.w, nil, chunk, unix.SPLICE_F_NONBLOCK)
				if serr != unix.EINTR {
					break
				}
			}
			// false =3e Laufzeit wartet, bis der Socket lesbar ist, dann wiederholt
			return !errors.Is(serr, unix.EAGAIN)
		})
		if rerr != nil {
			return total, rerr
		}
		if serr != nil {
			return total, fmt.Errorf("splice socket-3e pipe: %w", serr)
		}
		if n == 0 {
			return total, nil // EOF
		}

		// Phase 2: pipe -3e socket. Alles abarbeiten, was gerade gestaged wurde.
		for left := n; left > 0; {
			var w int64
			werr := dstRC.Write(func(fd uintptr) bool {
				for {
					w, serr = unix.Splice(p.r, nil, int(fd), nil, int(left),
						unix.SPLICE_F_NONBLOCK|unix.SPLICE_F_MORE)
					if serr != unix.EINTR {
						break
					}
				}
				return !errors.Is(serr, unix.EAGAIN)
			})
			if werr != nil {
				return total, werr
			}
			if serr != nil {
				return total, fmt.Errorf("splice pipe-3e socket: %w", serr)
			}
			left -= w
			total += w
		}
	}
}
Verwenden Sie eine Pipe pro Richtung pro Verbindung. Wenn Copy zurückkehrt, rufen Sie dst.CloseWrite() auf, damit EOF als Halboffene Verbindung weitergegeben wird. Ein 64 MiB zufälliger Payload, der durch eine zweistufige Loopback-echo läuft, kam Byte für Byte identisch zurück.
Rust: splice innerhalb einer Tokio-Event-Schleife
In Rust umschließt die nix-Crate splice, aber deren splice und SpliceFFlags sind hinter dem zerocopy-Cargo-Feature versteckt (der unten stehende Code wurde gegen nix 0.30 gebaut). Tokio’s TcpStream::async_io ist der saubere Weg, um einen Raw- syscall unter seiner Bereitschaftsüberwachung auszuführen: Wenn die Closure WouldBlock zurückgibt, setzt Tokio die Bereitschaft zurück und wartet erneut.
[dependencies]
nix   = { version = "0.30", features = ["fs", "zerocopy"] }
tokio = { version = "1", features = ["rt-multi-thread", "net", "macros", "io-util"] }
use std::io;
use std::os::fd::OwnedFd;

use nix::fcntl::{fcntl, splice, FcntlArg, OFlag, SpliceFFlags};
use nix::unistd::pipe2;
use tokio::io::Interest;
use tokio::net::TcpStream;

/// Eine Kernel-Pipe, die als Puffer zwischen zwei Sockets dient.
pub struct SplicePipe {
    r: OwnedFd,
    w: OwnedFd,
}

impl SplicePipe {
    pub fn new(size: i32) -> io::Result<Self> {
        let (r, w) = pipe2(OFlag::O_CLOEXEC | OFlag::O_NONBLOCK)?;
        fcntl(&w, FcntlArg::F_SETPIPE_SZ(size))?;
        Ok(Self { r, w })
    }

    /// Verschiebt Bytes von `src` nach `dst` bis `src` EOF erreicht.
    pub async fn forward(&self, src: &TcpStream, dst: &TcpStream, chunk: usize) -> io::Result<u64> {
        let mut total = 0u64;
        loop {
            // socket -3e pipe (EAGAIN wird zu WouldBlock, daher wartet Tokio)
            let n = src
                .async_io(Interest::READABLE, || {
                    splice(src, None, &self.w, None, chunk, SpliceFFlags::SPLICE_F_NONBLOCK)
                        .map_err(io::Error::from)
                })
                .await?;
            if n == 0 {
                return Ok(total); // EOF
            }

            // pipe -3e socket: alles abarbeiten, was gerade gestaged wurde
            let mut left = n;
            while left > 0 {
                let w = dst
                    .async_io(Interest::WRITABLE, || {
                        splice(
                            &self.r,
                            None,
                            dst,
                            None,
                            left,
                            SpliceFFlags::SPLICE_F_NONBLOCK | SpliceFFlags::SPLICE_F_MORE,
                        )
                        .map_err(io::Error::from)
                    })
                    .await?;
                left -= w;
                total += w as u64;
            }
        }
    }
}
Wickeln Sie jeden TcpStream in einen Arc, sodass eine Aufgabe in jede Richtung weiterleiten kann, und schalten Sie die Schreibseite des Ziels ab, wenn eine Richtung endet. Der gleiche 64 MiB Loopback-Echo-Test funktionierte mit diesem Code.
Praktische Hinweise
- Messen Sie mit Ihrer Arbeitslast. Splice entfernt das Kopieren im User-Space und das Paar Systemaufrufe pro Chunk, aber es fügt Pipe-Management und (bei diesem Design) einen zweiten Systemaufruf pro Chunk hinzu. Kleine Nachrichten oder stark transformierte Streams profitieren möglicherweise nicht.
- Die Standard-Pipe-Kapazität ist 64 KiB. Erhöhen Sie sie mit
F_SETPIPE_SZfür einen Durchsatzregler, begrenzt durch/proc/sys/fs/pipe-max-size. - Linux-spezifisch: splice ist Linux-spezifisch. Für andere Plattformen halten Sie eine portable Fallback-Lösung (
io.Copy,tokio::io::copy) bereit.
Teil 2: NAT- und CGNAT-Traversal
Warum Carrier-Grade NAT anders ist
Die meisten Heimrouter führen eine NAT-Schicht durch. Bei CGNAT fügt der ISP eine zweite Schicht hinzu. RFC 6598 (BCP 153) reserviert 100.64.0.0/10 als Shared Address Space für Dienstanbieter, um die Links zwischen ihren CGN-Geräten und Kundengeräten zu nummerieren. Wenn die WAN-Adresse Ihres Routers in diesem Bereich liegt, sind Sie fast sicher hinter CGNAT.
[ CGNAT: zwei NATs in Serie ]
Laptop (192.168.1.50)
  └─3e Heimrouter NAT   WAN-Adresse: 100.64.10.15   (RFC 6598 Shared Space)
        └─3e ISP CGNAT   öffentliche Adresse: 198.51.100.1:45210 (Dokumentationsadresse)
              └─3e Internet
(Die Adressen 198.51.100.x und 203.0.113.x in diesem Artikel sind reservierte Dokumentationsadressen, keine echten Hosts.)
NAT-Verhalten: Zwei unabhängige Eigenschaften
Das ältere Vokabular „full cone / restricted cone / port-restricted cone / symmetric“ stammt aus der frühen STUN-Ära. Moderne Erklärungen, wie Tailscale, beschreiben NAT-Verhalten mit zwei Eigenschaften, die für Traversal relevant sind, und behandeln die genannten Kategorien als grobe Zuordnung:
- Mapping: hängt der externe Port vom Ziel ab? Wenn nicht, ist das NAT „einfach“; wenn ja, ist es „schwierig“.
- Inbound-Filtering: welche entfernten Adressen dürfen Pakete durch eine Zuordnung zurücksenden?
| Älterer Name | Mapping | Inbound-Filtering | Direkte UDP-Traversal |
|---|---|---|---|
| Full cone | Gleicher externer Port für alle Ziele | Jeder entfernte Host | Einfach |
| Address-restricted cone | Gleicher externer Port für alle Ziele | Nur IPs, an die der Host bereits gesendet hat | Einfach, wenn beide Seiten zuerst senden |
| Port-restricted cone | Gleicher externer Port für alle Ziele | Nur IP:Port-Paare, an die der Host bereits gesendet hat | Einfach, wenn beide Seiten zuerst senden |
| Symmetrisch | Neuer externer Port pro Ziel | Nur die exakt kontaktierten IP:Port | Schwierig |
Für direkte Pfade benötigen Sie mindestens einen „einfachen“ NAT auf einer Seite. Heimrouter sind tendenziell einfache NATs, während harte NATs eher in Büro-Routern und Cloud-NAT-Gateways vorkommen.
STUN, Rendezvous und Hole Punching
RFC 8489 (ersetzt RFC 5389, Februar 2020) definiert STUN als Hilfsmittel: Ein Endpunkt kann damit die öffentliche Adresse und den Port ermitteln, die sein NAT zugewiesen hat, um Konnektivität zu prüfen und NAT-Zuordnungen aktiv zu halten. Das RFC ist explizit, dass STUN kein Peer-Address-Austausch ist. Ein separates Rendezvous- (Signalisierungs-)Kanal, meist die Steuerungsebene im Tunnelprodukt, überträgt die beobachteten öffentlichen Endpunkte.
- Beide Endpunkte senden STUN-Binding-Anfragen und ermitteln ihre öffentlichen
ip:port(z.B.198.51.100.1:10050und203.0.113.8:20080). - Jeder meldet seinen Endpunkt an den Rendezvous-Dienst, der die Endpunkte der anderen Seite übergibt.
- Beide senden UDP-Pakete an die öffentliche Adresse des anderen, ungefähr gleichzeitig. Jedes ausgehende Paket erzeugt NAT-Zustand, der die Pakete der anderen Seite durchlässt. Das erste Paket in eine Richtung kann verloren gehen, was erwartet wird.
- Sobald Pakete fließen, senden Sie regelmäßig Keepalives, damit die Zuordnungen nicht ablaufen.
[ UDP Hole Punching ]
Client A            STUN-Server     Rendezvous-Dienst        Client B
|--- Binding-Anfrage ----3e|                 |                      |
|3c-- A_pub=198.51.100.1:10050           |3c--- Binding-Anfrage -----|
|                     |                 |    B_pub=203.0.113.8:20080
|--- Registrierung A_pub -------------------3e|3c--- Registrierung B_pub -|
|3c-- B_pub ---------------------------|--- A_pub -----------3e|
|                                                              |
|=== Punch A -3e B (kann vom NAT von B fallen gelassen werden) =======>
|3c============= Punch B -3e A (NAT von A hat jetzt Zustand) =======|
|3c================== direkter UDP-Pfad ========================>|
Harte NATs: Der Birthday-Paradox-Trick, mit echten Zahlen
Wenn eine Seite ein hartes NAT hat und die andere ein einfaches, weiß die einfache Seite nicht, auf welchen Port sie senden soll. Tailscale zeigt, wie das Birthday-Paradox hilft: Die harte Seite öffnet viele Sockets (z.B. 256), jeder erhält einen zufälligen externen Port, während die einfache Seite zufällig Destination-Ports probiert. Die Zahlen im Beitrag: Bei 256 offenen Ports auf der harten Seite ergeben ca. 174 zufällige Probes etwa 50% Chance auf eine Übereinstimmung, 256 Probes 64%, 1024 98%, und 2048 99,9%. Bei beiden harten Seiten wird der Suchraum zu Paaren von Ports, und die Chancen sinken drastisch. Erfolg nach 20 Sekunden bei den gleichen Raten liegt bei etwa 0,01%, um 99,9% zu erreichen, braucht es rund 170.000 Probes pro Seite (ca. 28 Minuten bei 100 Paketen pro Sekunde). Der Autor warnt auch, dass aggressives Probing die Session-Tabelle kleiner NAT-Geräte erschöpfen kann.
Die praktische Schlussfolgerung: Pfade zwischen zwei harten NATs benötigen meist einen Relay.
Port-Mapping-Protokolle: nützlich, aber nur beim nächsten NAT
UPnP IGD, NAT-PMP und PCP erlauben es einem Host, sein Gateway zu bitten, einen Port weiterzuleiten. Sie verwenden ein Anfrage-/Antwortmuster: Fordere das Gateway auf, einen WAN-Port auf eine LAN-Adresse weiterzuleiten, und erhalte die zugewiesene öffentliche Adresse und Port. Die wichtige Einschränkung ist, dass sie nur auf das NAT direkt beim Client wirken. Bei Doppel-NAT können sie das äußere NAT nicht erreichen und scheitern meist. Hinter CGNAT öffnet eine UPnP- oder NAT-PMP-Zuordnung auf dem Heimrouter nur einen Port auf der 100.64.x.x-WAN-Seite, was Sie nicht öffentlich erreichbar macht.
PCP (RFC 6887) ist der Nachfolger von NAT-PMP und unterstützt IPv4 und IPv6. Nützliche Features für Tunnel-Clients:
- Server hören auf UDP-Port 5351; Clients auf UDP 5350 für Multicast-ANNOUNCE.
- Der MAP-Befehl fordert eine eingehende Zuordnung an. Die vorgeschlagenen externe Adresse und Port sind Hinweise; der Server kann andere zuweisen.
- Die Option
PREFER_FAILUREsagt dem Server, keine alternative Zuordnung zu erstellen, wenn die vorgeschlagene nicht verfügbar ist. Bei Nicht-Erfüllung gibt erCANNOT_PROVIDE_EXTERNAL(Code 11) zurück. UNSUPP_VERSION(Code 1) bedeutet, der Server spricht die verwendete PCP-Version nicht.
Ob PCP ein CGN erreichen kann, hängt davon ab, ob der ISP einen PCP-Server für Kunden betreibt, was ein Client vorher nicht weiß. Betrachten Sie PCP als ersten, opportunistischen Versuch, nicht als garantierten Fallback.
PCP MAP-Anfrage (RFC 6887 Abschnitte 7.1 und 11.1)
Eine MAP-Anfrage ist 60 Byte lang: ein 24-Byte-Header plus ein 36-Byte-Body.
 0                   1                   2                   3
 0 1 2 3 4 5 6 7 8 9 0 1 2 3 4 5 6 7 8 9 0 1 2 3 4 5 6 7 8 9 0 1
+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+
|  Version = 2  |R|   Opcode=1  |           Reserved            |
+---------------+---------------+-------------------------------+
|                 Requested Lifetime (32 bits)                  |
+---------------------------------------------------------------+
|                                                               |
|             PCP Client's IP Address (128 bits)                |
|                                                               |
|                                                               |
+---------------------------------------------------------------+
|                                                               |
|                  Mapping Nonce (96 bits)                      |
|                                                               |
+---------------+-----------------------------------------------+
|   Protocol    |                Reserved (24 bits)             |
+-------------------------------+-------------------------------+
|        Internal Port          |    Suggested External Port    |
+-------------------------------+-------------------------------+
|                                                               |
|          Suggested External IP Address (128 bits)             |
|                                                               |
|                                                               |
+---------------------------------------------------------------+
IPv4-Adressen werden als IPv4-mapped IPv6 (::ffff:a.b.c.d) übertragen. In einer Antwort ist das „R“-Bit gesetzt, der Header enthält einen Ergebnis-Code und eine Epoche-Zeit, und der MAP-Body trägt die zugewiesene externe Adresse und Port anstelle der Vorschläge.
Go: ein PCP MAP-Client
package main

import (
	"bytes"
	"crypto/rand"
	"encoding/binary"
	"fmt"
	"net"
	"time"
)

const (
	pcpServerPort = 5351
	pcpVersion    = 2
	opMap         = 1
	protoUDP      = 17
	pcpReqLen     = 60 // 24-Byte-Header + 36-Byte-MAP-Body
)

// PCPMapping ist, was der PCP-Server gewährt hat.
type PCPMapping struct {
	ExternalIP   net.IP
	ExternalPort uint16
	Lifetime     time.Duration
}

// RequestMapping fordert den PCP-Server auf, UDP-Verkehr an `localIP:internalPort` weiterzuleiten (RFC 6887, MAP-Opcode).
func RequestMapping(gateway, localIP net.IP, internalPort uint16, lifetime uint32) (*PCPMapping, error) {
	// Binde an localIP: Der PCP-Client-IP-Feld muss mit der Quelladresse des Pakets übereinstimmen,
	// sonst lehnt der Server ab.
	conn, err := net.DialUDP("udp",
		&net.UDPAddr{IP: localIP},
		&net.UDPAddr{IP: gateway, Port: pcpServerPort})
	if err != nil {
		return nil, err
	}
	defer conn.Close()

	var nonce [12]byte
	if _, err := rand.Read(nonce[:]); err != nil {
		return nil, err
	}

	req := make([]byte, pcpReqLen)
	req[0] = pcpVersion // Version
	req[1] = opMap      // R-Bit = 0 (Anfrage), Opcode = 1
	binary.BigEndian.PutUint32(req[4:8], lifetime)
	copy(req[8:24], localIP.To16()) // Client-IP (IPv4-mapped bei IPv4)
	copy(req[24:36], nonce[:])      // Mapping-Nonce
	req[36] = protoUDP              // Bytes 37-39 reserviert
	binary.BigEndian.PutUint16(req[40:42], internalPort)
	binary.BigEndian.PutUint16(req[42:44], internalPort) // Vorgeschlagener externer Port (Hinweis)
// Bytes 44-59: Vorgeschlagene externe IP; zeros = keine Präferenz

	_ = conn.SetDeadline(time.Now().Add(3 * time.Second))
	if _, err := conn.Write(req); err != nil {
		return nil, err
	}
	resp := make([]byte, 1100) // PCP-Nachrichten maximal 1100 Bytes
	n, err := conn.Read(resp)
	if err != nil {
		return nil, fmt.Errorf("kein PCP-Antwort: %w", err)
	}
	return parseMapResponse(resp[:n], nonce)
}

func parseMapResponse(b []byte, nonce [12]byte) (*PCPMapping, error) {
	if len(b) < pcpReqLen {
		return nil, fmt.Errorf("zu kurze PCP-Antwort: %d Bytes", len(b))
	}
	if b[0] != pcpVersion {
		return nil, fmt.Errorf("unerwartete PCP-Version %d", b[0])
	}
	if b[1] != 0x80|opMap { // R-Bit gesetzt (Antwort) + MAP-Opcode
		return nil, fmt.Errorf("keine MAP-Antwort (Byte 1 = %#x)", b[1])
	}
	if code := b[3]; code != 0 {
		return nil, fmt.Errorf("PCP-Resultcode %d", code)
	}
	if !bytes.Equal(b[24:36], nonce[:]) {
		return nil, fmt.Errorf("Mapping-Nonce stimmt nicht überein")
	}
	return &PCPMapping{
		Lifetime:     time.Duration(binary.BigEndian.Uint32(b[4:8])) * time.Second,
		ExternalPort: binary.BigEndian.Uint16(b[42:44]),
		ExternalIP:   net.IP(append([]byte(nil), b[44:60]...)).To16(),
	}, nil
}
Der Client überprüft die Antwort-Version, das Antwort-Bit, den Ergebnis-Code und den Nonce, bevor er die zugewiesene Adresse vertraut. Er wurde gegen einen Mock-Server getestet, der entsprechend antwortet; gegen ein echtes CGNAT wurde es noch nicht eingesetzt. Aktualisieren Sie die Zuordnungen vor Ablauf der zugewiesenen Lebenszeit, und interpretieren Sie eine geänderte Epoche in einer späteren Antwort als Anzeichen, dass der Server den Zustand verloren hat.
Eine mehrschichtige Verbindungsstrategie
Ein realistischer Tunnel-Client probiert Pfade in der Reihenfolge ihrer Kosten, und hat immer einen Relay als letzte Option:
- Direkte IPv6-Verbindung, wenn beide Seiten sie haben.
- Port-Weiterleitung am nächsten Gateway (PCP, NAT-PMP, UPnP).
- STUN-unterstütztes Hole Punching, koordiniert über die Steuerungsebene.
- Birthday-Probing, wenn genau eine Seite ein hartes NAT ist.
- Ein Relay, wenn beide Seiten harte NATs sind oder alle vorherigen Schritte fehlschlagen.
Für einen gehosteten Tunnel-Service ist der Relay-Pfad Standard, alles andere ist eine Optimierung, um Relay-Kosten und Latenz zu verringern.
Teil 3: QUIC 0-RTT für Tunnel-Reconnects
Was das Handshake kostet
Eine frische TCP-Verbindung benötigt vor TLS einen Round-Trip, und TLS 1.3 braucht noch einen weiteren, bevor der Client Anwendungsdaten senden kann. QUIC kombiniert Transport- und Kryptohandshake, sodass eine neue Verbindung nur einen Round-Trip braucht. Mit Sitzungswiederaufnahme kann QUIC den Client in seinem ersten Flight Anwendungsdaten schicken lassen: 0-RTT.
[ Zeit bis zum ersten Request-Byte ]
TCP + TLS 1.3           QUIC (neu)              QUIC 0-RTT (wiederaufnahme)
SYN ------------3e       Initial -------3e        Initial + 0-RTT-Daten -3e
3c-- SYN-ACK         3c-- Handshake         3c-- Handshake abgeschlossen
ClientHello ----3e       Daten --------3e
3c-- ServerHello..Fin
Daten -----------3e
(2 Round-Trips)         (1 Round-Trip)          (0 Round-Trips)
RFC 8470 beschreibt den Vorteil der frühen Daten in HTTP, um die Round-Trip-Verzögerungen des TLS-Handshakes zu vermeiden, warnt aber auch vor dem Hauptrisiko: Ein Angreifer könnte die Anfrage(n) abfangen und wiederholen.
Wie Resumption in QUIC funktioniert
Laut RFC 9001 Abschnitt 4.6:
- Der Client muss TLS-Zustand, die QUIC-Transportparameter, das gewählte Anwendungsprotokoll und alle Anwendungsinformationen, die zum Aufbau von 0-RTT-Paketen benötigt werden, vom selben früheren Verbindungskontext behalten. TLS 1.3 begrenzt die Zeit zwischen diesen Verbindungen auf sieben Tage.
- Das Server-Session-Ticket kommt als
NewSessionTicket-Handshake-Nachricht in QUIC CRYPTO-Frames, nicht als separater QUIC-Frame. - Das Feld
max_early_data_sizedient nur als Signal: QUIC-Server müssen0xffffffffsenden, und ein Client behandelt jeden anderen Wert als Protokollverletzung. Die Menge an 0-RTT-Daten wird durch deninitial_max_data-Transportparameter des Servers bestimmt. (Es ist kein 16-64 KB-Wert, der im Ticket ausgehandelt wird.) - Ein Server akzeptiert, indem er
early_datainEncryptedExtensionseinschließt; er lehnt ab, indem er es weglässt. Nach einer Ablehnung muss der Client den Zustand aller Streams, die 0-RTT verwendet haben, zurücksetzen, inklusive Anwendungszustand. - Anwendungen, die QUIC verwenden, müssen ein Profil für 0-RTT definieren. Ohne eines kann 0-RTT nur QUIC-Frames übertragen, die keine Anwendungsdaten enthalten. Clients dürfen keine Anwendungsdaten in 0-RTT senden, außer die Anwendung verlangt es.
Was 0-RTT nicht bietet
RFC 8446 Abschnitt 2.3 beschreibt die schwächeren Garantien von 0-RTT-Daten:
- Es ist nicht forward secret, da es nur durch Schlüssel geschützt ist, die aus dem pre-shared key abgeleitet wurden.
- Es gibt keinen Replay-Schutz über Verbindungen hinweg, weil 0-RTT-Daten nicht vom zufälligen Wert des Servers abhängen. Innerhalb einer Verbindung kann es nicht dupliziert werden.
Replay-Abwehrmaßnahmen, Schicht für Schicht
Transport- und TLS-Schicht. TLS 1.3 beschreibt in Abschnitt 8 drei serverseitige Techniken: Einmalige Tickets, Aufzeichnung von ClientHello-Nachrichten und Frische-Checks (Vergleich des obfuskierten Ticket-Alters des Clients mit der eigenen Zeitmessung). Jede handelt mit Zustand oder Zeittoleranz, eliminiert Replay aber nicht vollständig: Sie reduzieren es und begrenzen die Anzahl der Replays. Bei Multi-Server-Deployments benötigen Einmal-Tickets und ClientHello-Aufzeichnungen gemeinsamen Zustand.
QUIC-Schicht. RFC 9001 Abschnitt 9.2 sagt, dass der Transportzustand von QUIC durch Replay nicht beeinträchtigt wird, da Frame-Verarbeitung idempotent ist. Replay betrifft jedoch, was die Anwendung mit den Daten macht. Es weist darauf hin, dass Session-Tickets und Adressvalidierungstoken keine Anwendungsspezifika tragen dürfen, und dass ein Server, der 0-RTT akzeptiert, zusätzlichen Verarbeitungsaufwand hat. Das Deaktivieren von 0-RTT ist die effektivste Abwehr.
HTTP-Schicht. RFC 8470 bietet HTTP-Tools:
- Ein Zwischenschritt, der eine Anfrage in Early Data erhält, markiert sie mit
Early-Data: 1beim Weiterleiten. - Eine Origin, die das Replay-Risiko zu groß einschätzt, antwortet mit
425 Too Early. - Clients, die Early Data verwenden, müssen eine Anfrage mit 425 wiederholen. Zwischenschritte müssen 425 für Anfragen mit
Early-Data-Header weiterleiten. - Wenn die Verarbeitung einer Anfrage keine zustandsverändernden Nebenwirkungen hat, sind die Folgen eines Replays meist unbedeutend.
Cloudflares Ansatz ist eine nützliche Referenz: Ihr 0-RTT-Support umfasst GET-, HEAD- und OPTIONS-Anfragen, nicht POST, fügt einen Early-Data: 1-Header hinzu, damit Ursprünge Early Requests erkennen, und weist darauf hin, dass 0-RTT-Anfragen wiederholt werden können. Sie sollten das Risiko bewerten, ob es Ihren Anforderungen entspricht.
Serverseitiger Entscheidungsfluss
Eingehende ClientHello mit PSK + 0-RTT-Daten
        |
        v
Gültiges, nicht abgelaufenes Ticket? ----- nein ---3e Ablehnen von 0-RTT, normale 1-RTT-Handshake durchführen
        | ja
        v
Replay-Check (Einmal-Ticket-Store, ClientHello-Record, oder Alter)
        | bestanden                       \ fehlgeschlagen
        v                               ---3e Ablehnen von 0-RTT, normale 1-RTT-Handshake durchführen
Akzeptiere early_data in EncryptedExtensions
        |
        v
Pro-Request-Policy auf Anwendungsebene / HTTP
   sichere Methode (GET, HEAD, OPTIONS)  -----3e sofort verarbeiten
   alles zustandsverändernde           -----3e 425 Too Early, Client wiederholt nach Handshake
Go-Middleware für 425 Too Early
Wenn Ihr Relay Early-Data-Anfragen mit Early-Data: 1 weiterleitet, kann die Anwendung dahinter zustandsverändernde Methoden ablehnen:
package main

import "net/http"

// rejectUnsafeEarlyData antwortet mit 425 Too Early (RFC 8470), wenn eine
// vom Relay empfangene Early-Data-Anfrage eine zustandsverändernde Methode hat.
func rejectUnsafeEarlyData(next http.Handler) http.Handler {
	return http.HandlerFunc(func(w http.ResponseWriter, r *http.Request) {
		if r.Header.Get("Early-Data") == "1" && !isSafeMethod(r.Method) {
			w.Header().Set("Retry-After", "0")
			http.Error(w, "Wiederholen nach Abschluss des Handshakes", http.StatusTooEarly)
			return
		}
		next.ServeHTTP(w, r)
	})
}

func isSafeMethod(m string) bool {
	switch m {
	case http.MethodGet, http.MethodHead, http.MethodOptions:
		return true
	}
	return false
}
Ein tabellarischer Test, der GET, HEAD, POST und PUT mit und ohne Header abdeckt, besteht. Die Allow-Liste ist bewusst auf sichere Methoden beschränkt, nicht nur auf idempotente: Ein PUT kann idempotent sein, aber trotzdem unsicher bei Replay (z.B. Wiederholung eines alten Schreibens nach einem neueren).
Wo 0-RTT in einem Tunnel wirklich hilft
0-RTT gilt für die Verbindung, die wiederaufgenommen wird, was klärt, wo es sich lohnt:
- Agent-zu-Relay-Reconnects. Ein Tunnel-Agent, der nach Schlaf oder Netzwerkwechsel wiederaufnimmt, kann seine Session ohne vollständigen Handshake wiederherstellen. Alles, was in 0-RTT geht, sind idempotente Steuer-Frames („Session X wieder aufnehmen“). Alles Zustandsverändernde, z.B. eine neue Route registrieren oder Credentials rotieren, sollte erst nach Abschluss des Handshakes erfolgen.
- Öffentliche Clients am Edge über HTTP/3. Anwenden Sie die oben genannten HTTP-Regeln. Webhook-Lieferungen sind meist POST, was Cloudflares 0-RTT-Ansatz ausschließt.
- Kein Freifahrtschein für Adressen. Cloudflare weist darauf hin, dass bei QUIC 0-RTT-Anfragen vor der Validierung der Quelladresse verarbeitet werden können. RFC 9001 Abschnitt 9.3 beschreibt das verwandte Amplification-Risiko: Server begrenzen, was sie senden, auf das Dreifache der empfangenen Bytes, bis die Adresse verifiziert ist.
Verbindungsmigration ist eine ergänzende Funktion. QUIC identifiziert Verbindungen anhand von Connection-IDs, nicht anhand des 4-Tupels. Ein Client, dessen NAT-Bindung oder IP-Adresse sich ändert, kann die gleiche Verbindung nach Pfad-Validierung fortsetzen, ohne einen neuen Handshake (RFC 9000, Abschnitt 9).
Standard-Bausteine für UDP und IP über HTTP/3
Wenn Ihr Tunnel UDP- oder IP-Pakete trägt, müssen Sie kein eigenes Framing entwickeln. RFC 9298 definiert Proxying von UDP in HTTP, RFC 9484 Proxying von IP in HTTP (Oktober 2023), beide bauen auf QUIC’s unzuverlässiger Datagram-Erweiterung (RFC 9221) auf. Die Verwendung der Standard-Formate ermöglicht, dass off-the-shelf HTTP/3-Stacks und Middleboxes Ihren Traffic verstehen.
Deployment-Checkliste
- Standardmäßig 0-RTT deaktiviert, nur für benannte, idempotente Steueroperationen aktivieren.
- Verwenden Sie Einmal-Tickets oder einen ClientHello-Record, um Zustand zu teilen; bei Nicht-Möglichkeit Frische-Checks anwenden.
- Markieren Sie weitergeleitete Early-Data-Anfragen mit
Early-Data: 1und respektieren Sie425end-to-end. - Speichern Sie keine Anmeldedaten, Zahlungen oder zustandsverändernde Aktionen in 0-RTT.
- Rotieren Sie Ticket-Verschlüsselungsschlüssel regelmäßig und setzen Sie die Ticket-Laufzeit deutlich unter die sieben Tage von TLS 1.3.
- Planen Sie einen TCP/TLS-Fallback für Netzwerke, die UDP filtern.
Quellen
- splice(2), Linux man-pages
- vmsplice(2)
- Go
net/splice_linux.go - Linux Kernel TLS-Dokumentation
- QUICHE Linux Socket Utilities (UDP GSO, sendmmsg)
- RFC 6598: IANA-reservierter IPv4-Präfix für Shared Address Space
- RFC 8489: Session Traversal Utilities for NAT (STUN)
- Wie NAT-Traversal funktioniert (Tailscale, via APNIC)
- RFC 6887: Port Control Protocol und IANA PCP-Parameter
- RFC 8446: TLS 1.3
- RFC 9001: Verwendung von TLS zur Sicherung von QUIC
- RFC 8470: Verwendung von Early Data in HTTP
- RFC 9298: Proxying UDP in HTTP und RFC 9484: Proxying IP in HTTP
- Cloudflare: 0-RTT-Verbindungserneuerung
Related InstaTunnel pages
Continue from this article into the most relevant product guides and workflows.
Related Topics
Keep building with InstaTunnel
Read the docs for implementation details or compare plans before you ship.