Arquitectura de Sistemas AI en Producción: Depuración de LLMs Locales y Infraestructura de Enjambre Desacoplada
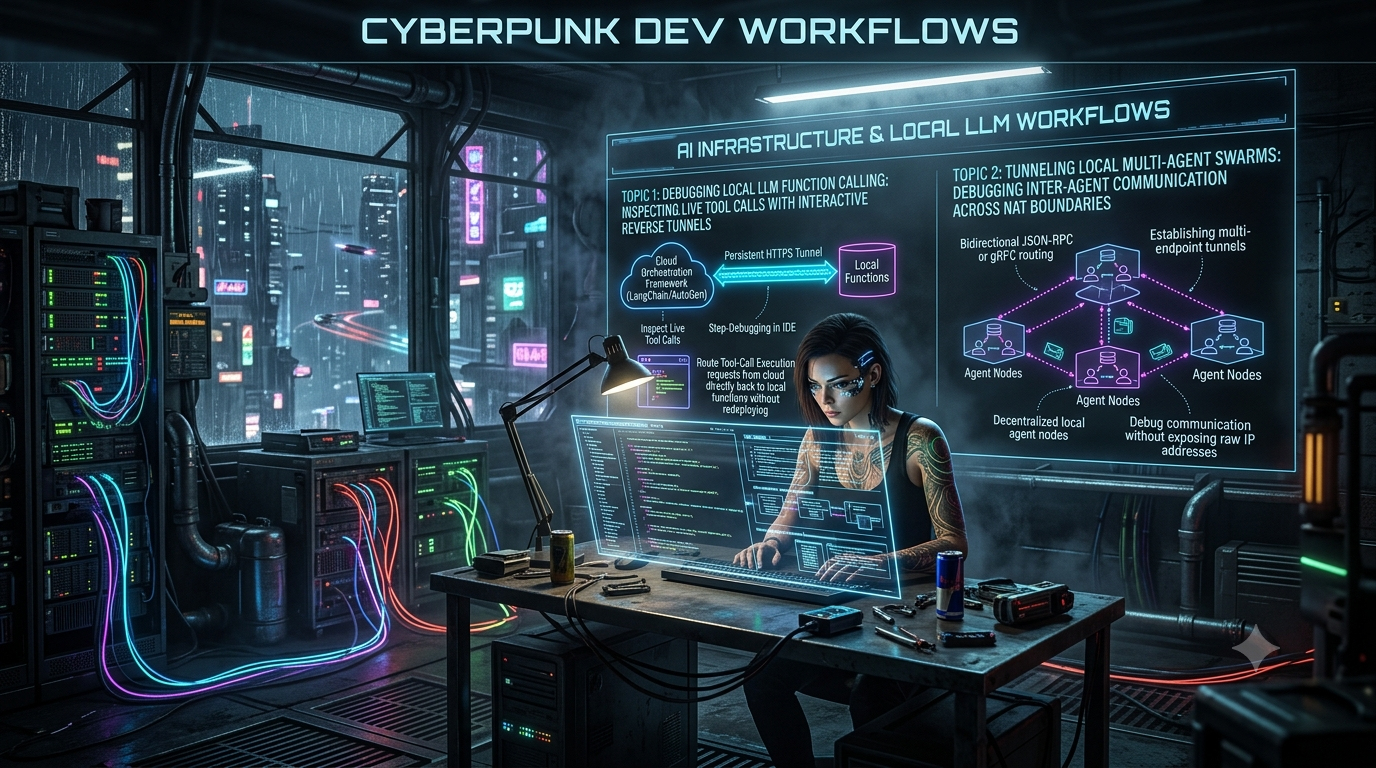
Dirige llamadas de herramientas en la nube a tu IDE local mediante túneles reversos. Depura funciones de LangChain y AutoGen en vivo sin redeployar. ### Tema 2: Túneles en Enjambres Multi-Agente Locales
Quick answer
### Tema 1: Depuración de Llamadas a Funciones LLM Locales: localhost tunnel answer
A localhost tunnel gives your local app a public HTTPS URL without opening router ports, which is useful for demos, QA, mobile testing, and provider callbacks.
How do I expose localhost without opening ports?
Use a reverse HTTPS tunnel. Your machine connects outbound to the tunnel service, and the public URL forwards requests back to your local app.
When should I use a localhost tunnel?
Use one for webhook testing, OAuth callbacks, client demos, QA previews, mobile device checks, and short-lived development reviews.
La rápida evolución de las orquestaciones de LLM — desde simples completaciones con un solo prompt hasta complejos enjambres multi-agente — ha superado los patrones tradicionales de depuración y redes. Desarrollar sistemas autónomos de IA localmente introduce fricciones específicas en la infraestructura: gestionar contextos de ejecución en la nube cerrados, manejar sincronización asíncrona de estado y navegar límites NAT/firewall locales.
Esta guía operacional ofrece dos patrones de ingeniería en profundidad diseñados para resolver estos desafíos:
- Túnel Inverso Interactivo para Depuración en Tiempo Real de Llamadas a Funciones de LLM
- Orquestación Descentralizada gRPC / JSON-RPC para Enjambres Multi-Agente a través de Fronteras de Red
Tema 1: Depuración de Llamadas a Funciones LLM Locales: Inspección en Vivo de Llamadas a Herramientas con Túneles Reversos Interactivos
El Problema de Arquitectura: La Brecha entre la Nube y la Herramienta Local
Al construir aplicaciones agenticas con Modelos de Lenguaje Grandes (por ejemplo, OpenAI GPT-4o, Anthropic Claude 3.5 Sonnet, o instancias hospedadas de DeepSeek) mediante capas de orquestación como LangChain, LlamaIndex o AutoGen, las llamadas a herramientas (llamadas a funciones) se ejecutan en un ciclo desacoplado de dos pasos:
- Fase de Inferencia: El cliente envía el contexto del prompt y definiciones de herramientas en JSON Schema al LLM en la nube.
- Fase de Ejecución: El LLM en la nube emite una carga útil estructurada
tool_callscon firmas de funciones y argumentos analizados. El cliente de orquestación recibe esta carga y debe ejecutar la función objetivo antes de enviar el resultado de vuelta al LLM.┌─────────────────┐ 1. Prompt + Esquema de Herramienta ┌─────────────────┐ │ │ ────────────────────────────────── │ │ │ API del LLM en la Nube │ │ App / Orquestador Local │ │ (Modelo Hospedado) │ ────────────────────────────────── │ │ │ 2. Salida: JSON de tool_calls └────────┬────────┘ └─────────────────┘ │ │ 3. Ejecución Local ▼ ┌─────────────────┐ │ Función Local │ │ (Depurador IDE)│ └─────────────────┘
Dónde Ocurre la Fricción en el Desarrollo
Cuando se externaliza la ejecución de herramientas a webhooks externos, sandbox en la nube o nodos remotos, los desarrolladores enfrentan fricciones severas:
- Desajustes Silenciosos en el Esquema: El LLM genera argumentos que fallan en validación Pydantic localmente, abortando sin logs detallados en tiempo de ejecución.
- Ejecución Opaca: Debugging con impresión o logs en consola estáticos ocultan mutaciones exactas de parámetros, actualizaciones de estado y latencia de red durante la ejecución.
- Latencia en Redeploy: Cambios en el código de herramientas locales requieren construcciones continuas de contenedores o despliegues sin servidor solo para probar un parámetro de borde.
Arquitectura de Túnel Inverso para Ejecución en Vivo de Herramientas
En lugar de desplegar código local en entornos de staging para recibir ejecuciones entrantes de webhook, los desarrolladores pueden exponer su entorno de ejecución local a Internet usando Túneles TLS Persistentes (herramientas como ngrok, Cloudflare Tunnels o devtunnel).
Al enrutar las llamadas de retorno de ejecución de orquestación externa a través de un túnel cifrado directamente a un servidor de desarrollo local en localhost, los desarrolladores pueden poner puntos de interrupción en IDEs de Python o TypeScript (VS Code / PyCharm) y examinar los marcos de pila en vivo mientras el LLM activa herramientas en tiempo real.
┌────────────────────────────────────────────────────────────────────────┐
│ INTERNET PÚBLICO / NUBE                                                  │
│                                                                        │
│   ┌────────────────────────┐            ┌──────────────────────────┐   │
│   │ Orquestación en la Nube /│            │ Gateway de Túnel Reverso  │   │
│   │ Trabajador Remoto       │            │ (p.ej., ngrok / Cloudflare)│   │
│   └───────────┬────────────┘            └────────────▲─────────────┘   │
└───────────────│──────────────────────────────────────│─────────────────┘
                │ Solicitud HTTP Webhook               │
                │ https://agent-dev.ngrok.app/execute  │ Túnel TLS Persistente
                └──────────────────────────────────────┼─
                                                       │
┌──────────────────────────────────────────────────────│─────────────────┐
│ ENTORNO DE DESARROLLO LOCAL                        │                 │
│                                                      │                 │
│   ┌────────────────────────┐            ┌────────────┴─────────────┐   │
│   │ Depurador IDE Local     │ ◄───────── │ Cliente Túnel (daemon)  │   │
│   │ (Puntos de Interrupción y Estado) │ Localhost │ (localhost:8000)          │   │
│   └────────────────────────┘            └──────────────────────────┘   │
└────────────────────────────────────────────────────────────────────────┘
Configuración Paso a Paso
Paso 1: Configurar el Túnel TLS Persistente
Iniciar un túnel reverso seguro apuntando al puerto del servidor de herramientas local (ej., 8000).
# Usando ngrok para abrir un túnel HTTP persistente con preservación del encabezado del host
ngrok http 8000 --domain=agent-dev-environment.ngrok.app

# Alternativamente usando CLI de devtunnel de Microsoft
devtunnel host -p 8000 --allow-anonymous
Paso 2: Implementar el Servidor de Herramientas con Capacidades de Puntos de Interrupción
A continuación, una implementación completa en FastAPI que expone una interfaz de herramientas extensible diseñada para ejecutar funciones locales solicitadas por un modelo orquestado en la nube.
# tool_server.py
import uvicorn
from fastapi import FastAPI, HTTPException, Request
from pydantic import BaseModel, Field
from typing import Any, Dict

app = FastAPI(title="Puente de Depuración de Herramientas Locales")

# Esquema de carga útil de ejemplo para herramientas
class ToolExecutionRequest(BaseModel):
    call_id: str
    tool_name: str
    arguments: Dict[str, Any]

class ToolExecutionResponse(BaseModel):
    call_id: str
    status: str
    result: Any

# Función de lógica de negocio de ejemplo para depuración
def calculate_database_query(query: str, limit: int) -> dict:
    # 🔴 PONER PUNTO DE INTERROGACIÓN AQUÍ
    # Inspeccionar 'query' y 'limit' en vivo desde el LLM
    processed_query = query.strip().lower()

    if limit > 100:
        # Detectar argumentos de LLM que generan alucinaciones
        limit = 100

    return {
        "status": "success",
        "rows_returned": limit,
        "executed_query": processed_query
    }

REGISTERED_TOOLS = {
    "calculate_database_query": calculate_database_query
}

@app.post("/execute-tool", response_model=ToolExecutionResponse)
async def handle_tool_call(payload: ToolExecutionRequest):
    """
    Endpoint webhook invocado por el orquestador en la nube vía Túnel Reverso.
    """
    print(f"\n[LLAMADA DE HERRAMIENTA ENTRANTE] ID: {payload.call_id} | Herramienta: {payload.tool_name}")
    print(f"[ARGUMENTOS]: {payload.arguments}")

    if payload.tool_name not in REGISTERED_TOOLS:
        raise HTTPException(status_code=404, detail=f"Herramienta '{payload.tool_name}' no registrada localmente.")

    # Invocación directa permite depuración paso a paso en IDE
    target_function = REGISTERED_TOOLS[payload.tool_name]

    try:
        # Desempaquetar dinámicamente los argumentos enviados por el LLM
        execution_result = target_function(**payload.arguments)

        return ToolExecutionResponse(
            call_id=payload.call_id,
            status="completed",
            result=execution_result
        )
    except TypeError as e:
        # Detecta errores en esquema de parámetros del LLM
        print(f"[ERROR DE ESQUEMA] Argumentos inválidos enviados por el LLM: {str(e)}")
        raise HTTPException(status_code=422, detail=f"Desajuste de argumentos: {str(e)}")

if __name__ == "__main__":
    # Ejecutar servidor local
    uvicorn.run("tool_server:app", host="127.0.0.1", port=8000, reload=True)
Paso 3: Configurar Cliente del Orquestador en la Nube
Configurar la aplicación cliente para que las llamadas de retorno a herramientas apunten a la URL del túnel reverso en lugar de a la ejecución interna.
# orchestrator_client.py
import requests
from langchain_openai import ChatOpenAI
from langchain_core.messages import HumanMessage, ToolMessage

TUNNEL_URL = "https://agent-dev-environment.ngrok.app/execute-tool"

# Inicializar modelo
llm = ChatOpenAI(model="gpt-4o", temperature=0)

# Definir esquema de herramientas disponible para el modelo
tools = [{
    "type": "function",
    "function": {
        "name": "calculate_database_query",
        "description": "Ejecuta una consulta estructurada en la base de datos local.",
        "parameters": {
            "type": "object",
            "properties": {
                "query": {"type": "string", "description": "Cadena de consulta SQL"},
                "limit": {"type": "integer", "description": "Máximo de filas a devolver"}
            },
            "required": ["query", "limit"]
        }
    }
}]

# Primera llamada al modelo
messages = [HumanMessage(content="Ejecuta una consulta para usuarios activos con límite 50.")]
response = llm.invoke(messages, tools=tools)

# Procesar llamadas a funciones devueltas por el modelo
if response.tool_calls:
    for tool_call in response.tool_calls:
        print(f"Enrutando llamada a herramienta '{tool_call['name']}' a través del túnel reverso...")

        # Enviar solicitud de ejecución a través del túnel hacia IDE local
        webhook_payload = {
            "call_id": tool_call["id"],
            "tool_name": tool_call["name"],
            "arguments": tool_call["args"]
        }

        tunnel_response = requests.post(TUNNEL_URL, json=webhook_payload)
        tool_result = tunnel_response.json()

        print(f"Resultado local recibido: {tool_result}")
Técnicas Avanzadas de Inspección
1. Inspección de Encabezados y Carga Útil
Las utilidades de túneles reversos exponen paneles de control Web UI locales (p.ej., [http://127.0.0.1:4040](http://127.0.0.1:4040) para ngrok). Los desarrolladores pueden inspeccionar encabezados HTTP en crudo, errores de serialización JSON y reactivar acciones de reintento con un solo clic para volver a activar ejecuciones fallidas de herramientas mediante puntos de interrupción locales sin volver a ejecutar largos pasos de generación del LLM.
2. Puntos de Interrupción Condicionales
Configura puntos de interrupción condicionales en tu IDE basados en propiedades de ejecución del LLM:
# Condición de punto de interrupción condicional en IDE Python
len(payload.arguments.get("query", "")) > 100 or payload.arguments.get("limit") is None
Este enfoque aísla casos límite donde los LLMs generan argumentos malformados bajo condiciones de contexto largo.
3. Seguridad Empresarial y Control de Acceso
Al túnel de endpoints locales, aplica controles de seguridad estrictos para prevenir acceso público:
- Mutual TLS (mTLS): Validar certificados del cliente en el túnel.
- Firmas en Encabezados: Verificar encabezados HMAC (
X-Signature-SHA256) enviados por los endpoints de orquestación para asegurar que las solicitudes provienen exclusivamente de servicios en la nube autorizados.
Tema 2: Túneles en Enjambres Multi-Agente Locales: Depuración de Comunicación entre Agentes a través de NAT
El Cuello de Botella en Redes en Arquitecturas Descentralizadas
A medida que el diseño agentico avanza hacia enjambres heterogéneos (como AutoGen/AG2, CrewAI o implementaciones personalizadas de A2A / Protocolo de Contexto de Modelo), los agentes especializados se distribuyen en entornos dispares:
- Agente A (Planificador): Corre en una VPC de AWS.
- Agente B (Intérprete de Código): Corre en un contenedor Docker local detrás de NAT.
- Agente C (Controlador de Hardware): Corre en un dispositivo edge (p.ej., Raspberry Pi o NVIDIA Jetson) tras un firewall celular restringido.
┌─────────────────────────────────────────────────────────────────────────────┐
│ VPC Corporativa (AWS)                                                      │
│                                                                             │
│   ┌─────────────────────────────────────────────────────────────────────┐   │
│   │ Agente A (Supervisor / Coordinador)                                │   │
│   └──────────────────────────────────┬──────────────────────────────────┘   │
└──────────────────────────────────────│──────────────────────────────────────┘
                                   │
 ❌ NO SE PUEDE RUTEAR DIRECTAMENTE SOBRE INTERNET PÚBLICA
                                   │
┌──────────────────────────────────────┴──────────────────────────────────────┐
│ Oficina / Estación de Trabajo Local (detrás de NAT y firewalls)             │
│                                                                             │
│   ┌────────────────────────────────┐     ┌──────────────────────────────┐   │
│   │ Agente B (Docker Sandbox)        │     │ Agente C (Nodo Sensor Edge)  │   │
│   │ IP: 172.18.0.2 (Privado)         │     │ IP: 192.168.1.45 (Privado)  │   │
│   └────────────────────────────────┘     └──────────────────────────────┘   │
└─────────────────────────────────────────────────────────────────────────────┘
El Desafío de Infraestructura
Los protocolos de red estándar fallan en estas topologías:
- NATs Simétricos y Firewalls Estrictos: Bloquean conexiones entrantes a nodos agentes locales, impidiendo invocaciones peer-to-peer.
- Asignación Dinámica de IP: Impide hardcodear endpoints de agentes.
- Alta Latencia entre Agentes: La consulta HTTP REST tradicional añade latencia prohibitiva en negociaciones complejas que requieren cientos de mensajes.
Matriz de Selección de Protocolo: gRPC vs. JSON-RPC sobre Mallas de Túneles
Al escoger una capa de comunicación para enjambres descentralizados, la elección de transporte dicta mucho el rendimiento, la estrictitud del esquema y la eficiencia en streaming.
| Atributo Arquitectónico | JSON-RPC 2.0 sobre WebSocket HTTP/2 | gRPC sobre Túnel HTTP/2 |
|---|---|---|
| Formato de Carga | JSON en texto (legible) | Protocol Buffers binario (altamente comprimido) |
| Enforcement de Esquema | Dinámico / en tiempo de ejecución (Pydantic / Zod) | Estático / en tiempo de compilación (.proto) |
| Capacidad de Streaming | Full-duplex vía WebSockets / SSE | Streaming bidireccional nativo |
| Perfil de Latencia | Moderada (sobrecarga de análisis) | Ultra baja (serialización sin copias) |
| Compatibilidad NAT | Ligero, fácil depuración web | Eficiencia excepcional sobre TCP multiplexado |
| Flujos de Trabajo Ideales | Enjambres de texto ad-hoc, esquemas JSON flexibles | Enjambres de sensores de alta frecuencia, streaming multimodal |
Implementación de Topologías Multi-Endpoint con WireGuard / Túneles
Para habilitar enrutamiento entre agentes sin IP pública, los desarrolladores pueden desplegar una red overlay cifrada usando WireGuard, Tailscale o Puertas de Túnel P2P.
                         ┌─────────────────────────┐
                         │ Nodo de Relevo / Gateway │
                         │ (Red Overlay Pública)   │
                         └────────────▲────────────┘
                                      │
            ┌─────────────────────────┴─────────────────────────┐
            │ Túnel cifrado WireGuard / Overlay (UDP encriptado)   │
            └────────────▲─────────────────────────▲────────────┘
                         │                         │
     ┌───────────────────┴──────────┐   ┌──────────┴───────────────────┐
     │ Nodo 1: Orquestador en la Nube │   │ Nodo 2: Nodo Edge Local     │
     │ IP de malla: 10.0.0.1          │   │ IP de malla: 10.0.0.2      │
     │ (Agente Supervisor)            │   │ (Agente Trabajador)        │
     └──────────────────────────────┘   └──────────────────────────────┘
Implementación en Producción: Comunicación Asíncrona JSON-RPC 2.0 entre Agentes
A continuación, una implementación completa de un sistema multi-agente descentralizado ejecutándose en contenedores locales sobre una malla túnel JSON-RPC.
1. Definición del Protocolo JSON-RPC y Agente Base (agent_protocol.py)
# agent_protocol.py
import json
from typing import Any, Dict, Optional
from pydantic import BaseModel, Field

class JSONRPCRequest(BaseModel):
    jsonrpc: str = "2.0"
    method: str
    params: Dict[str, Any]
    id: str

class JSONRPCResponse(BaseModel):
    jsonrpc: str = "2.0"
    result: Optional[Any] = None
    error: Optional[Dict[str, Any]] = None
    id: str

class AgentCapability(BaseModel):
    agent_id: str
    description: str
    methods: list[str]
2. Implementación del Agente Trabajador Local (local_worker_agent.py)
Este agente corre en una red privada local, sirviendo capacidades a través de un túnel cifrado.
# local_worker_agent.py
import asyncio
from fastapi import FastAPI, WebSocket, WebSocketDisconnect
from agent_protocol import JSONRPCRequest, JSONRPCResponse
import uvicorn

app = FastAPI(title="Agente de Trabajo Local")

async def execute_code_analysis(code: str) -> dict:
    """Simula tarea de análisis de código local y segura."""
    await asyncio.sleep(0.5) # Tiempo de procesamiento simulado
    return {
        "complexity_score": 4,
        "vulnerabilities_found": 0,
        "suggestion": "Optimizar bucle en línea 12."
    }

@app.websocket("/ws/rpc")
async def websocket_rpc_endpoint(websocket: WebSocket):
    await websocket.accept()
    print("[MESH] Conexión del Agente en la Nube al Agente de Trabajo Local.")

    try:
        while True:
            # Recibir solicitud RPC en crudo desde la red overlay
            raw_data = await websocket.receive_text()
            request_data = JSONRPCRequest.model_validate_json(raw_data)

            print(f"[SOLICITUD RPC] Método: {request_data.method}")

            # Enrutamiento por método
            if request_data.method == "analyze_code":
                code_param = request_data.params.get("code", "")
                output = await execute_code_analysis(code_param)

                response = JSONRPCResponse(
                    result=output,
                    id=request_data.id
                )
            else:
                response = JSONRPCResponse(
                    error={"code": -32601, "message": "Método no encontrado"},
                    id=request_data.id
                )

            # Enviar respuesta RPC por WebSocket
            await websocket.send_text(response.model_dump_json())

    except WebSocketDisconnect:
        print("[MESH] Nodo del enjambre desconectado.")

if __name__ == "__main__":
    # Servidor en escucha local, expuesto en la malla a través del cliente de túnel local
    uvicorn.run(app, host="0.0.0.0", port=9001)
3. Agente Supervisor en la Nube (cloud_supervisor.py)
Este agente orquesta flujos de trabajo enviando comandos RPC a través de la malla hacia la IP del agente local o alias tunelizado.
# cloud_supervisor.py
import asyncio
import websockets
import uuid
from agent_protocol import JSONRPCRequest, JSONRPCResponse

# Endpoint del túnel seguro a la IP del agente local (ej., Tailscale/WireGuard o proxy de túnel)
LOCAL_WORKER_TUNNEL_ENDPOINT = "ws://10.0.0.2:9001/ws/rpc"

async def dispatch_task_to_local_agent(method: str, params: dict):
    request_id = str(uuid.uuid4())

    rpc_payload = JSONRPCRequest(
        method=method,
        params=params,
        id=request_id
    )

    print(f"[SUPERVISOR] Conectando al Agente Local en la malla NAT en {LOCAL_WORKER_TUNNEL_ENDPOINT}...")

    async with websockets.connect(LOCAL_WORKER_TUNNEL_ENDPOINT) as ws:
        # Enviar llamada RPC
        await ws.send(rpc_payload.model_dump_json())
        print(f"[SUPERVISOR] Método '{method}' enviado [ID: {request_id}]")

        # Esperar respuesta
        raw_response = await ws.recv()
        response = JSONRPCResponse.model_validate_json(raw_response)

        if response.error:
            print(f"[ERROR RPC] Código {response.error['code']}: {response.error['message']}")
        else:
            print(f"[ÉXITO] Resultado de la ejecución: {response.result}")

if __name__ == "__main__":
    # Ejecutar flujo de orquestación
    sample_code = "def fibonacci(n):\n    return n if n <= 1 else fibonacci(n-1) + fibonacci(n-2)"
    asyncio.run(dispatch_task_to_local_agent("analyze_code", {"code": sample_code}))
Observabilidad, Trazabilidad y Estrategias de Mantención NAT
1. Propagación de Contexto OpenTelemetry entre enjambres
Cuando el Agente A invoca al Agente B vía JSON-RPC, el contexto de traza debe sobrevivir la frontera de red. Incluye encabezados traceparent de OpenTelemetry directamente en los parámetros RPC:
{
  "jsonrpc": "2.0",
  "method": "analyze_code",
  "params": {
    "code": "...",
    "_telemetry_context": {
      "traceparent": "00-4bf92f3577b34da6a3ce929d0e0e4736-00f067aa0ba902b7-01"
    }
  },
  "id": "req-001"
}
Esto permite que herramientas de trazabilidad distribuidas (como Jaeger, Honeycomb o LangSmith) visualicen árboles de ejecución de extremo a extremo a través de servidores en la nube y laptops aisladas.
2. Mantener vivo el estado de las tablas NAT
Los firewalls eliminan conexiones TCP inactivas tras periodos de silencio (30-120 segundos). Para mantener vivos los túneles multi-agente bidireccionales:
- Keepalives TCP: Configurar opciones de socket (
SO_KEEPALIVEconTCP_KEEPIDLE=30). - Pings a nivel de aplicación: Enviar pings cada 15 segundos en conexiones WebSocket o gRPC:
# Mantener WebSocket con pings en Python
async with websockets.connect(endpoint, ping_interval=15, ping_timeout=10):
    ...
3. Reenrutamiento automático y conmutación por fallo en malla
En despliegues multi-agente, si un agente local pierde conectividad, el circuito del agente supervisor debe redirigir tareas a un nodo fallback o cola en la nube.
# Ejemplo conceptual de Circuito de Conmutación
try:
    await dispatch_task_to_local_agent(...)
except (websockets.exceptions.ConnectionClosedError, TimeoutError):
    print("[CIRCUITO DE CONMUTACIÓN] Agente local offline. Redirigiendo a nodo fallback en la nube...")
    await dispatch_task_to_cloud_fallback(...)
Conclusión y Lista de Verificación de Arquitectura
Construir infraestructuras resilientes de local a nube y multi-agente requiere cambiar de suposiciones de despliegue estático a arquitecturas modernas conscientes de túneles:
- [x] Para llamadas a funciones: Usar túneles TLS reversos (
ngrok,devtunnel) para conectar ejecución en la nube con servidores locales con puntos de interrupción. - [x] Para redes de agentes: Aprovechar transportes estructurados (JSON-RPC o gRPC sobre HTTP/2) sobre redes privadas (WireGuard, Tailscale) para sortear NAT.
- [x] Para observabilidad: Propagar contextos de traza en las fronteras de red para mantener visibilidad de extremo a extremo en topologías distribuidas.
Related InstaTunnel pages
Continue from this article into the most relevant product guides and workflows.
Related Topics
Keep building with InstaTunnel
Read the docs for implementation details or compare plans before you ship.