Agentes de IA de voz en localhost: Twilio Media Streams y OpenAI Realtime a través de un túnel
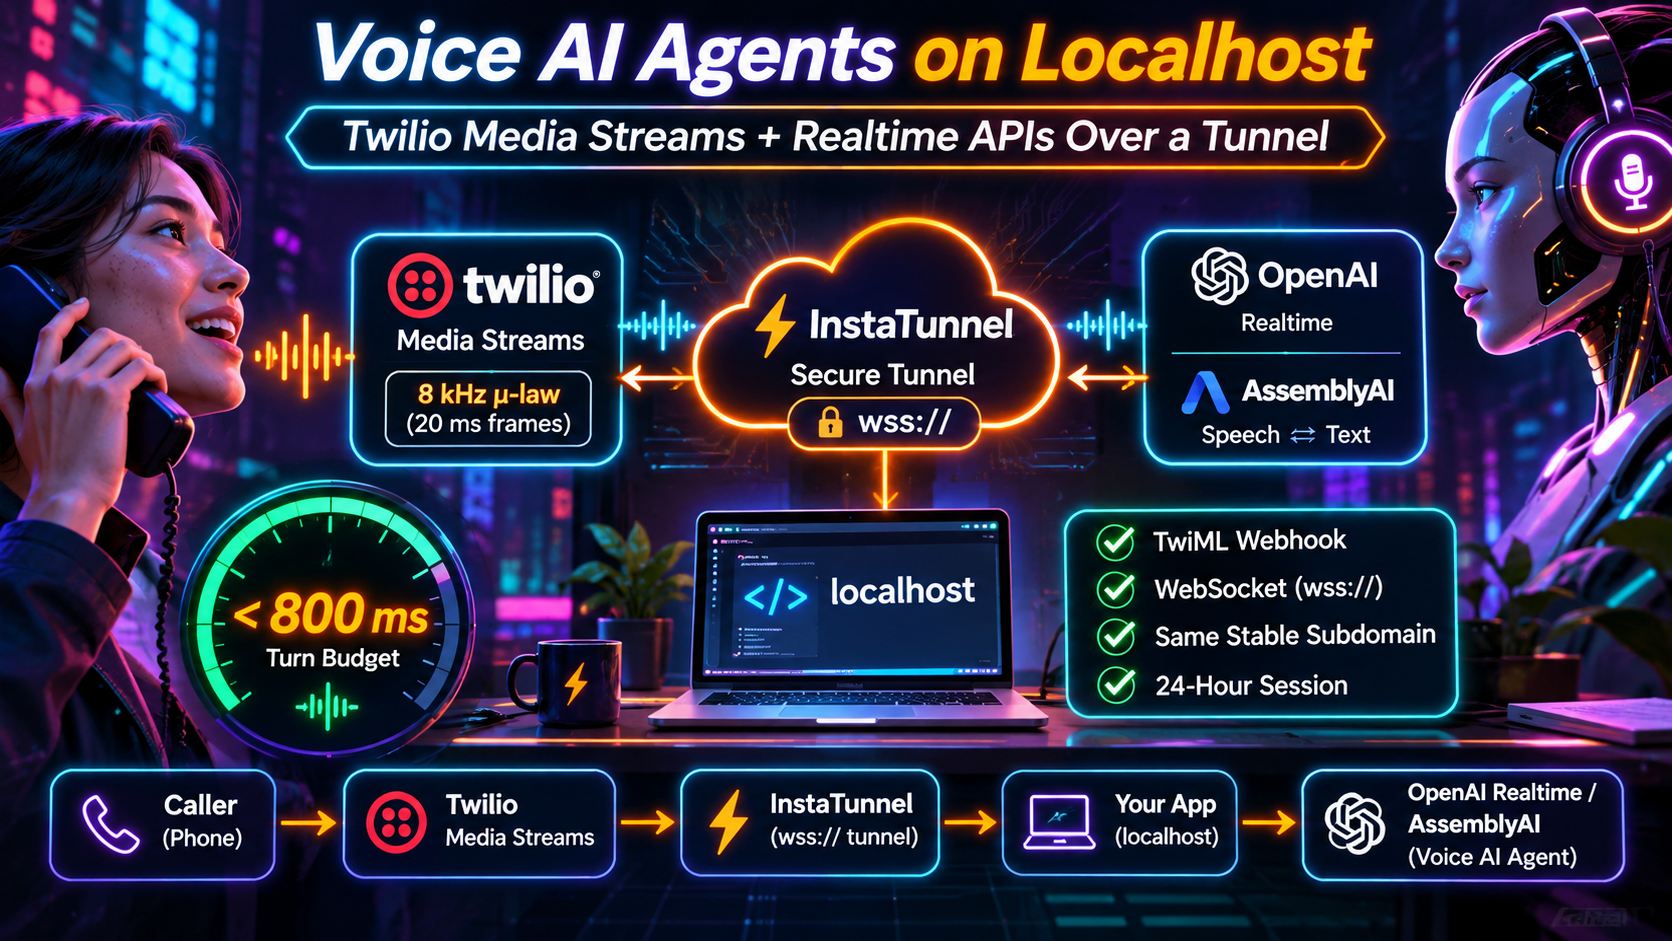
Ejecute un agente de IA de voz de Twilio en localhost. Reenvíe audio wss:// a través de un túnel, mantenga la latencia por debajo de 800 ms y use un subdominio estable para TwiML y WebSocket.
Quick answer
Agentes de IA de voz en localhost: Twilio Streams a través de un túnel: quick answer
If free tunnel limits interrupt your workflow, compare session length, stable URLs, concurrent tunnels, and paid-plan pricing before choosing a localhost tunnel tool.
What free tunnel limits should developers check first?
Check session duration, URL stability, concurrent tunnels, custom subdomains, bandwidth or request limits, and whether webhook callbacks survive restarts.
How does InstaTunnel handle longer development sessions?
InstaTunnel Free is designed around 24-hour sessions, with Pro available for higher limits and MCP endpoint tunnel workflows.
Un agente de voz basado en teléfono es lo menos tolerante que puedes ejecutar en un portátil. Un webhook puede reintentar. Una página puede recargarse. Una llamada no puede: si el audio se queda atascado por medio segundo, el interlocutor lo oye.
Twilio Media Streams, junto con Realtime API de OpenAI, es una forma común de construir estos agentes. Un pipeline clásico de reconocimiento de voz a texto → LLM → texto a voz es el otro. La propia documentación de Twilio enumera agentes de IA como un caso de uso de Media Streams, y sus ejemplos usan ngrok-style hostnames porque la URL del stream tiene que ser accesible públicamente a través de TLS. Esta guía cubre qué cruza el túnel, cómo funciona la actualización de WebSocket a través de un proxy de borde, cómo mantenerse cerca de un presupuesto de turno de 800 ms y por qué un subdominio estable facilita un día de llamadas de prueba.
Por qué los agentes de voz son una carga de túnel diferente
La mayor parte del tráfico del túnel es solicitud/respuesta: llega un webhook y tu servidor responde. La voz es una transmisión continua bidireccional de pequeños mensajes de audio. Twilio envía el audio del llamante a tu servidor, y tu servidor devuelve el audio del agente a través del mismo WebSocket durante toda la llamada.
A diferencia de flujos unidireccionales como Server-Sent Events, la temporización de ida y vuelta y la fluctuación importan en ambas direcciones al mismo tiempo. El formato de audio es estrecho y fijo. Según la documentación de Twilio, el mensaje start siempre reporta audio/x-mulaw, 8,000 Hz, un canal, y las cargas útiles están codificadas en base64 dentro de JSON. μ-law a 8 kHz son 8,000 bytes por segundo, así que un cuadro de 20 ms tiene 160 bytes. Twilio documenta que el audio que envías de vuelta puede tener cualquier tamaño. El ancho de banda es trivial; la latencia no.
La arquitectura: dos URLs, un host
Un agente de voz de Twilio necesita dos endpoints públicos:
- Un webhook HTTPS que Twilio llama cuando llega una llamada. Devuelve TwiML.
- Un endpoint
wss://al que Twilio se conecta después de leer ese TwiML.
Ambos pueden vivir en el mismo hostname del túnel:
Caller ──PSTN──→ Twilio ──POST /voice──→ tunnel edge ──→ localhost:5050/voice   (returns TwiML)
                   │
                   └────wss://your-subdomain.example/media ──→ tunnel edge ──→ localhost:5050/media
                                                                                   │
                                                              outbound wss to OpenAI Realtime
Estas reglas de la documentación de Twilio importan para la configuración del túnel:
wsses el único protocolo soportado. Una URL plainws://no funcionará.- La
urlno admite parámetros de consulta. Pasa datos por llamada con elementos<Parameter>en su lugar. Llegan en el mensajestartdel WebSocket bajocustomParameters. La longitud combinada del nombre y el valor de cada parámetro debe ser inferior a 500 caracteres. <Connect><Stream>crea un flujo bidireccional, y Twilio no ejecuta TwiML posteriores hasta que tu servidor cierre el WebSocket.- Una llamada solo puede tener un flujo bidireccional activo a la vez, y los flujos bidireccionales sólo pueden recibir el
inbound_track. - Tu servidor debe aceptar conexiones WebSocket seguras desde Twilio en el puerto TCP 443, desde cualquier dirección IP pública, y debe validar el encabezado
X-Twilio-Signature. - No puedes iniciar un flujo bidireccional a través del recurso REST Stream. Debe Provenir de
<Connect><Stream>.
Qué envía Twilio y qué espera de vuelta
Twilio envía mensajes connected, start, media, dtmf, mark y stop. dtmf y mark aparecen solo en flujos bidireccionales. DTMF es compatible solo en la dirección entrante, así que puedes leer las pulsaciones del teclado pero no puedes enviar tonos. Tu servidor puede enviar tres tipos de mensajes: media, mark y clear.
Un mensaje de audio de salida es mínimo:
{
  "event": "media",
  "streamSid": "MZXXXXXXXXXXXXXXXXXXXXXXXXXXXXXX",
  "media": { "payload": "<base64 mulaw/8000>" }
}
Tres detalles provocan la mayoría de los errores de tipo “se conecta pero suena mal”:
- Sin encabezados de archivos. La carga útil debe ser μ-law sin procesar. Twilio advierte que los bytes de encabezado hacen que el flujo de medios suene mal, a menudo estática o clics.
- El audio está en búfer. Twilio reproduce los mensajes
mediaen el orden en que se reciben. Si envías audio más rápido que en tiempo real, como suelen hacer las APIs de modelos, se encola en el lado de Twilio. clearvacía el búfer. Cuando un llamante interrumpe, envíasclear. Twilio entonces devuelve mensajesmarkpara cualquier marca que enviaste y que no se haya reproducido, para que puedas ver qué audio se descartó.
Como el flujo es bidireccional, se detiene cuando termina la llamada o cuando tu servidor cierra el WebSocket. No puedes detenerlo con <Stop>. Si tu servidor cierra la conexión, Twilio solicita la URL de acción de <Connect> si configuras una. De lo contrario continúa con el TwiML que siga a <Connect>.
Conexión de OpenAI Realtime sin transcoding
La forma más rápida de proteger tu presupuesto de turnos es evitar el re-muestreo. El formato PCM de OpenAI solo admite una tasa de muestreo de 24 kHz. Puente de Twilio a PCM, por lo tanto, significa convertir 8 kHz μ-law hacia arriba y 24 kHz de audio hacia abajo en cada fotograma. Un tutorial publicado midió aproximadamente 80 ms añadidos por turno por un re-muestreador ingenuo en la ruta crítica.
En su lugar, solicita a Realtime G.711 μ-law directamente y pasa las cargas útiles de Twilio sin cambios. La GA API admite audio/pcmu (μ-law) y audio/pcma (A-law) como formatos de audio de sesión. Twilio usa μ-law, así que quieres audio/pcmu.
Los campos planos de la era beta (input_audio_format: "g711_ulaw") se reemplazan en el esquema GA por objetos anidados audio.input.format y audio.output.format. Si estás portando un ejemplo antiguo de Twilio y ves errores de esquema, empieza por ahí.
{
  "type": "session.update",
  "session": {
    "type": "realtime",
    "model": "gpt-realtime-2.1",
    "output_modalities": ["audio"],
    "instructions": "You are a concise phone agent.",
    "audio": {
      "input":  { "format": { "type": "audio/pcmu" }, "turn_detection": { "type": "semantic_vad" } },
      "output": { "format": { "type": "audio/pcmu" }, "voice": "marin" }
    }
  }
}
El 6 de julio de 2026, OpenAI lanzó gpt-realtime-2.1 y gpt-realtime-2.1-mini. El modelo completo actualiza GPT-Realtime-2 con mejor reconocimiento alfanumérico, manejo de silencio y ruido, y comportamiento ante interrupciones. El mini es un modelo de razonamiento de menor costo para la voz. OpenAI también dijo que redujo la latencia p95 en al menos un 25% en sus modelos de voz Realtime mediante un caché mejorado. Los nombres de los modelos cambian rápidamente, así que confirma el ID y la precios actuales en la documentación de OpenAI antes de copiar cualquier código.
Ambos modelos 2.1 aceptan un ajuste de esfuerzo de razonamiento. Resúmenes de la orientación de OpenAI, y una prueba publicada, señalan lo mismo: empieza con poca capacidad de razonamiento, porque un mayor esfuerzo añade latencia. En esa prueba (en gpt-realtime-2), incrementar el esfuerzo de bajo a medio movió el tiempo de respuesta medio de ~1.1 s a ~1.8 s.
Un puente mínimo tiene dos bucles compartiendo el ID de flujo:
# Twilio <- OpenAI Realtime bridge (FastAPI + websockets); error handling omitted
state = {"stream_sid": None}

async def twilio_to_openai(twilio_ws, openai_ws):
    async for raw in twilio_ws.iter_text():
        msg = json.loads(raw)
        if msg["event"] == "start":
            state["stream_sid"] = msg["start"]["streamSid"]
        elif msg["event"] == "media":
            await openai_ws.send(json.dumps({
                "type": "input_audio_buffer.append",
                "audio": msg["media"]["payload"],   # already base64 mulaw
            }))
        elif msg["event"] == "stop":
            break

async def openai_to_twilio(twilio_ws, openai_ws):
    async for raw in openai_ws:
        ev = json.loads(raw)
        if ev["type"] == "response.output_audio.delta":
            await twilio_ws.send_text(json.dumps({
                "event": "media",
                "streamSid": state["stream_sid"],
                "media": {"payload": ev["delta"]},  # forward untouched
            }))
        elif ev["type"] == "input_audio_buffer.speech_started":
            # caller is talking over the agent: flush what Twilio has queued
            await twilio_ws.send_text(json.dumps({
                "event": "clear",
                "streamSid": state["stream_sid"],
            }))

# run both with asyncio.gather(...)
La conexión a OpenAI es saliente desde tu máquina, por lo que solo la rama de Twilio cruza el túnel. Eso importa para el cálculo de latencia a continuación.
Actualización de WebSocket a través del borde del túnel
Un WebSocket nace de una solicitud HTTP. El cliente envía un GET con Upgrade: websocket, Connection: Upgrade, un Sec-WebSocket-Key y Sec-WebSocket-Version: 13. El servidor responde 101 Switching Protocols, y a partir de ahí ambos lados intercambian tramas a través de la misma conexión TCP.
Para un borde de túnel, eso significa que debe:
- Terminar TLS para que Twilio pueda conectarse a una URL
wss://con un certificado válido, en el puerto 443. - Reenviar los encabezados de actualización a tu origen local en lugar de eliminar
UpgradeyConnection. - Pasar las tramas en ambas direcciones sin almacenarlas en búfer en bloques más grandes, ya que el búfer convierte tramas constantes en ráfagas.
- Mantener la conexión abierta durante toda la llamada.
La voz no está ociosa mientras la llamada está activa, así que los timeouts de inactividad rara vez importan, pero podría existir un límite de vida por conexión.
Prueba esto antes de depurar la lógica del agente: apunta un cliente WebSocket a tu URL pública wss:// y confirma una respuesta 101 y mensajes devueltos. Esto descarta toda la capa de borde en un minuto.
La validación de firmas necesita una comprobación extra. Twilio calcula X-Twilio-Signature sobre la URL pública que llamó, por lo que el esquema y el host que tu código de validación reconstruye deben coincidir con la URL pública del túnel, no con localhost. Si la validación pasa en una conexión directa pero falla a través del túnel, compara esos valores primero.
El presupuesto de turno por debajo de un segundo
El objetivo a diseñar es la brecha entre que el llamante termina una oración y que el agente empiece su respuesta. La guía de AssemblyAI para agentes telefónicos sitúa la meta alcanzable en alrededor de 800 ms, que, según dice, los llamadores experimentan como atento. Dice que el agente se siente roto más allá de 1,500 ms. Su presupuesto de muestra asigna 50–150 ms a la red y la telefonía, 150–300 ms a la terminación en el extremo, y varios cientos de milisegundos a que el LLM genere el primer token y el primer byte de TTS.
Un modelo de voz a voz evita el relé entre esas etapas, pero no el objetivo. Un tutorial de Techsy midió una mediana de 1.1 s y un p95 de 1.9 s en 40 llamadas de Twilio con gpt-realtime-2 y semantic_vad y un esfuerzo de razonamiento bajo. Su servidor estaba ubicado cerca de la región de OpenAI, y la prueba es anterior a los modelos 2.1. Eso es la medida de un vendedor, así que míralo como un punto de referencia, no como una métrica. La conclusión es que 800 ms es un objetivo para una pila bien ajustada, no una norma que obtengas gratis.
Qué añade el túnel
Solo la rama de Twilio cruza el túnel. El audio del llamante viaja desde Twilio → borde → tu portátil, y la respuesta viaja desde el portátil → borde → Twilio. En comparación con un relé desplegado cerca de Twilio, el costo adicional es el salto extra a través del borde y tu última milla, en ambas direcciones. Depende de tres cosas que controlas:
- Distancia. La región predeterminada de Twilio es US1. Media Streams también está disponible en Irlanda (IE1) y Australia (AU1). Elige la región del túnel más cercana a la región de Twilio que utilizan tus llamadas.
- Tu última milla. El jitter de Wi-Fi o una VPN te afectarán más que el salto del borde. Usa Ethernet cableado para sesiones de prueba.
- Jitter, no promedios. Una ruta que se estanca ocasionalmente por 200 ms produce huecos audibles incluso si la media parece bien.
No pude verificar una cifra publicada, neutral frente a proveedores, para el overhead del túnel en el tráfico de voz, así que mídelo. Registra cuándo llega input_audio_buffer.speech_stopped, cuándo llega el primer response.output_audio.delta, y cuándo envías el primer mensaje media de vuelta a Twilio. Compara con una línea base desplegada.
Interrupciones sin hablar sobre el llamante
Como Twilio almacena en búfer el audio saliente, la interrupción consta de tres pasos:
- Cuando Realtime señala que el llamante comenzó a hablar (
input_audio_buffer.speech_started), envía a Twilio un mensajeclearpara que el audio en cola se detenga. La configuración de sesión de OpenAI también controla si un inicio de habla detectado interrumpe automáticamente la respuesta en curso. - Envía un mensaje
markdespués de cadamediay usa las marcas que Twilio devuelve para rastrear lo que realmente se reprodujo. - Indica al modelo lo que se escuchó enviando un evento
conversation.item.truncatepara el ítem interrumpido, para que su registro de la conversación coincida con lo que experimentó el llamante.
Omite el paso 1 y el agente termina su oración sobre el llamante. Omite el paso 3 y el modelo cree haber dicho cosas que el llamante nunca escuchó.
Por qué un subdominio estable y una sesión de 24 horas ayudan
La depuración de voz implica muchas llamadas cortas a lo largo de un día: ajusta el prompt, llama, escucha y repite. Dos cosas en la configuración de Twilio son dolorosas con una URL aleatoria y cambiante:
- El webhook de voz del número de teléfono está configurado en la consola de Twilio. Cambia el host y lo editas de nuevo.
- La URL
<Stream>dentro de tu TwiML debe ser un hostwss://completo, y dado que no se admiten cadenas de consulta, no puedes introducir datos de enrutamiento en la URL.
Un túnel que te da un subdominio estable resuelve ambos. El mismo host sirve POST /voice y wss://…/media, por lo que registras el webhook una vez y el TwiML lee su propio host desde la solicitud. Los datos por llamada van en valores <Parameter>, y marcas el estado por el streamSid y el SID de la llamada desde el mensaje start.
Según el material publicado por InstaTunnel, las sesiones gratuitas duran hasta 24 horas e incluyen un subdominio persistente personalizado, con límites más largos en Pro. Consulta la página de precios actual antes de confiar en números exactos. Para el trabajo de voz, la ventaja es simple: un túnel que perdura un día de trabajo significa no volver a reconectar ni a pegar URLs en mitad de la prueba.
Un límite recae en OpenAI. Una sesión Realtime tiene una duración máxima de 60 minutos, por lo que un túnel de larga duración no implica una llamada de larga duración. Planifica reconexiones en llamadas muy largas.
Seguridad para un túnel que admite tráfico telefónico
Un WebSocket abierto que conecta con una API de modelo de pago es un riesgo de costo si alguien lo encuentra.
- Valida
X-Twilio-Signatureen el webhook y en el handshake de WebSocket, y rechaza fallos antes de abrir el socket upstream de OpenAI. - Mantén las claves de API en tu proceso servidor, nunca en TwiML o un navegador.
- Cierra el túnel cuando termines, y establece límites de gasto en tu cuenta de modelo.
- No pongas una puerta de inicio de sesión en el navegador delante de Twilio. No puede completar un inicio de sesión interactivo, así que la validación de firmas es tu autenticación.
Lista de verificación de solución de problemas
Configura una URL statusCallback en <Stream> mientras depuras. Twilio envía eventos stream-started, stream-stopped y stream-error allí, con un mensaje de error en caso de fallo. La URL debe ser absoluta y de acceso público, para que pueda atravesar el mismo túnel.
| Síntoma | Causa probable |
|---|---|
| La llamada se conecta y luego se corta | url no es wss://, falla el handshake, o la validación de firma rechaza la solicitud |
| Audio estático o clics en la línea | Bytes de encabezado en la carga, o codificación incorrecta (no μ-law 8 kHz) |
| Audio entrecortado o distorsionado | La sesión de OpenAI aún está en 24 kHz PCM mientras reenviás μ-law crudo |
| El agente habla sobre el llamante | No se envía clear tras la interrupción |
| Largos y desiguales pausas | Remuestreo en la ruta crítica, región de túnel distante o jitter de la portátil |
| Funciona localmente, falla a través del túnel | Edge no reenvía encabezados Upgrade, o desajuste de host de firma |
| El webhook funciona, la transmisión nunca se conecta | TLS o alcance del puerto 443 al path de WebSocket |
Errores de esquema en session.update |
Campos de audio planos estilo beta enviados a la GA API |
Cuándo dejar el túnel atrás
Un túnel es para desarrollo. En producción, despliega el relé en una región en la nube cercana a los servidores de medios de Twilio para eliminar tu portátil y un salto desde la ruta de la llamada.
Tienes dos formas más de cortar el relé o el cableado de audio:
Omite el relé de WebSocket con SIP. La Realtime API de OpenAI acepta llamadas SIP. En el recorrido de Twilio, un Elastic SIP Trunk usa un URI de origen del tipo
sip:proj_<tu_id_proyecto>@sip.api.openai.com;transport=tls. OpenAI luego dispara un webhookrealtime.call.incominga tu servidor, y tu servidor acepta la llamada a través de la Realtime Calls API. Liberas control sobre el camino de audio a cambio de menos partes móviles. Un túnel sigue siendo útil, porque ese webhook necesita una URL pública durante el desarrollo.Deja que Twilio maneje el habla. Si no necesitas audio crudo en absoluto, Twilio apunta a ConversationRelay, donde Twilio maneja reconocimiento de voz y texto a voz para ti.
Preguntas frecuentes
¿Twilio Media Streams necesita wss://?
Sí. wss es el único protocolo soportado para <Stream>, y Twilio espera que tu servidor acepte conexiones WebSocket seguras en el puerto TCP 443.
¿Qué formato de audio usa Twilio?
μ-law (audio/x-mulaw), 8,000 Hz, mono, codificado en base64 en JSON. El audio de salida debe ser crudo, sin encabezados de archivo.
¿Puede Realtime de OpenAI tomar el audio de Twilio directamente?
Sí. Establece el formato de audio GA a audio/pcmu para entrada y salida, y puedes reenviar cargas útiles sin transcoding.
¿Puedo poner parámetros de consulta en la URL del stream?
No. Usa elementos <Parameter>, que llegan en el mensaje start.
¿Qué tan rápido debe responder un agente de voz?
Alrededor de 800 ms es la meta citada con frecuencia, y más allá de 1,500 ms se siente roto. Las mediciones de tutoriales publicados se acercan a un segundo, así que mide tu propia pila.
Fuentes
- Twilio: TwiML
<Stream> - Twilio: Media Streams WebSocket messages
- Twilio: Media Streams overview
- Twilio: Connect the OpenAI Realtime SIP Connector with Elastic SIP Trunking
- OpenAI Developer Community: gpt-realtime-2.1 release
- OpenAI: Realtime conversations guide
- OpenAI API reference: Realtime calls
- AssemblyAI: How to create a phone-based voice agent
- Techsy: OpenAI Realtime API voice agent tutorial
- InstaTunnel on DEV: ngrok alternatives in 2026
Related InstaTunnel pages
Continue from this article into the most relevant product guides and workflows.
Related Topics
Keep building with InstaTunnel
Read the docs for implementation details or compare plans before you ship.