Architecturer des systèmes IA en production : Débogage des LLM locaux e0 l'aide de tunnels inverses et infrastructure en essaim découplé
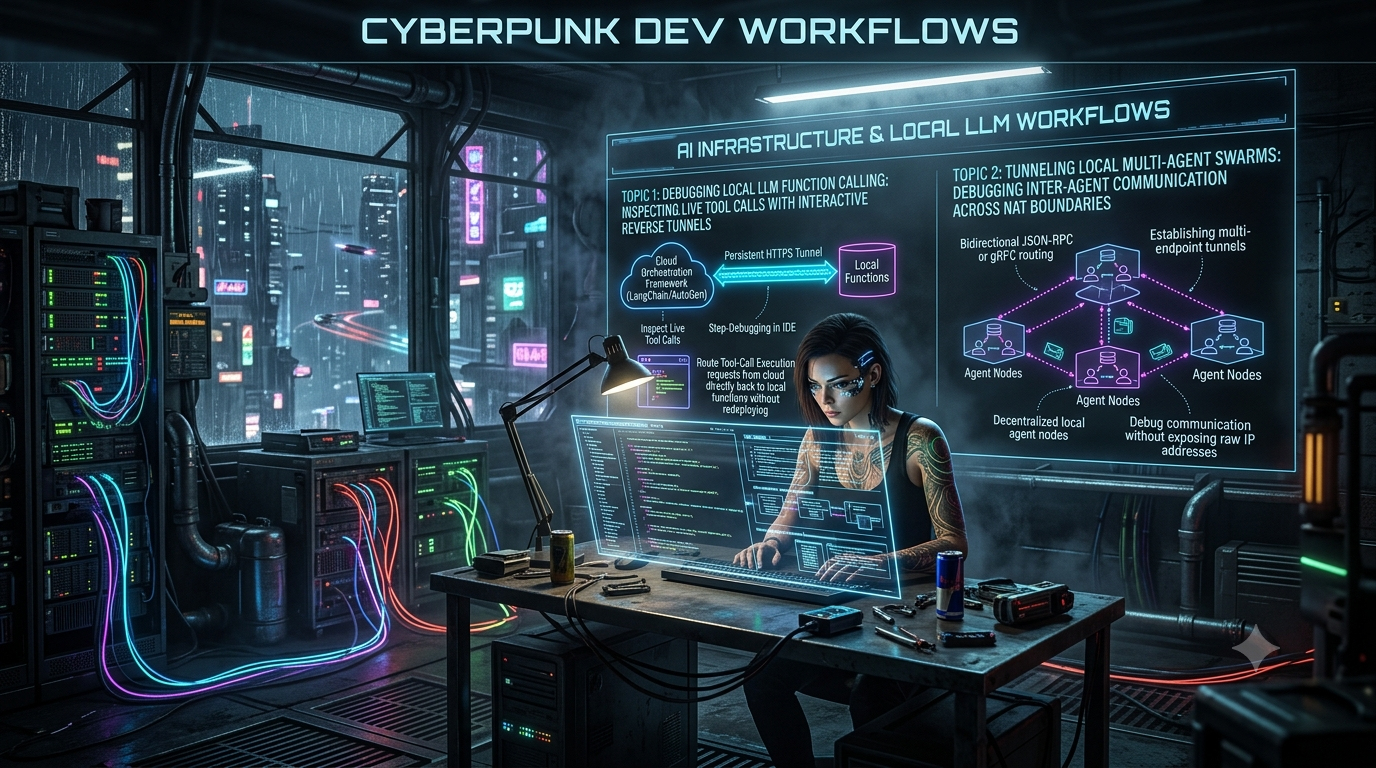
Routage des appels d'outils cloud vers votre IDE local via des tunnels inverses. Déboguez étape par étape les fonctions LangChain e0 AutoGen en direct sans redéploiement. ### Sujet 2 : Tunneling d'essaims multi-agents locaux
Quick answer
### Sujet 1 : Débogage des appels de fonctions LLM locaux: localhost tunnel answer
A localhost tunnel gives your local app a public HTTPS URL without opening router ports, which is useful for demos, QA, mobile testing, and provider callbacks.
How do I expose localhost without opening ports?
Use a reverse HTTPS tunnel. Your machine connects outbound to the tunnel service, and the public URL forwards requests back to your local app.
When should I use a localhost tunnel?
Use one for webhook testing, OAuth callbacks, client demos, QA previews, mobile device checks, and short-lived development reviews.
La rapide évolution des orchestrations LLM — allant de simples complétions par prompt unique à des essaims multi-agents complexes — a dépassé les modèles traditionnels de débogage et de réseau. Développer des systèmes IA autonomes localement introduit des frictions infrastructurelles distinctes : gestion de contextes d’exécution cloud fermés, synchronisation asynchrone d’état, et navigation dans les limites NAT/firewall locales.
Ce guide opérationnel propose deux modèles d’ingénierie approfondis conçus pour résoudre ces défis :
- Tunneling inversé interactif pour le débogage en temps réel des appels de fonctions LLM
- Orchestration décentralisée gRPC / JSON-RPC d’essaims multi-agents à travers les frontières réseau
Sujet 1 : Débogage des appels de fonctions LLM locaux : inspection en direct des appels d’outils avec tunnels inverses interactifs
Le problème d’architecture : le décalage cloud-vers-local
Lors de la construction d’applications agentiques avec des modèles de langage de grande taille hébergés dans le cloud (par ex., OpenAI GPT-4o, Anthropic Claude 3.5 Sonnet, ou instances DeepSeek hébergées) via des couches d’orchestration comme LangChain, LlamaIndex, ou AutoGen, les appels d’outils (appel de fonctions) s’exécutent dans une boucle découplée en deux étapes :
- Phase d’inférence : le client envoie le contexte du prompt et les définitions de schéma JSON des outils au LLM cloud.
- Phase d’exécution : le LLM cloud émet une charge utile structurée
tool_callscontenant les signatures de fonctions et les arguments analysés. Le client d’orchestration reçoit cette charge et doit exécuter la fonction cible avant de renvoyer le résultat au LLM.┌─────────────────┐ 1. Prompt + Schéma d'outil ┌─────────────────┐ │ │ ──────────────────────────────────e0e9> │ │ │ API LLM cloud │ │ Application / │ │ (Modèle hébergé)│ e0e9<────────────────────────────────── │ Orchestrateur │ │ │ 2. Sortie : JSON tool_calls └────────┬────────┘ └─────────────────┘ │ │ 3. Exécution locale ▼ ┌─────────────────┐ │ Fonction locale │ │ (Débogueur IDE) │ └─────────────────┘
Où se situe la friction de développement
Lorsque l’exécution des outils est déléguée à des webhooks externes, des sandbox cloud ou des nœuds d’agents distants, les développeurs rencontrent de fortes frictions :
- Mismatches silencieux de schéma : le LLM génère des arguments qui échouent à la validation Pydantic localement, abortant sans logs d’exécution détaillés.
- Exécution opaque : le débogage par impression ou les journaux statiques masquent les mutations exactes des paramètres, les mises à jour d’état et la latence réseau lors de l’exécution des outils.
- Latence de redéploiement : les modifications de code des outils locaux nécessitent des reconstructions de conteneurs continues ou des déploiements serverless juste pour tester un seul paramètre de cas limite.
Architecture de tunneling inversé pour l’exécution d’outils en direct
Au lieu de déployer du code local dans des environnements de staging pour recevoir des exécutions webhook entrantes, les développeurs peuvent exposer leur environnement d’exécution local à Internet en utilisant des Tunnels TLS inverses persistants (avec des outils comme ngrok, Cloudflare Tunnels ou devtunnel).
En routant les rappels d’exécution d’orchestration externes via un tunnel crypté directement vers un serveur de développement local tournant sur localhost, les développeurs peuvent placer des points d’arrêt dans leurs IDE Python ou TypeScript (VS Code / PyCharm) et inspecter les frames de pile en direct pendant que le LLM déclenche les outils en temps réel.
┌────────────────────────────────────────────────────────────────────────┐
│ INTERNET PUBLIC / CLOUD                                                  │
│                                                                          │
│   ┌────────────────────────┐            ┌──────────────────────────┐   │
│   │ Orchestration cloud /  │            │ Passerelle Tunnel inversé│   │
│   │ Nœud agent distant     │            │ (ex. ngrok / Cloudflare) │   │
│   └───────────┬────────────┘            └────────────▲─────────────┘   │
└───────────────│──────────────────────────────────────│─────────────────┘
                │ Webhook POST HTTP                     │
                │ https://agent-dev.ngrok.app/execute   │ Tunnel TLS persistant
                └──────────────────────────────────────┼─
                                                       │
┌──────────────────────────────────────────────────────│─────────────────┐
│ ENVIRONNEMENT DE DÉVELOPPEMENT LOCAL                  │                 │
│                                                      │                 │
│   ┌────────────────────────┐            ┌────────────┴─────────────┐   │
│   │ IDE local (Débogueur)  │ ◄───────── │ Daemon client tunnel   │   │
│   │ (Points d'arrêt, état)  │ Localhost │ (localhost:8000)        │   │
│   └────────────────────────┘            └────────────────────────┘   │
└────────────────────────────────────────────────────────────────────────┘
Mise en place étape par étape
Étape 1 : Configurer le tunnel TLS persistant
Initialiser un tunnel inversé sécurisé ciblant le port de votre serveur d’outils local (ex. 8000).
# Avec ngrok pour ouvrir un tunnel HTTP persistant avec conservation de l'en-tête hôte
ngrok http 8000 --domain=agent-dev-environment.ngrok.app

# Alternativement avec la CLI devtunnel de Microsoft
devtunnel host -p 8000 --allow-anonymous
Étape 2 : Implémenter le serveur d’outils avec capacités de points d’arrêt
Voici une implémentation complète en FastAPI exposant une interface d’outils extensible pour exécuter des fonctions locales demandées par le modèle orchestré dans le cloud.
# tool_server.py
import uvicorn
from fastapi import FastAPI, HTTPException, Request
from pydantic import BaseModel, Field
from typing import Any, Dict

app = FastAPI(title="Pont de débogage d'outils locaux")

# Schéma de charge utile d'outil d'exemple
class ToolExecutionRequest(BaseModel):
    call_id: str
    tool_name: str
    arguments: Dict[str, Any]

class ToolExecutionResponse(BaseModel):
    call_id: str
    status: str
    result: Any

# Fonction métier d'exemple à déboguer
def calculate_database_query(query: str, limit: int) -> dict:
    # 🔴 POINT D'ARRÊT IDE À FIXER
    # Inspecter 'query' et 'limit' en direct depuis le cloud
    processed_query = query.strip().lower()

    if limit > 100:
        # Corriger les arguments hallucines du LLM en temps réel
        limit = 100

    return {
        "status": "success",
        "rows_returned": limit,
        "executed_query": processed_query
    }

REGISTERED_TOOLS = {
    "calculate_database_query": calculate_database_query
}

@app.post("/execute-tool", response_model=ToolExecutionResponse)
async def handle_tool_call(payload: ToolExecutionRequest):
    """
    Point d'entrée webhook invoqué par l'orchestrateur cloud via Tunnel inversé.
    """
    print(f"\n[APPEL OUTIL ENTRANT] ID : {payload.call_id} | Outil : {payload.tool_name}")
    print(f"[ARGUMENTS] : {payload.arguments}")

    if payload.tool_name not in REGISTERED_TOOLS:
        raise HTTPException(status_code=404, detail=f"Outil '{payload.tool_name}' non enregistré localement.")

    # Appel direct pour débogage en IDE en direct
    target_function = REGISTERED_TOOLS[payload.tool_name]

    try:
        # Déballage dynamique des arguments fournis par le LLM
        execution_result = target_function(**payload.arguments)

        return ToolExecutionResponse(
            call_id=payload.call_id,
            status="terminé",
            result=execution_result
        )
    except TypeError as e:
        # Identification immédiate des erreurs de schéma
        print(f"[ERREUR SCHÉMA] Arguments invalides passés par le LLM : {str(e)}")
        raise HTTPException(status_code=422, detail=f"Mismatch d'arguments : {str(e)}")

if __name__ == "__main__":
    # Lancer le serveur local
    uvicorn.run("tool_server:app", host="127.0.0.1", port=8000, reload=True)
Étape 3 : Configurer le client de l’orchestrateur cloud
Configurer l’application cliente pour pointer les rappels d’exécution d’outils vers l’URL du tunnel inversé plutôt que vers l’exécution interne.
# orchestrator_client.py
import requests
from langchain_openai import ChatOpenAI
from langchain_core.messages import HumanMessage, ToolMessage

TUNNEL_URL = "https://agent-dev-environment.ngrok.app/execute-tool"

# Initialiser le modèle
llm = ChatOpenAI(model="gpt-4o", temperature=0)

# Définir le schéma d'outil accessible au modèle
tools = [{
    "type": "function",
    "function": {
        "name": "calculate_database_query",
        "description": "Exécute une requête structurée contre la base locale.",
        "parameters": {
            "type": "object",
            "properties": {
                "query": {"type": "string", "description": "Requête SQL"},
                "limit": {"type": "integer", "description": "Nombre maximum de lignes"}
            },
            "required": ["query", "limit"]
        }
    }
}]

# Premier appel du modèle
messages = [HumanMessage(content="Lancer une requête pour les utilisateurs actifs avec limite 50.")]
response = llm.invoke(messages, tools=tools)

# Traiter les appels de fonction retournés par le modèle
if response.tool_calls:
    for tool_call in response.tool_calls:
        print(f"Routage de l'appel d'outil '{tool_call['name']}' via tunnel inversé...")

        # Envoyer la requête d'exécution à travers le tunnel vers IDE local
        webhook_payload = {
            "call_id": tool_call["id"],
            "tool_name": tool_call["name"],
            "arguments": tool_call["args"]
        }

        tunnel_response = requests.post(TUNNEL_URL, json=webhook_payload)
        tool_result = tunnel_response.json()

        print(f"Résultat local reçu : {tool_result}")
Techniques avancées d’inspection
1. Inspection des en-têtes et charges utiles
Les utilitaires de tunnel inversé exposent des tableaux de bord Web UI locaux (ex. [http://127.0.0.1:4040](http://127.0.0.1:4040) pour ngrok). Les développeurs peuvent inspecter les en-têtes HTTP bruts, détecter des erreurs de sérialisation JSON, et utiliser des actions Rejouer en un clic pour relancer les échecs d’exécution d’outils via des points d’arrêt locaux sans relancer toute la génération LLM.
2. Points d’arrêt conditionnels
Configurer des points d’arrêt conditionnels dans votre IDE en fonction des propriétés d’exécution du LLM :
# Condition de point d'arrêt conditionnel en IDE Python
len(payload.arguments.get("query", "")) > 100 or payload.arguments.get("limit") is None
Ces conditions isolent les cas limites où le LLM génère des arguments malformés sous de longues conditions de contexte.
3. Sécurité d’entreprise et contrôle d’accès
Lors du tunneling des endpoints locaux, appliquer des contrôles de sécurité stricts pour éviter l’accès public :
- Mutual TLS (mTLS) : Valider les certificats client au niveau du tunnel
- Signatures d’en-tête : Vérifier les en-têtes HMAC (
X-Signature-SHA256) envoyés par les endpoints d’orchestration pour garantir que les requêtes proviennent exclusivement de services cloud autorisés.
Sujet 2 : Tunneling d’essaims multi-agents locaux : débogage de la communication inter-agent à travers NAT
Le goulot d’étranglement réseau dans les architectures décentralisées
À mesure que la conception agentique évolue vers des essaims multi-agents hétérogènes (tels que AutoGen/AG2, CrewAI, ou implémentations personnalisées A2A / Protocoles de contexte de modèle), chaque agent spécialisé est de plus en plus distribué dans différents environnements :
- Agent A (Planificateur) : Fonctionne dans un VPC AWS d’entreprise.
- Agent B (Interprète de code) : Fonctionne dans un conteneur Docker local derrière NAT.
- Agent C (Contrôleur matériel) : Fonctionne sur un dispositif edge (ex. Raspberry Pi ou NVIDIA Jetson) derrière un pare-feu cellulaire restreint.
┌─────────────────────────────────────────────────────────────────────────────┐
│ VPC d'entreprise (AWS)                                                      │
│                                                                             │
│   ┌─────────────────────────────────────────────────────────────────────┐   │
│   │ Agent A (Superviseur / Coordinateur)                               │   │
│   └──────────────────────────────────┬──────────────────────────────────┘   │
└──────────────────────────────────────│──────────────────────────────────────┘
                                   │
 ❌ IMPOSSIBLE DE ROUTER DIRECTEMENT SUR INTERNET PUBLIC (PAS D'IP PUBLIQUE)
                                   │
┌──────────────────────────────────────┴──────────────────────────────────────┐
│ BUREAU / POSTE LOCAL (DERRIÈRE NAT ET FIREWALLS)                              │
│                                                                             │
│   ┌────────────────────────────────┐     ┌──────────────────────────────┐   │
│   │ Agent B (Docker sandbox)       │     │ Agent C (Edge sensor)        │   │
│   │ IP : 172.18.0.2 (Privé)        │     │ IP : 192.168.1.45 (Privé)   │   │
│   └────────────────────────────────┘     └──────────────────────────────┘   │
└─────────────────────────────────────────────────────────────────────────────┘
Défi infrastructurel
Les protocoles réseau standards échouent dans ces topologies :
- NAT symétriques et firewalls stricts : bloquent les connexions entrantes vers les nœuds d’agents locaux, empêchant l’invocation peer-to-peer.
- Adresses IP dynamiques : empêchent la configuration statique des points d’extrémité des agents.
- Latence élevée entre agents : le polling HTTP REST traditionnel ajoute une latence prohibitive pour des négociations complexes nécessitant des centaines d’échanges.
Matrice de sélection de protocole : gRPC vs. JSON-RPC sur maillage de tunnels
Lors du choix d’une couche de communication pour des essaims décentralisés, le choix du transport influence fortement le débit, la rigueur du schéma, et l’efficacité du streaming.
| Attribut architectural | JSON-RPC 2.0 sur WebSocket HTTP/2 | gRPC sur Tunnel HTTP/2 |
|---|---|---|
| Format de charge utile | JSON texte lisible | Protocol Buffers binaire (compression élevée) |
| Application du schéma | Dynamique / Runtime (Pydantic / Zod) | Statique / Compilation (.proto) |
| Capacité de streaming | Duplex complet via WebSockets / SSE | Streaming bidirectionnel natif |
| Profil de latence | Modéré (surcharge de parsing) | Ultra-faible (sérialisation sans copie) |
| Compatibilité NAT | Léger, facile à déboguer via web | Efficacité exceptionnelle sur TCP multiplexé |
| Flux de travail idéal | Essaims de texte ad-hoc, schémas JSON flexibles | Essaims de capteurs à haute fréquence, streaming multi-modale |
Implémentation d’une topologie multi-point avec WireGuard / Tunnel
Pour permettre un routage inter-agent fluide à travers NAT sans IP publiques, déployez un réseau overlay crypté avec WireGuard, Tailscale, ou Passerelles P2P de tunnels inversés.
                         ┌─────────────────────────┐
                         │   Nœud relais (public)  │
                         │   (Overlay réseau)      │
                         └────────────▲────────────┘
                                      │
            ┌─────────────────────────┴─────────────────────────┐
            │ Tunnel WireGuard / overlay (UDP crypté)             │
            └────────────▲─────────────────────────▲────────────┘
                         │                         │
     ┌───────────────────┴──────────┐   ┌──────────┴───────────────────┐
     │ Nœud 1 : Orchestrateur cloud│   │ Nœud 2 : Edge local dev   │
     │ IP mesh : 10.0.0.1          │   │ IP mesh : 10.0.0.2        │
     │ (Agent superviseur)         │   │ (Agent worker conteneur)  │
     └──────────────────────────────┘   └──────────────────────────────┘
Mise en œuvre en production : communication asynchrone JSON-RPC 2.0 entre agents
Voici une implémentation complète d’un système multi-agent décentralisé s’exécutant sur des conteneurs locaux via un maillage JSON-RPC tunnelé.
1. Définition du protocole JSON-RPC & agent de base (agent_protocol.py)
# agent_protocol.py
import json
from typing import Any, Dict, Optional
from pydantic import BaseModel, Field

class JSONRPCRequest(BaseModel):
    jsonrpc: str = "2.0"
    method: str
    params: Dict[str, Any]
    id: str

class JSONRPCResponse(BaseModel):
    jsonrpc: str = "2.0"
    result: Optional[Any] = None
    error: Optional[Dict[str, Any]] = None
    id: str

class AgentCapability(BaseModel):
    agent_id: str
    description: str
    methods: list[str]
2. Implémentation de l’agent local (local_worker_agent.py)
Cet agent tourne dans un réseau privé local, exposant ses capacités via un tunnel crypté.
# local_worker_agent.py
import asyncio
from fastapi import FastAPI, WebSocket, WebSocketDisconnect
from agent_protocol import JSONRPCRequest, JSONRPCResponse
import uvicorn

app = FastAPI(title="Nœud d'agent local")

async def execute_code_analysis(code: str) -> dict:
    """Simule une tâche d'analyse de code locale sécurisée."""
    await asyncio.sleep(0.5)  # Simulation du traitement
    return {
        "complexity_score": 4,
        "vulnerabilities_found": 0,
        "suggestion": "Optimiser la boucle à la ligne 12."
    }

@app.websocket("/ws/rpc")
async def websocket_rpc_endpoint(websocket: WebSocket):
    await websocket.accept()
    print("[RÉSEAU] Agent cloud connecté à l'interface RPC de l'agent local.")

    try:
        while True:
            # Réception de la requête RPC brute
            raw_data = await websocket.receive_text()
            request_data = JSONRPCRequest.model_validate_json(raw_data)

            print(f"[REQUÊTE RPC] Méthode : {request_data.method}")

            # Dispatch de la méthode
            if request_data.method == "analyze_code":
                code_param = request_data.params.get("code", "")
                output = await execute_code_analysis(code_param)

                response = JSONRPCResponse(
                    result=output,
                    id=request_data.id
                )
            else:
                response = JSONRPCResponse(
                    error={"code": -32601, "message": "Méthode non trouvée"},
                    id=request_data.id
                )

            # Envoi de la réponse RPC via WebSocket
            await websocket.send_text(response.model_dump_json())

    except WebSocketDisconnect:
        print("[RÉSEAU] Déconnexion du nœud de l'essaim.")

if __name__ == "__main__":
    # Serveur local, exposé via tunnel
    uvicorn.run(app, host="0.0.0.0", port=9001)
3. Agent superviseur cloud (cloud_supervisor.py)
Cet agent orchestre les flux en routant les commandes RPC via le maillage vers l’IP de l’agent local ou son alias tunnelé.
# cloud_supervisor.py
import asyncio
import websockets
import uuid
from agent_protocol import JSONRPCRequest, JSONRPCResponse

# Endpoint du tunnel sécurisé (ex. Tailscale/WireGuard)
NŒUD_LOCAL_TUNNEL = "ws://10.0.0.2:9001/ws/rpc"

async def dispatch_task(method: str, params: dict):
    request_id = str(uuid.uuid4())
    rpc_request = JSONRPCRequest(
        method=method,
        params=params,
        id=request_id
    )
    print(f"[SUPERVISEUR] Connexion au nœud local via {NŒUD_LOCAL_TUNNEL}...")
    async with websockets.connect(NŒUD_LOCAL_TUNNEL) as ws:
        # Envoyer la requête RPC
        await ws.send(rpc_request.model_dump_json())
        print(f"[SUPERVISEUR] Appel de '{method}' [ID : {request_id}]")
        # Attendre la réponse
        raw_response = await ws.recv()
        response = JSONRPCResponse.model_validate_json(raw_response)
        if response.error:
            print(f"[ERREUR RPC] Code {response.error['code']}: {response.error['message']}")
        else:
            print(f"[SUCCÈS RPC] Résultat : {response.result}")

if __name__ == "__main__":
    # Exemple d'orchestration
    code_sample = "def fibonacci(n):\n    return n if n <= 1 else fibonacci(n-1) + fibonacci(n-2)"
    asyncio.run(dispatch_task("analyze_code", {"code": code_sample}))
Observabilité, traçage, et stratégies de maintien de NAT
1. Propagation du contexte OpenTelemetry
Lorsqu’Agent A invoque Agent B via JSON-RPC, le contexte de trace doit traverser la frontière réseau. Inclure l’en-tête traceparent dans la charge RPC :
{
  "jsonrpc": "2.0",
  "method": "analyze_code",
  "params": {
    "code": "...",
    "_telemetry_context": {
      "traceparent": "00-4bf92f3577b34da6a3ce929d0e0e4736-00f067aa0ba902b7-01"
    }
  },
  "id": "req-001"
}
Cela permet aux outils de traçage distribué (comme Jaeger, Honeycomb, ou LangSmith) de visualiser les arbres d’exécution de bout en bout.
2. Keep-alives NAT
Les firewalls coupent les connexions TCP inactives après 30-120 secondes. Pour maintenir les tunnels actifs :
- Keepalives TCP : configurer
SO_KEEPALIVEavecTCP_KEEPIDLE=30 - Ping applicatif : envoyer des pings toutes les 15 secondes dans WebSocket ou gRPC
# WebSocket client avec keepalive
async with websockets.connect(endpoint, ping_interval=15, ping_timeout=10):
    ...
3. Re-routage automatique et failover
En production, si un agent local perd la connectivité, le circuit du superviseur doit rerouter vers un agent de secours ou une file d’attente cloud.
# Exemple de circuit breaker
try:
    await dispatch_task(...)
except (websockets.exceptions.ConnectionClosedError, TimeoutError):
    print("[CIRCUIT] Agent local hors ligne. Reroutage vers le cloud...")
    await dispatch_task_to_cloud_fallback(...)
Conclusion & checklist d’architecture
Construire une infrastructure locale-cloud et multi-agent résiliente nécessite de passer d’une conception statique à des architectures modernes conscientes des tunnels :
- [x] Pour l’appel de fonctions : utiliser des tunnels TLS inverses (
ngrok,devtunnel) pour faire revenir l’exécution cloud vers des serveurs locaux avec points d’arrêt. - [x] Pour les réseaux d’agents : exploiter des transports structurés (JSON-RPC ou gRPC sur HTTP/2) sur des réseaux maillés privés (WireGuard, Tailscale) pour contourner NAT.
- [x] Pour l’observabilité : propager les contextes de trace pour garder la visibilité sur l’exécution distribuée.
Related InstaTunnel pages
Continue from this article into the most relevant product guides and workflows.
Related Topics
Keep building with InstaTunnel
Read the docs for implementation details or compare plans before you ship.