Tunneling haute performance en périphérie : Zero-Copy I/O, traversée NAT et architecture QUIC 0-RTT
Maîtrisez l'optimisation des tunnels de bas niveau. Découvrez comment Linux splice/vmsplice, le hole punching UDP, PCP et QUIC 0-RTT réduisent la latence et éliminent la surcharge CPU.
Quick answer
Tunnels locaux haute performance : Zero-Copy, CGNAT & QUIC: localhost tunnel answer
A localhost tunnel gives your local app a public HTTPS URL without opening router ports, which is useful for demos, QA, mobile testing, and provider callbacks.
How do I expose localhost without opening ports?
Use a reverse HTTPS tunnel. Your machine connects outbound to the tunnel service, and the public URL forwards requests back to your local app.
When should I use a localhost tunnel?
Use one for webhook testing, OAuth callbacks, client demos, QA previews, mobile device checks, and short-lived development reviews.
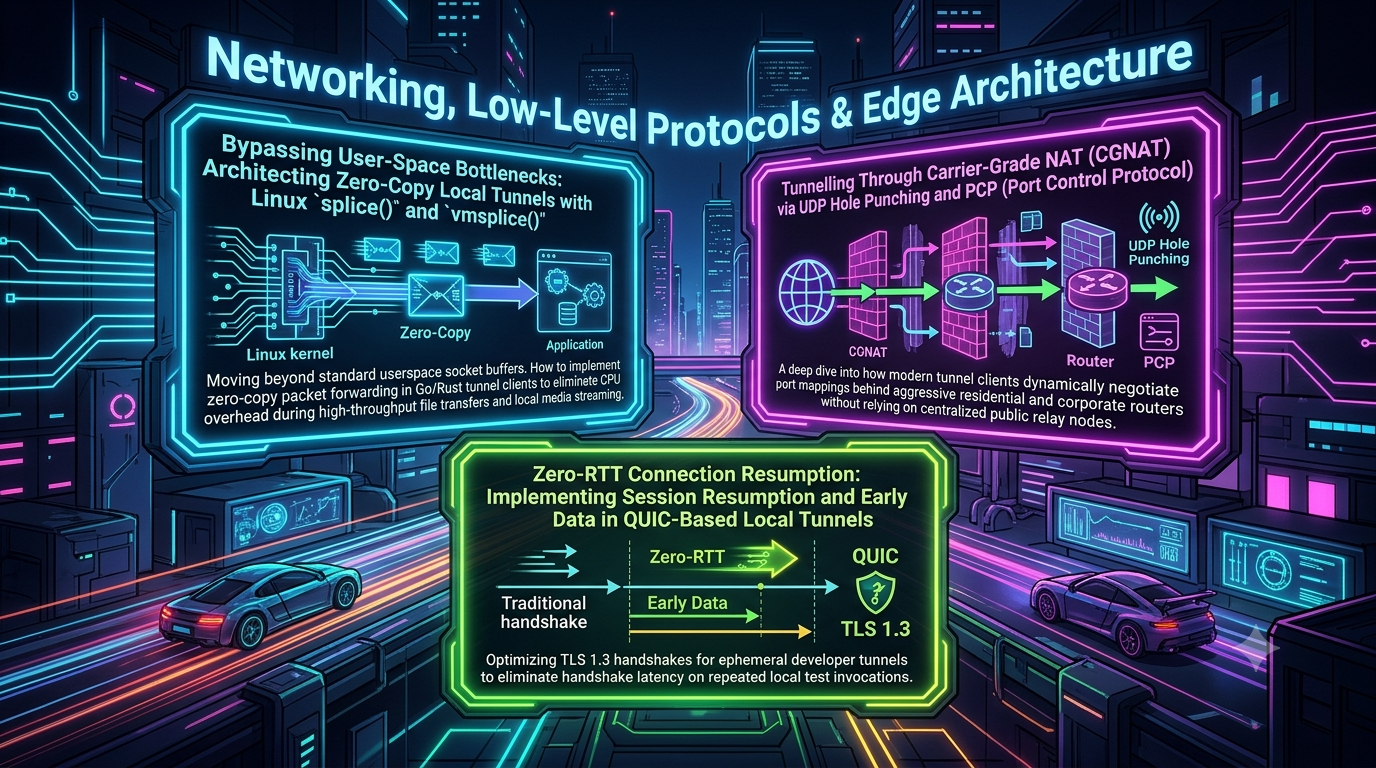
Construire un client de tunnel rapide et résilient implique de contourner les limites à trois niveaux distincts :
- Surcharge kernel-vers-utilisateur : chaque octet qu’un proxy transfère est copié deux fois à la frontière kernel/utilisateur, et chaque fragment coûte deux appels système.
- Topologie réseau : NATs durs (dépendants des points d’extrémité) et Carrier-Grade NAT (CGNAT) entravent les chemins peer-to-peer directs.
- Latence de transport : une nouvelle connexion TCP + TLS dépense des aller-retours pour la poignée de main avant de pouvoir envoyer le premier octet de requête, ce qui nuit aux requêtes courtes.
Ce guide couvre les primitives kernel, protocoles et compromis de conception pour chaque couche. Il indique aussi où chaque technique cesse d’être utile, car les trois couches interagissent de manière à faciliter les erreurs. Chaque exemple de code ci-dessous a été compilé et exécuté, soit contre un test d’écho en boucle locale, soit contre un serveur simulé.
Partie 1 : Réduire la copie en espace utilisateur avec splice()
Un forwarder classique en espace utilisateur lit depuis une socket dans un tampon applicatif, puis écrit ce tampon dans une autre socket :
[ Forwarding traditionnel ]
Kernel : [ Buffer de réception Socket A ] --read()--> (copie) --+
                                                       v
Utilisateur :                              [ Buffer applicatif ]
                                                       |
Kernel : [ Buffer d’envoi Socket B ] <--write()-- (copie) -+
Pour les transferts en masse, cela coûte deux copies par fragment, deux appels système par fragment, et un tampon utilisateur qui concurrence le cache CPU avec le reste du programme.
Ce que fait splice()
Selon la page de manuel Linux, splice() déplace des données entre deux descripteurs de fichiers sans copier entre l’espace d’adressage kernel et utilisateur. Au moins un doit être un pipe. La fonction existe dans Linux depuis la version 2.6.17, et depuis 2.6.31, les deux descripteurs peuvent être des pipes. Avec vmsplice(2) et tee(2), elle donne à un programme un contrôle sur un buffer kernel implémenté avec le même type de buffer utilisé pour les pipes.
[ Pipeline de splice ]
Kernel : [ Socket A ] --splice---> [ Buffer pipe ] --splice---> [ Socket B ]
Utilisateur : (aucun octet de charge utile visible ici)
La signature :
#define _GNU_SOURCE
#include <fcntl.h>

ssize_t splice(int fd_in, loff_t *off_in,
               int fd_out, loff_t *off_out,
               size_t len, unsigned int flags);
Trois détails sont souvent mal compris :
SPLICE_F_MOVEne sert à rien sur les noyaux modernes. La page de manuel indique que l’implémentation originale était buggy, donc depuis Linux 2.6.21, ce drapeau est accepté mais ne fait rien. Ne comptez pas dessus pour déplacer des pages.SPLICE_F_NONBLOCKrend le côté pipe non bloquant. L’appel peut quand même bloquer si l’autre descripteur est une socket bloquante, donc il faut aussi définirO_NONBLOCKsur les sockets.SPLICE_F_MOREindique qu’il y a plus de données à suivre dans un prochainsplice(), utile pour la branche pipe-vers-socket.
“Pas de copie en espace utilisateur” ne signifie pas “zéro copie partout”. La page de manuel ne promet que la première.
Où vmsplice() s’insère (et où il ne le fait pas)
vmsplice(2) connecte la mémoire utilisateur à un pipe. Lorsqu’on écrit dans le pipe, il mappe vos plages mémoire dans le pipe. Lorsqu’on lit, il copie réellement les données dans vos buffers. Cela concerne quand votre propre code produit des données (par exemple, une trame pré-construite), pas pour le forwarding socket-à-socket, où rien ne doit toucher l’espace utilisateur.
L’avertissement : comme le pipe mappe vos pages plutôt que de les copier, il ne faut pas modifier cette mémoire tant que le kernel ne l’a pas consommée. SPLICE_F_GIFT va plus loin en déclarant que les pages données au kernel sont bonnes, et l’application doit les traiter comme en lecture seule. Il faut aussi des adresses et longueurs alignées sur la page.
Quand splice aide, et quand il ne peut pas
Splice ne s’applique que lorsque le tunnel transfère des octets qu’il n’a pas besoin de lire ou de transformer :
- Forwarding TCP-to-TCP simple (un tunnel TCP transportant un flux opaque, ou un chemin TLS pass-through) : splice convient.
- TLS en espace utilisateur, ou QUIC : l’application doit voir le texte clair pour le chiffrer ou le déchiffrer, donc splice ne peut pas aider. Le déchargement TLS du kernel (kTLS) peut réduire cet écart pour TCP : sa documentation décrit le support de
sendfilesur le chemin de transmission, permettant au texte clair d’atteindre une socket TLS sans copie utilisateur. - QUIC et autres protocoles UDP : ils ne peuvent pas utiliser splice, donc on se limite à la batchisation. La bibliothèque QUICHE de Google, par exemple, utilise UDP GSO (
UDP_SEGMENT) pour que unsendmsgtransporte plusieurs segments, etsendmmsgpour batcher plusieurs paquets (source QUICHE). - io_uring expose aussi splice via
io_uring_prep_splice(3), utile si vous utilisez déjà une boucle basée sur la complétion.
Go : privilégier la bibliothèque standard, faire du sur-mesure uniquement pour l’optimisation
Le package net de Go utilise déjà splice sur Linux. Lorsqu’un *net.TCPConn est la source d’un io.Copy vers une autre connexion TCP, le runtime utilise une voie splice en interne, et revient à une copie classique si ce n’est pas applicable (net/splice_linux.go). Pour la plupart des proxies, io.Copy(dst, src) entre deux *net.TCPConn est la bonne solution.
Une version écrite à la main ne vaut la peine que si vous souhaitez contrôler ce que la stdlib ne permet pas, comme la taille du pipe, la taille des fragments ou la comptabilité par connexion. La version ci-dessous s’intègre avec le netpoller de Go via syscall.RawConn, pour que toute opération bloquante mette la goroutine en attente plutôt que de tourner en boucle :
//go:build linux

package main

import (
	"errors"
	"fmt"
	"net"

	"golang.org/x/sys/unix"
)

// SplicePipe est un pipe kernel utilisé comme tampon entre deux sockets.
type SplicePipe struct{ r, w int }

// NewSplicePipe crée un pipe non bloquant et le redimensionne. Les processus non privilégiés
// sont limités par /proc/sys/fs/pipe-max-size (par défaut 1 MiB).
func NewSplicePipe(size int) (*SplicePipe, error) {
	var fds [2]int
	if err := unix.Pipe2(fds[:], unix.O_CLOEXEC|unix.O_NONBLOCK); err != nil {
		return nil, fmt.Errorf("pipe2: %w", err)
	}
	if _, err := unix.FcntlInt(uintptr(fds[0]), unix.F_SETPIPE_SZ, size); err != nil {
		unix.Close(fds[0])
		unix.Close(fds[1])
		return nil, fmt.Errorf("F_SETPIPE_SZ(%d): %w", size, err)
	}
	return &SplicePipe{r: fds[0], w: fds[1]}, nil
}

func (p *SplicePipe) Close() { unix.Close(p.r); unix.Close(p.w) }

// Copy déplace des octets de src vers dst jusqu’à EOF de src.
func (p *SplicePipe) Copy(dst, src *net.TCPConn, chunk int) (int64, error) {
	srcRC, err := src.SyscallConn()
	if err != nil {
		return 0, err
	}
	dstRC, err := dst.SyscallConn()
	if err != nil {
		return 0, err
	}

	var total int64
	for {
		// Étape 1 : socket -e0 pipe.
		var n int64
		var serr error
		rerr := srcRC.Read(func(fd uintptr) bool {
			for {
				n, serr = unix.Splice(int(fd), nil, p.w, nil, chunk, unix.SPLICE_F_NONBLOCK)
				if serr != unix.EINTR {
					break
				}
			}
			// false =e0 l’exécution attend que la socket soit lisible, puis réessaye
			return !errors.Is(serr, unix.EAGAIN)
		})
		if rerr != nil {
			return total, rerr
		}
		if serr != nil {
			return total, fmt.Errorf("splice socket-e0 pipe : %w", serr)
		}
		if n == 0 {
			return total, nil // EOF
		}

		// Étape 2 : pipe -e0 socket. Évacuer tout ce qui a été mis en mémoire.
		for left := n; left > 0; {
			var w int64
			werr := dstRC.Write(func(fd uintptr) bool {
				for {
					w, serr = unix.Splice(p.r, nil, int(fd), nil, int(left),
						unix.SPLICE_F_NONBLOCK|unix.SPLICE_F_MORE)
					if serr != unix.EINTR {
						break
					}
				}
				return !errors.Is(serr, unix.EAGAIN)
			})
			if werr != nil {
				return total, werr
			}
			if serr != nil {
				return total, fmt.Errorf("splice pipe-e0 socket : %w", serr)
			}
			left -= w
			total += w
		}
	}
}
Utilisez un pipe par direction par connexion. Quand Copy se termine, appelez dst.CloseWrite() pour que le EOF se propage en demi-close. Un payload aléatoire de 64 MiB envoyé via une boucle locale en deux étapes avec ce code est revenu identique octet par octet.
Rust : splice dans une boucle d’événements Tokio
En Rust, la crate nix encapsule splice, mais ses splice et SpliceFFlags sont derrière la fonctionnalité Cargo zerocopy (le code ci-dessous a été construit avec nix 0.30). tokio::net::TcpStream::async_io est la façon propre d’exécuter un syscall brut sous sa gestion de la disponibilité : si la closure retourne WouldBlock, Tokio vide la disponibilité et attend à nouveau.
[dependencies]
nix   = { version = "0.30", features = ["fs", "zerocopy"] }
tokio = { version = "1", features = ["rt-multi-thread", "net", "macros", "io-util"] }
use std::io;
use std::os::fd::OwnedFd;

use nix::fcntl::{fcntl, splice, FcntlArg, OFlag, SpliceFFlags};
use nix::unistd::pipe2;
use tokio::io::Interest;
use tokio::net::TcpStream;

/// Un pipe kernel utilisé comme tampon entre deux sockets.
pub struct SplicePipe {
    r: OwnedFd,
    w: OwnedFd,
}

impl SplicePipe {
    pub fn new(size: i32) -> io::Result<Self> {
        let (r, w) = pipe2(OFlag::O_CLOEXEC | OFlag::O_NONBLOCK)?;
        fcntl(&w, FcntlArg::F_SETPIPE_SZ(size))?;
        Ok(Self { r, w })
    }

    /// Déplacer des octets de `src` vers `dst` jusqu’à EOF de `src`.
    pub async fn forward(&self, src: &TcpStream, dst: &TcpStream, chunk: usize) -> io::Result<u64> {
        let mut total = 0u64;
        loop {
            // socket -e0 pipe (EAGAIN devient WouldBlock, donc Tokio attend)
            let n = src
                .async_io(Interest::READABLE, || {
                    splice(src, None, &self.w, None, chunk, SpliceFFlags::SPLICE_F_NONBLOCK)
                        .map_err(io::Error::from)
                })
                .await?;
            if n == 0 {
                return Ok(total); // EOF
            }

            // pipe -e0 socket : évacuer tout ce qui a été mis en mémoire
            let mut left = n;
            while left > 0 {
                let w = dst
                    .async_io(Interest::WRITABLE, || {
                        splice(
                            &self.r,
                            None,
                            dst,
                            None,
                            left,
                            SpliceFFlags::SPLICE_F_NONBLOCK | SpliceFFlags::SPLICE_F_MORE,
                        )
                        .map_err(io::Error::from)
                    })
                    .await?;
                left -= w;
                total += w as u64;
            }
        }
    }
}
Enveloppez chaque TcpStream dans un Arc pour qu’une tâche puisse transférer dans chaque direction, et fermez la moitié écriture de la destination quand une direction se termine. Le même test d’écho en boucle locale de 64 MiB a réussi avec ce code.
Conseils pratiques
- Mesurez sur votre charge de travail. Splice supprime la copie en espace utilisateur et la paire d’appels système par fragment, mais ajoute la gestion du pipe et (dans cette conception) un second appel système par fragment, donc les petits messages ou flux fortement transformés peuvent ne pas en bénéficier.
- La capacité par défaut du pipe est de 64 KiB. La faire augmenter avec
F_SETPIPE_SZest un levier de débit, limité par/proc/sys/fs/pipe-max-sizepour les processus non privilégiés. - Linux uniquement : splice est spécifique à Linux, gardez une solution de secours portable (
io.Copy,tokio::io::copy) pour les autres plateformes.
Partie 2 : Traverser NAT et CGNAT
Pourquoi le carrier-grade NAT est différent
La plupart des routeurs domestiques effectuent une couche de NAT. En CGNAT, l’ISP ajoute une seconde couche. RFC 6598 (BCP 153) réserve 100.64.0.0/10 comme espace d’adresses partagé pour que les fournisseurs de services numérotent les liens entre leurs appareils CGN et le matériel client. Si l’adresse WAN de votre routeur est dans cette plage, vous êtes presque certainement derrière CGNAT.
[ CGNAT : deux NAT en série ]
Laptop (192.168.1.50)
  └─e0> Routeur domestique NAT   Adresse WAN : 100.64.10.15   (espace partagé RFC 6598)
        └─e0> CGNAT ISP   adresse publique : 198.51.100.1:45210 (adresse de documentation)
              └─e0> Internet
(Les adresses 198.51.100.x et 203.0.113.x dans cet article sont réservées à la documentation, pas de vrais hôtes.)
Comportement NAT : deux propriétés indépendantes
L’ancien vocabulaire “full cone / restricted cone / port-restricted cone / symmetric” date de l’époque initiale de STUN. Les explications modernes, comme Tailscale, décrivent le comportement NAT avec deux propriétés importantes pour la traversée, et considèrent les catégories comme une approximation :
- Mapping : le port externe dépend-il de la destination ? Si non, NAT dit “facile” ; si oui, “difficile”.
- Filtrage entrant : quelles adresses distantes peuvent renvoyer des paquets via une correspondance ?
| Nom hérité | Mapping | Filtrage entrant | Traversée UDP directe |
|---|---|---|---|
| Full cone | Même port externe pour toutes les destinations | Toute hôte distant | Facile |
| Cone à restriction d’adresse | Même port externe pour toutes les destinations | Seules les IP déjà contactées | Facile une fois que chaque côté a envoyé |
| Cone à restriction de port | Même port externe pour toutes les destinations | Seules les paires IP:port déjà contactées | Facile une fois que chaque côté a envoyé |
| Symétrique | Nouveau port externe par destination | Seul l’IP:port contacté | Difficile |
Pour les chemins directs, il faut au moins un NAT “facile” d’un côté. Les routeurs domestiques sont généralement faciles, tandis que les NAT durs sont typiques en bureau ou dans le cloud.
STUN, rendez-vous et hole punching
RFC 8489 (qui remplace RFC 5389, février 2020) définit STUN comme un outil d’aide : un point d’extrémité peut l’utiliser pour connaître l’adresse et le port publics attribués par le NAT, vérifier la connectivité, et maintenir les correspondances NAT actives. La RFC précise que STUN est un outil utilisé dans une solution complète de traversée comme ICE, pas une solution autonome.
Cela corrige une simplification courante : le serveur STUN n’échange pas d’adresses entre pairs. Un canal de rendez-vous (signalisation), généralement votre plan de contrôle dans un tunnel, transporte l’observation de chaque côté vers l’autre.
- Les deux extrémités envoient des requêtes de liaison STUN et apprennent leur
ip:portpublic (ex.198.51.100.1:10050et203.0.113.8:20080). - Chacun informe le service de rendez-vous de son endpoint, qui transmet à l’autre.
- Les deux envoient des paquets UDP à l’endpoint public de l’autre en même temps. Chaque paquet sortant crée un état NAT permettant aux paquets de l’autre côté d’entrer. Le premier paquet dans une direction peut être perdu, c’est prévu.
- Une fois la communication établie, il faut continuer à envoyer des keepalive pour que les mappings ne expirent pas.
[ Hole punching UDP ]
Client A            Serveur STUN     Service de rendez-vous        Client B
|--- requête de liaison ----e0>|                 |                      |
|e0> A_pub=198.51.100.1:10050           |e0>--- requête de liaison ----|
|                     |                 |    B_pub=203.0.113.8:20080
|--- enregistrement A_pub ------------------e0>|--- B_pub -----------e0>|
|e0> B_pub ------------------------------|--- A_pub -----------e0>|
|                                                              |
|=== tentative de punch A -e0 B (peut être perdu par NAT B) =======>
|e0>=== punch B -e0 A (NAT A a maintenant un état) =======|
|e0>================ chemin UDP direct ========================>|
NAT dur : la technique du paradoxe des anniversaires, avec des chiffres réels
Quand une extrémité a un NAT dur et l’autre un NAT facile, le côté facile ne sait pas vers quel port envoyer. La méthode du paradoxe des anniversaires, expliquée par Tailscale, montre comment cela fonctionne : le côté dur ouvre plusieurs sockets (par exemple 256), chacun avec un port externe aléatoire, tandis que le côté facile probe des ports destination aléatoires. Les chiffres : avec 256 ports ouverts, environ 174 probes aléatoires donnent une chance d’environ 50% de correspondance, 256 probes donnent 64%, 1024 en donnent 98%, et 2048 en donnent 99,9%.
Quand les deux côtés ont un NAT dur, l’espace de recherche devient la paire de ports, et les chances s’effondrent. La même analyse indique qu’après 20 secondes, la réussite est d’environ 0,01%, et atteindre 99,9% nécessite environ 170 000 probes par côté (environ 28 minutes à 100 paquets/sec). L’auteur avertit aussi que la probing agressive peut saturer la table de session des petits NAT.
Conclusion pratique : les chemins NAT dur-à-dur nécessitent généralement un relais.
Protocoles de mappage de ports : utiles mais limités au NAT le plus proche
UPnP IGD, NAT-PMP et PCP permettent à un hôte de demander à sa passerelle de transférer un port. Ils suivent un modèle requête/réponse : demander à la passerelle de transférer un port WAN vers une adresse LAN, et recevoir l’adresse et le port publics attribués. La limite importante, selon la même documentation Tailscale, est qu’ils ne fonctionnent que sur le NAT le plus proche du client. En double NAT, ils ne peuvent pas atteindre le NAT extérieur, et échouent souvent. Derrière un CGNAT, une mapping UPnP ou NAT-PMP sur votre routeur domestique n’ouvre qu’un port sur le WAN 100.64.x.x, qui ne vous rend pas accessible depuis Internet.
PCP (RFC 6887) est le successeur de NAT-PMP, supporte IPv4 et IPv6, et offre des fonctionnalités utiles pour les clients de tunnel :
- Les serveurs écoutent sur UDP 5351 ; les clients sur UDP 5350 pour les messages multicast d’ANNONCE.
- La commande MAP demande une correspondance entrante. Le port et l’adresse externes suggérés sont des indices ; le serveur peut en attribuer d’autres.
- L’option
PREFER_FAILUREindique au serveur de ne pas créer de mapping alternatif si celui suggéré n’est pas disponible. Si le serveur ne peut pas respecter la demande, il renvoieCANNOT_PROVIDE_EXTERNAL(code 11). UNSUPP_VERSION(code 1) indique que le serveur ne supporte pas la version PCP utilisée.
Que PCP atteigne un CGN dépend si l’ISP exploite un serveur PCP pour ses abonnés, ce que le client ne peut pas savoir à l’avance. Considérez PCP comme une première tentative opportuniste, pas une solution de secours garantie.
Structure d’une requête MAP PCP (RFC 6887 sections 7.1 et 11.1)
Une requête MAP fait 60 octets : un en-tête commun de 24 octets plus un corps MAP de 36 octets.
 0                   1                   2                   3
 0 1 2 3 4 5 6 7 8 9 0 1 2 3 4 5 6 7 8 9 0 1 2 3 4 5 6 7 8 9 0 1
+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+
|  Version = 2  |R|   Opcode=1  |           Reserved            |
+---------------+---------------+-------------------------------+
|                 Durée demandée (32 bits)                        |
+---------------------------------------------------------------+
|                                                               |
|             Adresse IP du client PCP (128 bits)               |
|                                                               |
|                                                               |
+---------------------------------------------------------------+
|                                                               |
|                  Nonce de mappage (96 bits)                   |
|                                                               |
+---------------+-----------------------------------------------+
|   Protocole   |             Réservé (24 bits)                     |
+-------------------------------+-------------------------------+
|        Port interne           |   Port externe suggéré        |
+-------------------------------+-------------------------------+
|                                                               |
|          Adresse IP externe suggérée (128 bits)               |
|                                                               |
|                                                               |
+---------------------------------------------------------------+
Les adresses IPv4 sont transportées sous forme IPv4-mapped IPv6 (::ffff:a.b.c.d). En réponse, le bit “R” est activé, l’en-tête comporte un code de résultat et une époque, et le corps MAP porte le port et l’adresse externes attribués à la place des suggestions.
Go : un client MAP PCP
package main

import (
	"bytes"
	"crypto/rand"
	"encoding/binary"
	"fmt"
	"net"
	"time"
)

const (
	pcoServerPort = 5351
	pcoVersion    = 2
	opMap         = 1
	protoUDP      = 17
	pcoReqLen     = 60 // en-tête commun 24 octets + corps MAP 36 octets
)

// PCPMapping représente ce que le serveur PCP a attribué.
type PCPMapping struct {
	ExternalIP   net.IP
	ExternalPort uint16
	Lifetime     time.Duration
}

// RequestMapping demande au serveur PCP du gateway de transférer le trafic UDP externe vers localIP:internalPort (RFC 6887, opcode MAP).
func RequestMapping(gateway, localIP net.IP, internalPort uint16, lifetime uint32) (*PCPMapping, error) {
	// Se lier à localIP : le champ IP du client PCP doit correspondre à l’adresse source du paquet
	conn, err := net.DialUDP("udp",
		&net.UDPAddr{IP: localIP},
		&net.UDPAddr{IP: gateway, Port: pcoServerPort})
	if err != nil {
		return nil, err
	}
	defer conn.Close()

	var nonce [12]byte
	if _, err := rand.Read(nonce[:]); err != nil {
		return nil, err
	}

	req := make([]byte, pcoReqLen)
	req[0] = pcoVersion // version
	req[1] = opMap      // bit R = 0 (requête), opcode = 1
	binary.BigEndian.PutUint32(req[4:8], lifetime)
	copy(req[8:24], localIP.To16()) // IP du client (IPv4-mappé pour IPv4)
	copy(req[24:36], nonce[:])      // nonce de mappage
	req[36] = protoUDP              // octets 37-39 réservés
	binary.BigEndian.PutUint16(req[40:42], internalPort)
	binary.BigEndian.PutUint16(req[42:44], internalPort) // port externe suggéré (indice)
// octets 44-59 : IP externe suggérée ; zéro = pas de préférence

	_ = conn.SetDeadline(time.Now().Add(3 * time.Second))
	if _, err := conn.Write(req); err != nil {
		return nil, err
	}
	resp := make([]byte, 1100) // messages PCP max 1100 octets
	n, err := conn.Read(resp)
	if err != nil {
		return nil, fmt.Errorf("pas de réponse PCP : %w", err)
	}
	return parseMapResponse(resp[:n], nonce)
}

func parseMapResponse(b []byte, nonce [12]byte) (*PCPMapping, error) {
	if len(b) < pcoReqLen {
		return nil, fmt.Errorf("réponse PCP courte : %d octets", len(b))
	}
	if b[0] != pcoVersion {
		return nil, fmt.Errorf("version PCP inattendue %d", b[0])
	}
	if b[1] != 0x80|opMap { // bit R activé + opcode MAP
		return nil, fmt.Errorf("réponse MAP incorrecte (byte 1 = %#x)", b[1])
	}
	if code := b[3]; code != 0 {
		return nil, fmt.Errorf("code résultat PCP %d", code)
	}
	if !bytes.Equal(b[24:36], nonce[:]) {
		return nil, fmt.Errorf("nonce de mappage non concordant")
	}
	return &PCPMapping{
		Lifetime:     time.Duration(binary.BigEndian.Uint32(b[4:8])) * time.Second,
		ExternalPort: binary.BigEndian.Uint16(b[42:44]),
		ExternalIP:   net.IP(append([]byte(nil), b[44:60]...)).To16(),
	}, nil
}
L’application vérifie la version, le bit de réponse, le code résultat et le nonce avant de faire confiance à l’adresse attribuée. Elle a été testée contre un serveur simulé répondant selon la structure ci-dessus ; pas encore contre un vrai CGN. Rafraîchissez les mappings avant l’expiration du délai, et considérez un changement d’époque dans une réponse ultérieure comme un signe que le serveur a perdu l’état.
Stratégie de connexion en couches
Un client de tunnel réaliste essaie les chemins par ordre de coût, avec toujours un relais en dernier recours :
- IPv6 direct, si les deux côtés le supportent.
- Mappage de port sur la passerelle la plus proche (PCP, NAT-PMP, UPnP).
- Hole punching assisté par STUN, coordonné via le plan de contrôle.
- Probing à la manière du paradoxe des anniversaires quand un seul côté a un NAT dur.
- Un relais, si les deux côtés ont un NAT dur ou si toutes les autres étapes échouent.
Pour un service de tunnel hébergé, le chemin relais est la norme, et tout le reste est une optimisation pour réduire le coût et la latence.
Partie 3 : QUIC 0-RTT pour la reconnexion de tunnel
Coût de la poignée de main
Une nouvelle connexion TCP nécessite un aller-retour avant que TLS ne démarre, et TLS 1.3 en nécessite un autre avant que le client puisse envoyer des données applicatives. QUIC combine les handshakes de transport et cryptographique, donc une nouvelle connexion nécessite un seul aller-retour. Avec la reprise de session, QUIC permet au client d’envoyer des données dès le premier vol : 0-RTT.
[ Temps jusqu’au premier octet de requête ]
TCP + TLS 1.3           QUIC (nouveau)             QUIC 0-RTT (repris)
SYN ------------e9>       Initial -------e9>        Initial + données 0-RTT -e9>
c8>--- SYN-ACK         c8>--- Handshake         c8>--- Fin handshake
ClientHello ----e9>       Données --------e9>
c8>--- ServerHello..Fin
Données -----------e9>
(2 RTT)                 (1 RTT)                   (0 RTT)
RFC 8470 décrit l’avantage des données précoces en HTTP pour éviter les délais de round-trip du handshake TLS, mais indique aussi le principal risque : un attaquant peut capturer et rejouer la requête qu’elle transporte.
Fonctionnement de la reprise dans QUIC
Selon RFC 9001 section 4.6 :
- Le client doit mémoriser l’état TLS, les paramètres de transport QUIC, le protocole applicatif choisi et toute information nécessaire pour construire des paquets 0-RTT, tous issus d’une même connexion antérieure. TLS 1.3 limite la durée entre ces connexions à sept jours.
- Le ticket de session du serveur arrive comme un message
NewSessionTicketdans les cadres CRYPTO de QUIC (pas un type de cadre QUIC séparé). - Le champ
max_early_data_sizeest utilisé comme un indicateur : les serveurs QUIC doivent y envoyer0xffffffff, et un client considère toute autre valeur comme une violation du protocole. La quantité de données 0-RTT est plutôt régie par le paramètre de transportinitial_max_data. (Ce n’est pas une valeur négociée dans le ticket.) - Un serveur accepte en incluant
early_datadansEncryptedExtensions; il refuse en l’omettant. Après un refus, le client doit réinitialiser l’état de tous les flux utilisant 0-RTT, y compris l’état applicatif. - Les applications utilisant QUIC doivent définir un profil pour l’usage du 0-RTT. Sans cela, le 0-RTT ne peut transporter que des cadres QUIC sans données applicatives, et les clients ne doivent pas envoyer de données applicatives en 0-RTT sauf si l’application le demande.
Ce que le 0-RTT ne vous donne pas
RFC 8446 section 2.3 détaille les garanties plus faibles du 0-RTT :
- Ce n’est pas forward secret, car il est protégé uniquement par des clés dérivées de la clé pré-partagée.
- Il n’offre aucune protection contre la rejouabilité entre connexions, car les données 0-RTT ne dépendent pas de la valeur aléatoire du serveur. Dans une seule connexion, il ne peut pas être dupliqué.
Défenses contre la rejouabilité, couche par couche
Transport et couche TLS. TLS 1.3 décrit trois techniques côté serveur en section 8 : tickets à usage unique, enregistrement des messages ClientHello, et vérification de fraîcheur (comparaison de l’âge du ticket obfusqué avec le temps écoulé). Chacune échange de la gestion d’état ou de la tolérance aux horloges contre la protection, et aucune n’élimine totalement la rejouabilité : elles la réduisent et limitent le nombre de rejouements. En déploiement multi-serveurs, tickets à usage unique et enregistrement de ClientHello nécessitent un état partagé.
Couche QUIC. La section 9.2 de la RFC 9001 indique que l’état de transport de QUIC n’est pas affecté par la rejouabilité, puisque le traitement des cadres est idempotent, mais la rejouabilité influence ce que l’application en fait. Elle précise que les tickets de session et les jetons de validation d’adresse ne doivent pas porter de sémantique applicative, et qu’un serveur acceptant le 0-RTT doit supporter un coût supplémentaire. La désactivation du 0-RTT est la défense la plus efficace.
Couche HTTP. La RFC 8470 fournit des outils au niveau HTTP :
- Un intermédiaire ayant reçu une requête en early data la marque avec un en-tête
Early-Data: 1lors de la transmission. - Un origine jugeant le risque de rejouabilité trop élevé répond
425 Too Early. - Les clients utilisant early data doivent refaire une requête en cas de 425, et les intermédiaires doivent transmettre un 425 pour les requêtes portant l’en-tête
Early-Data. - Si le traitement d’une requête n’a pas d’effets secondaires modifiant l’état, la rejouabilité n’a généralement pas de conséquences importantes.
L’approche de Cloudflare est une référence : son support du 0-RTT couvre les requêtes GET, HEAD et OPTIONS, pas POST, ajoute un en-tête Early-Data: 1 pour que les origines reconnaissent les requêtes précoces, et indique que ces requêtes peuvent être rejouées. Il faut donc évaluer si ce risque est acceptable dans votre contexte.
Flux de décision côté serveur
ClientHello entrant avec PSK + données 0-RTT
        |
        v
Ticket valide et non expiré ? ----- non ---e0> Rejeter 0-RTT, effectuer handshake normal 1-RTT
        | oui
        v
Vérification de rejouabilité (ticket à usage unique, enregistrement ClientHello, ou âge)
        | réussi                       e0> Échec
        v                               ---e0> Rejeter 0-RTT, handshake normal 1-RTT
Accepter early_data dans EncryptedExtensions
        |
        v
Politique par requête au niveau applicatif / HTTP
   méthode sûre (GET, HEAD, OPTIONS)  -----e0> traitement immédiat
   toute autre méthode modifiant l’état  -----e0> 425 Too Early, client réessaie après handshake
Middleware Go pour 425 Too Early
Si votre relais transfère les requêtes early-data avec Early-Data: 1, l’application peut refuser les méthodes modifiant l’état :
package main

import "net/http"

// rejectUnsafeEarlyData répond 425 Too Early (RFC 8470) si une requête
// reçue en early data utilise une méthode modifiant l’état.
func rejectUnsafeEarlyData(next http.Handler) http.Handler {
	return http.HandlerFunc(func(w http.ResponseWriter, r *http.Request) {
		if r.Header.Get("Early-Data") == "1" && !isSafeMethod(r.Method) {
			w.Header().Set("Retry-After", "0")
			http.Error(w, "réessayer après la fin du handshake", http.StatusTooEarly)
			return
		}
		next.ServeHTTP(w, r)
	})
}

func isSafeMethod(m string) bool {
	switch m {
	case http.MethodGet, http.MethodHead, http.MethodOptions:
		return true
	}
	return false
}
Une série de tests couvrant GET, HEAD, POST et PUT avec ou sans en-tête a été validée. La liste autorisée est volontairement limitée aux méthodes dites “sûres”, pas seulement idempotentes : un PUT peut être idempotent mais dangereux à rejouer (par exemple, rejouer une écriture obsolète après une plus récente).
Où le 0-RTT aide réellement un tunnel
Le 0-RTT concerne la connexion en cours de reprise, ce qui clarifie ses bénéfices :
- Reprises agent-relai. Un agent de tunnel qui reprend après une pause ou un changement réseau peut continuer sa session sans attendre un handshake complet. Réservez le contenu en 0-RTT aux cadres de contrôle idempotents (“reprendre la session X”). Attendez la fin du handshake pour tout ce qui modifie l’état.
- Clients publics vers l’edge via HTTP/3. Appliquez les règles HTTP ci-dessus. Les webhooks, souvent POST, sont exclus par Cloudflare.
- Ce n’est pas une solution gratuite pour les adresses. Cloudflare indique que, avec QUIC, les requêtes 0-RTT peuvent être traitées avant la validation de l’adresse source. La section 9.3 de la RFC 9001 couvre le risque d’amplification : les serveurs limitent ce qu’ils envoient à trois fois la taille des données reçues jusqu’à la validation.
La migration de connexion est une fonctionnalité complémentaire. QUIC identifie les connexions par ID plutôt que par tuple IP/port, permettant à un client dont la liaison NAT ou l’adresse IP change de continuer la même connexion après validation du chemin, sans nouveau handshake (RFC 9000, section 9).
Blocs de construction standards pour UDP et IP sur HTTP/3
Si votre tunnel transporte des paquets UDP ou IP, pas besoin d’inventer une couche de cadrage. RFC 9298 définit le proxy UDP en HTTP, RFC 9484 le proxy IP en HTTP (octobre 2023), tous deux s’appuyant sur l’extension datagram non fiable de QUIC (RFC 9221). Utiliser ces standards permet aux stacks HTTP/3 et aux middleboxes de comprendre votre trafic.
Liste de vérification pour le déploiement
- Par défaut, désactivez le 0-RTT, puis activez-le uniquement pour des opérations de contrôle idempotentes nommées.
- Utilisez des tickets à usage unique ou un enregistrement ClientHello pour partager l’état ; appliquez la vérification de fraîcheur quand c’est impossible.
- Marquez les requêtes early-data avec
Early-Data: 1, et respectez le code 425 de bout en bout. - Ne mettez jamais de credentials, paiements ou modifications d’état en 0-RTT.
- Faites tourner régulièrement les clés de chiffrement des tickets, et limitez leur durée de vie bien en dessous de sept jours, limite TLS 1.3.
- Préparez une solution de secours TCP/TLS pour les réseaux filtrant UDP.
Références
- splice(2), Linux man-pages
- vmsplice(2)
- Go
net/splice_linux.go - Documentation du noyau Linux sur TLS
- Utilitaires de socket Linux pour QUICHE (UDP GSO, sendmmsg)
- RFC 6598 : Préfixe IPv4 réservé par l’IANA pour l’espace partagé
- RFC 8489 : STUN
- Fonctionnement NAT (Tailscale, via APNIC)
- RFC 6887 : Port Control Protocol et Paramètres PCP IANA
- RFC 8446 : TLS 1.3
- RFC 9001 : Utiliser TLS pour sécuriser QUIC
- RFC 8470 : Early Data en HTTP
- RFC 9298 : Proxy UDP en HTTP et RFC 9484 : Proxy IP en HTTP
- Cloudflare : Reprise de connexion 0-RTT
Related InstaTunnel pages
Continue from this article into the most relevant product guides and workflows.
Related Topics
Keep building with InstaTunnel
Read the docs for implementation details or compare plans before you ship.