Agents IA vocaux sur localhost : Twilio Media Streams et OpenAI Realtime via un tunnel
Exécutez un agent vocal IA de Twilio sur localhost. Reliez l’audio wss:// via un tunnel, maintenez la latence sous 800 ms et utilisez un sous-domaine stable pour TwiML et WebSocket.
Quick answer
Agents IA vocaux sur localhost: Twilio Media Streams et OpenAI Realtime via un tunnel: quick answer
If free tunnel limits interrupt your workflow, compare session length, stable URLs, concurrent tunnels, and paid-plan pricing before choosing a localhost tunnel tool.
What free tunnel limits should developers check first?
Check session duration, URL stability, concurrent tunnels, custom subdomains, bandwidth or request limits, and whether webhook callbacks survive restarts.
How does InstaTunnel handle longer development sessions?
InstaTunnel Free is designed around 24-hour sessions, with Pro available for higher limits and MCP endpoint tunnel workflows.
Un agent vocal basé sur le téléphone est ce qui tolère le moins les erreurs sur un ordinateur portable. Un webhook peut être réessayé. Une page peut se recharger. Un appel téléphonique ne peut pas: si l’audio se bloque pendant une demi-seconde, l’appelant l’entend.
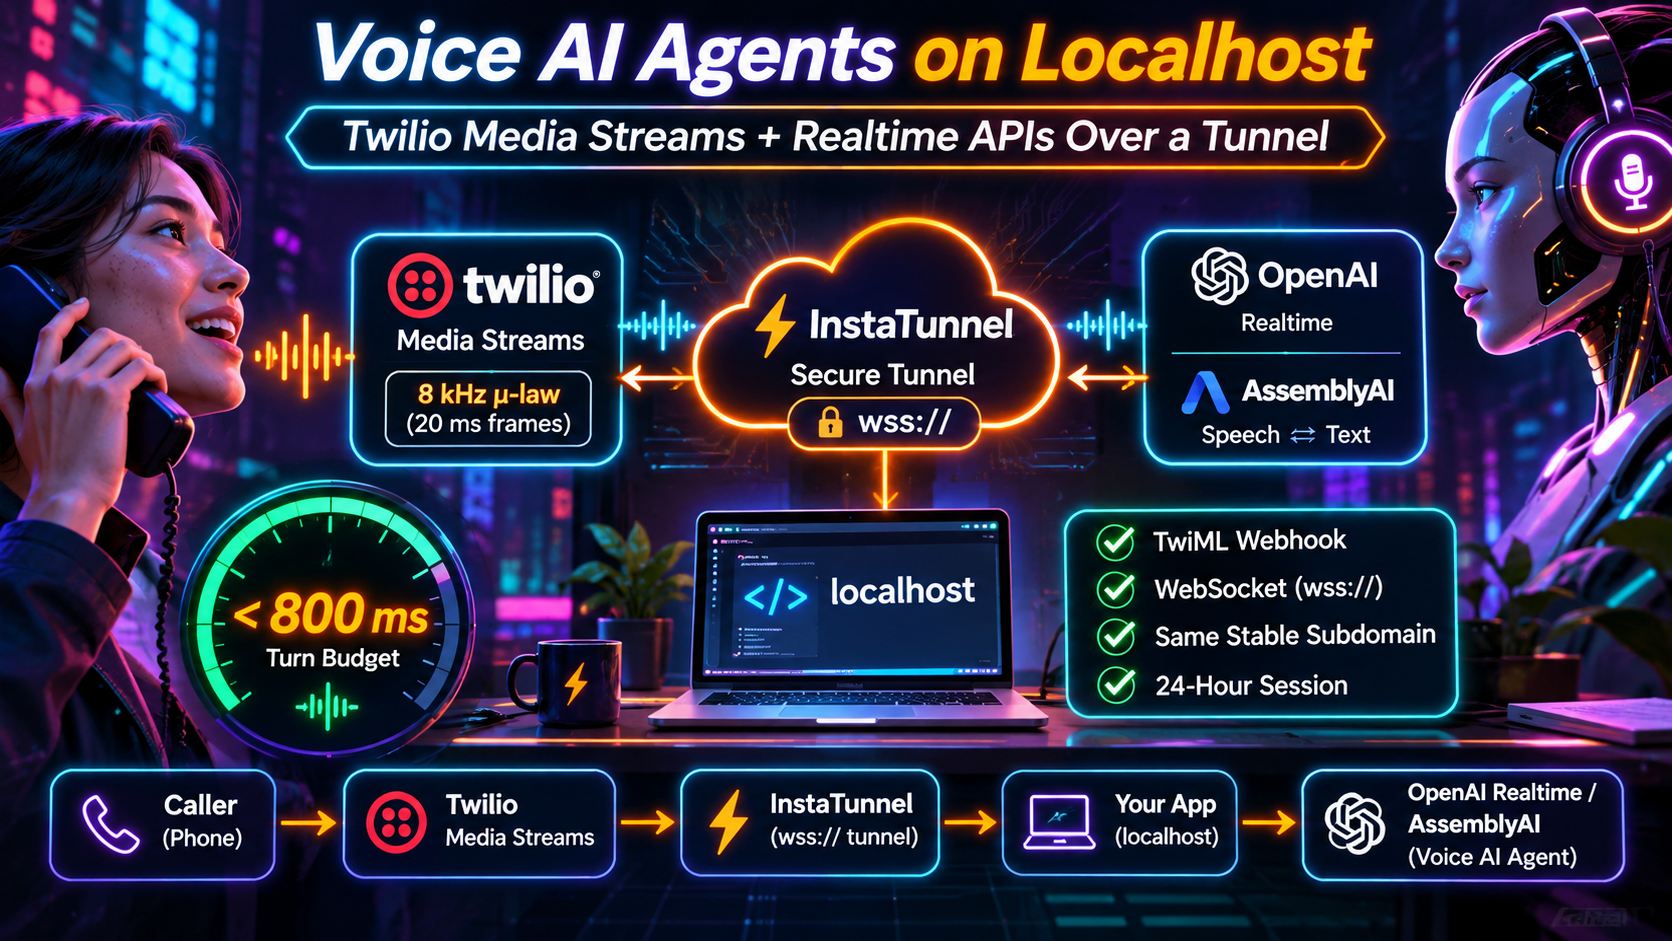
Twilio Media Streams et l’Realtime API d’OpenAI constituent une approche courante pour construire ces agents. Un pipeline classique de reconnaissance vocale → LLM → synthèse vocale est l’autre. La documentation de Twilio elle-même répertorie les agents IA comme cas d’utilisation de Media Streams, et ses exemples utilisent des noms d’hôte au style ngrok parce que l’URL du stream doit être publiquement accessible via TLS. Ce guide couvre ce qui traverse le tunnel, comment la mise à niveau du WebSocket fonctionne via un proxy de bord, comment rester près d’un budget de tour de 800 ms, et pourquoi un sous-domaine stable facilite une journée d’appels de test.
Pourquoi les agents vocaux représentent une charge de tunnel différente
La majeure partie du trafic via le tunnel est une demande/réponse : un webhook arrive, votre serveur répond. La voix est un flux continu et bidirectionnel de petits messages audio. Twilio envoie l’audio de l’appelant à votre serveur, et votre serveur renvoie l’audio de l’agent via le même WebSocket pendant toute la durée de l’appel.
Contrairement au streaming unidirectionnel tel que Server-Sent Events, le temps aller-retour et la gigue comptent dans les deux sens en même temps.
Le format audio est étroit et fixe. Selon la documentation de Twilio, le message start rapporte toujours audio/x-mulaw, 8 000 Hz, un canal, et les charges utiles sont encodées en base64 dans du JSON. μ-law à 8 kHz correspond à 8 000 octets par seconde, donc une trame de 20 ms fait 160 octets. Twilio précise que l’audio que vous renvoyez peut avoir n’importe quelle taille. La bande passante est triviale ; le retard ne l’est pas.
L’architecture : deux URL, un seul hôte
Un agent vocal Twilio nécessite deux points de terminaison publics :
- Un webhook HTTPS que Twilio appelle lorsqu’un appel arrive. Il renvoie TwiML.
- Un endpoint
wss://vers lequel Twilio se connecte après avoir lu ce TwiML.
Les deux peuvent coexister sur le même hostname de tunnel :
Caller ──PSTN──> Twilio ──POST /voice──> tunnel edge ──> localhost:5050/voice   (returns TwiML)
                   │
                   └────wss://your-subdomain.example/media ──> tunnel edge ──> localhost:5050/media
                                                                                   │
                                                              outbound wss to OpenAI Realtime
Le TwiML pour un flux bidirectionnel utilise <Connect><Stream url="wss://your-subdomain.example/media">:
<Response>
  <Connect>
    <Stream url="wss://your-subdomain.example/media">
      <Parameter name="caller" value="+15551230000" />
    </Stream>
  </Connect>
</Response>
Ces règles tirées de la documentation de Twilio comptent pour les configurations de tunnel :
wssest le seul protocole pris en charge. Une URL enws://plain ne fonctionnera pas.- L’
urlne prend pas en charge les paramètres de chaîne de requête. Transmettez les données par appel avec les éléments3cParameter3eà la place. Elles arrivent dans le message WebSocketstartsouscustomParameters. La longueur combinée du nom et de la valeur de chaque paramètre doit être inférieure à 500 caractères. <Connect><Stream>crée un flux bidirectionnel, et Twilio n’exécute pas les TwiML ultérieurs tant que votre serveur n’a pas fermé le WebSocket.- Un appel ne peut avoir qu’un seul flux bidirectionnel actif à la fois, et les flux bidirectionnels ne peuvent recevoir que l’
inbound_track. - Votre serveur doit accepter des connexions WebSocket sécurisées depuis Twilio sur le port TCP 443, depuis n’importe quelle adresse IP publique, et doit valider l’en-tête
X-Twilio-Signature. - Vous ne pouvez pas démarrer un flux bidirectionnel via la ressource REST Stream. Il doit provenir de
<Connect><Stream>.
Ce que Twilio envoie et ce qu’il attend en retour
Twilio envoie les messages connected, start, media, dtmf, mark et stop. dtmf et mark n’apparaissent que sur les flux bidirectionnels. Le DTMF est pris en charge uniquement dans la direction entrante, vous pouvez donc lire les touches du clavier mais ne pouvez pas renvoyer de tonalités. Votre serveur peut renvoyer trois types de messages : media, mark et clear.
Un message audio sortant est minimal :
{
  "event": "media",
  "streamSid": "MZXXXXXXXXXXXXXXXXXXXXXXXXXXXXXX",
  "media": { "payload": "<base64 mulaw/8000>" }
}
Trois détails causent la plupart des bogues « ça se connecte mais ça sonne mal » :
- Pas d’en-têtes de fichier. La charge utile doit être μ-law brute. Twilio avertit que les octets d’en-tête rendent le flux média incorrect, ce qui sonne généralement comme du bruit ou des clics.
- L’audio est mis en tampon. Twilio lit les messages
mediadans l’ordre reçu. Si vous envoyez l’audio plus vite que le temps réel, ce que font généralement les API des modèles, il s’accumule du côté de Twilio. clearvide le tampon. Lorsqu’un appelant interrompt, vous envoyezclear. Twilio renvoie alors des messagesmarkpour les marques envoyées qui n’ont pas encore été lues, afin que vous sachiez quel audio a été écarté.
Étant donné que le flux est bidirectionnel, il s’arrête lorsque l’appel se termine ou lorsque votre serveur ferme le WebSocket. Vous ne pouvez pas l’arrêter avec <Stop>. Si votre serveur ferme la connexion, Twilio demande l’URL action de <Connect> si vous en avez défini une. Sinon, il continue avec le TwiML qui suit <Connect>.
Branche OpenAI Realtime sans transcoding
La façon la plus rapide de protéger votre budget de tours est d’éviter le rééchantillonnage. Le format PCM d’OpenAI ne prend en charge qu’un taux d’échantillonnage de 24 kHz. Relier Twilio au PCM signifie donc convertir μ-law 8 kHz en 24 kHz, puis faire redescendre l’audio sur chaque trame. Un tutoriel publié mesurait environ 80 ms ajoutés par tour dû à un rééchantillonneur naïf sur le chemin chaud.
Au lieu de cela, demandez à Realtime le μ-law G.711 directement et faites passer les charges utiles de Twilio telles quelles. L’API GA accepte audio/pcmu (μ-law) et audio/pcma (A-law) comme formats audio de session. Twilio utilise μ-law, vous voulez donc audio/pcmu.
Les champs plats de l’époque bêta (input_audio_format: "g711_ulaw") sont remplacés dans le schéma GA par les objets imbriqués audio.input.format et audio.output.format. Si vous portez un exemple Twilio plus ancien et que vous voyez des erreurs de schéma, commencez par là.
{
  "type": "session.update",
  "session": {
    "type": "realtime",
    "model": "gpt-realtime-2.1",
    "output_modalities": ["audio"],
    "instructions": "You are a concise phone agent.",
    "audio": {
      "input":  { "format": { "type": "audio/pcmu" }, "turn_detection": { "type": "semantic_vad" } },
      "output": { "format": { "type": "audio/pcmu" }, "voice": "marin" }
    }
  }
}
Le 6 juillet 2026, OpenAI a publié gpt-realtime-2.1 et gpt-realtime-2.1-mini. Le modèle complet met à jour GPT-Realtime-2 avec une meilleure reconnaissance alphanumérique, la gestion du silence et du bruit, et le comportement d’interruption. Le mini est un modèle de raisonnement moins coûteux pour la voix. OpenAI a également déclaré avoir réduit la latence p95 d’au moins 25 % sur ses modèles vocaux Realtime grâce à un meilleur caching. Les noms de modèles évoluent rapidement, vérifiez donc l’ID actuel et les tarifs dans la documentation d’OpenAI avant de copier du code.
Les deux modèles 2.1 prennent en charge un réglage d’effort de raisonnement. Les résumés des orientations d’OpenAI, et un test publié, indiquent la même chose : commencer bas, car un effort plus élevé ajoute de la latence. Dans ce test (sur gpt-realtime-2), augmenter l’effort du faible vers le moyen a déplacé le temps de réponse médian d’environ 1,1 s à environ 1,8 s.
Un pont minimal comporte deux boucles partageant l’ID du flux :
# Twilio <- OpenAI Realtime bridge (FastAPI + websockets); error handling omitted
state = {"stream_sid": None}

async def twilio_to_openai(twilio_ws, openai_ws):
    async for raw in twilio_ws.iter_text():
        msg = json.loads(raw)
        if msg["event"] == "start":
            state["stream_sid"] = msg["start"]["streamSid"]
        elif msg["event"] == "media":
            await openai_ws.send(json.dumps({
                "type": "input_audio_buffer.append",
                "audio": msg["media"]["payload"],   # already base64 mulaw
            }))
        elif msg["event"] == "stop":
            break

async def openai_to_twilio(twilio_ws, openai_ws):
    async for raw in openai_ws:
        ev = json.loads(raw)
        if ev["type"] == "response.output_audio.delta":
            await twilio_ws.send_text(json.dumps({
                "event": "media",
                "streamSid": state["stream_sid"],
                "media": {"payload": ev["delta"]},  # forward untouched
            }))
        elif ev["type"] == "input_audio_buffer.speech_started":
            # caller is talking over the agent: flush what Twilio has queued
            await twilio_ws.send_text(json.dumps({
                "event": "clear",
                "streamSid": state["stream_sid"],
            }))

# run both with asyncio.gather(...)
L’instance OpenAI est une connexion sortante de votre machine, donc seule la branche Twilio traverse le tunnel. Cela compte pour le calcul de latence ci-dessous.
Mise à niveau de WebSocket via le tunnel edge
Un WebSocket commence sa vie comme une requête HTTP. Le client envoie un GET avec Upgrade: websocket, Connection: Upgrade, une Sec-WebSocket-Key et une Sec-WebSocket-Version: 13. Le serveur répond 101 Switching Protocols, et à partir de là les deux côtés échangent des trames sur la même connexion TCP.
Pour un edge de tunnel, cela signifie que cela doit :
- Terminer TLS afin que Twilio puisse se connecter à une URL
wss://avec un certificat valide, sur le port 443. - Transférer les en-têtes de mise à niveau vers votre origine locale plutôt que de supprimer
UpgradeetConnection. - Passer les trames dans les deux sens sans les mettre en tampon dans des blocs plus volumineux, car le buffering transforme des trames régulières en rafales.
- Maintenir la connexion ouverte pendant toute la durée de l’appel. Le trafic vocal n’est jamais inactif tant qu’un appel est en cours, donc les délais d’inactivité comptent rarement, mais une durée de vie par connexion serait trop.
Testez ceci avant de déboguer la logique de l’agent : pointez un client WebSocket vers votre URL publique wss:// et confirmez une réponse 101 et des messages écho. Cela exclut toute la couche edge en une minute.
La validation des signatures nécessite un contrôle supplémentaire. Twilio calcule X-Twilio-Signature sur l’URL publique qu’il a appelée, donc le schéma et l’hôte que votre code de validation reconstruit doivent correspondre à l’URL publique du tunnel, et non à localhost. Si la validation passe sur une connexion directe mais échoue via le tunnel, comparez ces valeurs en premier.
Le budget de tour sous-seconde
Le chiffre à viser est l’écart entre la fin d’une phrase par l’appelant et le début de la réponse par l’agent. Le guide phone-agent d’AssemblyAI situe l’objectif atteignable à environ 800 ms, ce que les appelants ressentent comme une écoute attentive. Il indique que l’agent semble défaillant au-delà de 1 500 ms. Son budget d’exemple répartit 50–150 ms pour le réseau et la téléphonie, 150–300 ms pour l’interaction de fin, et plusieurs centaines de millisecondes pour le premier token du LLM et le premier octet du TTS.
Un modèle de type speech-to-speech saute l’étape de relais entre ces stades, mais pas l’objectif. Un tutoriel Techsy a mesuré une médiane de 1,1 s et un p95 de 1,9 s sur 40 appels Twilio sur gpt-realtime-2 avec semantic_vad et un faible effort de raisonnement. Son serveur était colocataire près de la région OpenAI, et le test précède les modèles 2.1. Cela représente la mesure d’un seul fournisseur, traitez-la comme point de référence, pas comme une référence absolue. En conclusion, 800 ms est une cible pour une pile bien ajustée, pas une valeur par défaut obtenue gratuitement.
Ce que le tunnel apporte
Seule la branche Twilio traverse le tunnel. L’audio de l’appelant traverse Twilio → edge → votre ordinateur portable, et la réponse traverse ordinateur portable → edge → Twilio. Par rapport à un relais déployé près de Twilio, le coût additionnel est le ou les sauts via l’edge et votre dernier kilomètre, dans les deux directions. Cela dépend de trois éléments que vous contrôlez :
- Distance. La région par défaut de Twilio est US1. Media Streams est aussi disponible en Irlande (IE1) et en Australie (AU1). Choisissez la région du tunnel la plus proche de la région Twilio que vos appels utilisent.
- Votre dernier kilomètre. Le jitter Wi‑Fi ou un VPN feront plus de dégâts que le saut d’edge. Utilisez Ethernet câblé pour les sessions de test.
- Le jitter, pas les moyennes. Un chemin qui se bloque occasionnellement pendant 200 ms produit des gaps audibles même si la moyenne semble correcte.
Je n’ai pas pu vérifier une valeur publiée et indépendante du fournisseur pour le surcoût du tunnel sur le trafic vocal, alors mesurez-la. Enregistrez le moment où input_audio_buffer.speech_stopped arrive, celui où arrive le premier response.output_audio.delta, et celui où vous envoyez le premier message media à Twilio. Comparez avec une baseline déployée.
Barge-in sans parler par-dessus l’appelant
Étant donné que Twilio met en tampon l’audio sortant, l’interruption prend trois étapes :
- Lorsque Realtime signale que l’appelant a commencé à parler (
input_audio_buffer.speech_started), envoyez à Twilio un messageclearpour arrêter l’audio en file d’attente. La configuration de session d’OpenAI contrôle aussi si un départ de parole détecté interrompt automatiquement la réponse en cours. - Envoyez un message
markaprès chaque messagemedia, et utilisez les marques renvoyées par Twilio pour suivre ce qui a réellement été lu. - Indiquez au modèle ce qui a été entendu en envoyant un événement
conversation.item.truncatepour l’élément interrompu, afin que son enregistrement de la conversation corresponde à ce que l’appelant a vécu.
Sauter l’étape 1 et l’agent termine sa phrase pendant l’appelant. Sauter l’étape 3 et le modèle pense qu’il a dit des choses que l’appelant n’a jamais entendues.
Pourquoi un sous-domaine stable et une session de 24 heures aident
Le débogage vocal implique de nombreux courts appels au cours d’une journée : ajustez l’invite, appelez, écoutez, répétez. Deux éléments dans la configuration Twilio sont pénibles avec une URL aléatoire et changeante :
- Le webhook vocal du numéro de téléphone est configuré dans la console Twilio. Changez l’hôte et vous devez le rééditer.
- L’URL
<Stream>dans votre TwiML doit être un hôtewss://complet, et comme les chaînes de requête ne sont pas prises en charge, vous ne pouvez pas faire passer des données de routage dans l’URL.
Un tunnel qui vous donne un seul sous-domaine stable résout les deux. Le même hôte gère POST /voice et wss://…/media, vous enregistrez donc le webhook une fois et le TwiML lit son propre hôte à partir de la requête. Les données par appel se placent dans les valeurs <Parameter>, et vous indexez l’état par le streamSid et le SID d’appel à partir du message start.
Selon InstaTunnel, les sessions gratuites durent jusqu’à 24 heures et incluent un sous-domaine persistant personnalisé, avec des limites plus longues sur Pro. Vérifiez la page de tarification actuelle avant de vous fier à des chiffres exacts. Pour le travail vocal, l’avantage est clair : un tunnel qui tient toute une journée sans reconnexion ni ré-passage d’URLs en milieu de test.
Une limite existe du côté OpenAI. Une session Realtime unique a une durée maximale de 60 minutes, donc un tunnel qui dure n’implique pas nécessairement un appel long. Préparez des reconnects pour les appels très longs.
Sécurité pour un tunnel acceptant le trafic téléphonique
Un WebSocket ouvert qui relie à une API de modèle payant représente un risque de coût si quelqu’un le découvre.
- Validez
X-Twilio-Signaturesur le webhook et la poignée de main WebSocket, et rejetez les échecs avant d’ouvrir le socket upstream OpenAI. - Gardez les clés API dans le processus de votre serveur, jamais dans TwiML ou un navigateur.
- Fermez le tunnel lorsque vous avez terminé, et définissez des limites de dépenses sur votre compte modèle.
- Ne mettez pas une porte d’accès par navigateur devant Twilio. Il ne peut pas effectuer une connexion interactive ; la validation de signature est votre authentication.
Checklist de dépannage
Définissez une URL statusCallback sur <Stream> lors du débogage. Twilio envoie les événements stream-started, stream-stopped et stream-error là-bas, avec un message d’erreur en cas d’échec. L’URL doit être absolue et publiquement accessible, afin de pouvoir passer par le même tunnel.
| Symptôme | Cause probable |
|---|---|
| L’appel se connecte puis se coupe | l’URL n’est pas wss://, la poignée de main échoue, ou la validation de signature rejette la requête |
| Audio statique ou des clics sur la ligne | Octets d’en-tête dans la charge utile, ou encodage incorrect (pas μ-law 8 kHz) |
| Bruit ou sonnerie incohérente | Session OpenAI toujours sur 24 kHz PCM pendant que vous transmettez le μ-law brut |
| L’agent parle par-dessus l’appelant | Aucun clear envoyé lors de l’interruption |
| Longs silences inégaux | Rééchantillonnage dans le chemin chaud, région de tunnel éloignée, ou jitter sur le laptop |
| Fonctionne localement, échoue via le tunnel | Edge qui ne transmet pas les en-têtes Upgrade, ou incohérence de l’hôte de signature |
| webhook fonctionne, flux ne se connecte jamais | Problème TLS ou accessibilité du port 443 vers le chemin WebSocket |
Erreurs de schéma sur session.update |
Champs audio plats de type bêta envoyés à l’API GA |
Quand quitter le tunnel
Un tunnel est destiné au développement. En production, déployez le relais dans une région cloud proche des serveurs médias de Twilio pour retirer votre ordinateur portable et un saut du chemin d’appel.
Vous avez deux autres façons de réduire le relais ou l’acheminement audio :
- Skip the WebSocket relay with SIP. OpenAI’s Realtime API accepts SIP calls. In Twilio’s walkthrough, an Elastic SIP Trunk uses an origination URI of the form
sip:proj_<your_project_id>@sip.api.openai.com;transport=tls. OpenAI then fires arealtime.call.incomingwebhook to your server, and your server accepts the call through the Realtime Calls API. You trade control of the audio path for fewer moving parts. A tunnel still helps, because that webhook needs a public URL during development. - Let Twilio handle speech. If you do not need raw audio at all, Twilio points to ConversationRelay, where Twilio handles speech recognition and text-to-speech for you.
FAQ
Does Twilio Media Streams need wss://?
Yes. wss is the seul protocole pris en charge pour <Stream>, et Twilio s’attend à ce que votre serveur accepte des connexions WebSocket sécurisées sur le port TCP 443.
What audio format does Twilio use?
μ-law (audio/x-mulaw), 8,000 Hz, mono, encodé en base64 dans le JSON. L’audio sortant doit être brut, sans en-têtes de fichier.
Can OpenAI Realtime take Twilio audio directly?
Oui. Définissez le format audio GA sur audio/pcmu pour l’entrée et la sortie, et vous pouvez transmettre les payloads sans transcoder.
Can I put query parameters on the stream URL?
Non. Utilisez des éléments 3cParameter3e, qui arrivent dans le message start.
How fast should a voice agent respond?
Autour de 800 ms est la cible couramment citée, et au-delà de 1 500 ms cela semble cassé. Les mesures publiées se situent plus près d’une seconde, alors mesurez votre propre stack.
Sources
- Twilio : TwiML
3cStream3e - Twilio : Messages WebSocket des Media Streams
- Twilio : Aperçu des Media Streams
- Twilio : Connect the OpenAI Realtime SIP Connector with Elastic SIP Trunking
- OpenAI Developer Community : gpt-realtime-2.1 release
- OpenAI : Realtime conversations guide
- OpenAI API reference : Realtime calls
- AssemblyAI : How to create a phone-based voice agent
- Techsy : OpenAI Realtime API voice agent tutorial
- InstaTunnel on DEV : ngrok alternatives in 2026
Related InstaTunnel pages
Continue from this article into the most relevant product guides and workflows.
Related Topics
Keep building with InstaTunnel
Read the docs for implementation details or compare plans before you ship.