本番AIシステムの設計:ローカルLLMツールデバッグ&デカップルドスウォームインフラ
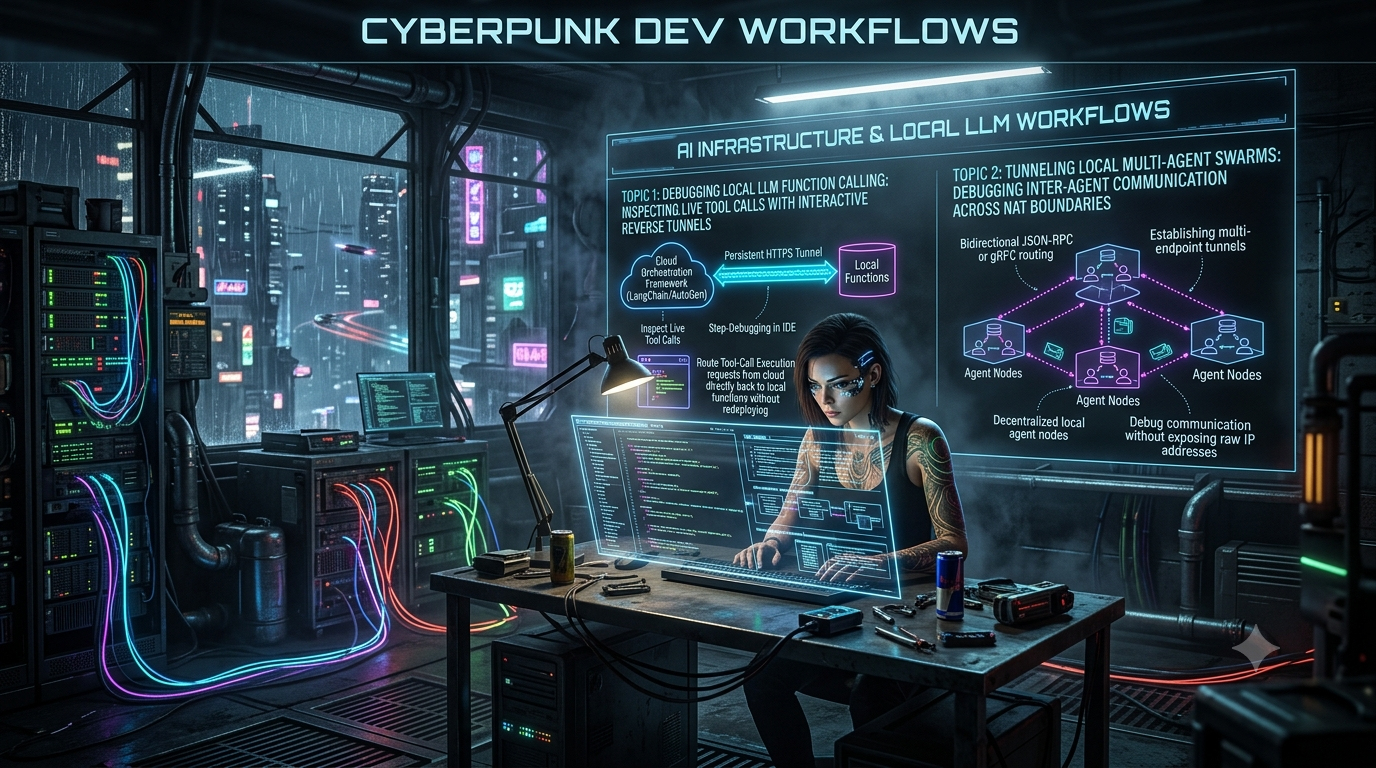
リバーストンネルを経由してクラウドオーケストレーションツールの呼び出しをローカルIDEにルーティング。LangChain & AutoGenの関数を再デプロイなしでステップデバッグ可能。### トピック2:ローカルマルチエージェントスウォームのトンネリング
Quick answer
### トピック1:ローカルLLM関数呼び出しのデバッグ: localhost tunnel answer
A localhost tunnel gives your local app a public HTTPS URL without opening router ports, which is useful for demos, QA, mobile testing, and provider callbacks.
How do I expose localhost without opening ports?
Use a reverse HTTPS tunnel. Your machine connects outbound to the tunnel service, and the public URL forwards requests back to your local app.
When should I use a localhost tunnel?
Use one for webhook testing, OAuth callbacks, client demos, QA previews, mobile device checks, and short-lived development reviews.
LLMオーケストレーションの急速な進化は、シンプルな単一プロンプトの完了から複雑なマルチエージェントスウォームまで、多岐にわたります。これに伴い、従来のデバッグやネットワーキングパターンは追いついていません。ローカルで自律型AIシステムを開発する際には、閉じたクラウド実行コンテキストの管理、非同期状態の同期、ローカルNATやファイアウォールの境界を越えるナビゲーションといったインフラの摩擦が生じます。
この運用ガイドでは、これらの課題を解決するための2つのエンジニアリングパターンを詳しく解説します:
- リアルタイムLLM関数呼び出しデバッグのためのインタラクティブリバーストンネリング
- ネットワーク境界を越えた分散gRPC / JSON-RPCマルチエージェントスウォームのデカップリング
トピック1:ローカルLLM関数呼び出しのデバッグ:インタラクティブリバーストンネルを使ったライブツール呼び出しの検査
アーキテクチャの課題:クラウドとローカルツールのギャップ
クラウドホストされたLarge Language Models(例:OpenAI GPT-4o、Anthropic Claude 3.5 Sonnet、DeepSeekのホスティングインスタンス)をLangChain、LlamaIndex、AutoGenなどのオーケストレーション層を介してエージェント型アプリケーションを構築する際、ツール呼び出し(関数呼び出し)は以下の2段階のループで実行されます:
- 推論フェーズ: クライアントはプロンプトコンテキストとJSON Schemaのツール定義をクラウドLLMに送信
- 実行フェーズ: クラウドLLMは構造化された
tool_callsペイロードを出力し、関数のシグネチャと解析された引数を含みます。オーケストレーションクライアントはこのペイロードを受け取り、ターゲット関数を実行し、その結果をLLMに返します。
┌─────────────────┐       1. プロンプト + ツールスキーマ       ┌─────────────────┐
│                 │ ────────────────────────────────── │                 │
│ Cloud LLM API   │                                     │ ローカルアプリ / │
│ (ホステッドモデル)│ ────────────────────────────────── │ オーケストレーター│
│                 │      2. 出力:tool_calls JSON        └────────┬────────┘
└─────────────────┘                                              │
                                                                 │ 3. ローカル実行
                                                                 ▼
                                                        ┌─────────────────┐
                                                        │ ローカル関数    │
                                                        │ (IDEデバッガ)   │
                                                        └─────────────────┘
開発の摩擦ポイント
外部Webhookやクラウドサンドボックス、リモートエージェントノードにツール実行をオフロードする際、開発者は以下のような摩擦に直面します:
- シェーマの静寂な不一致: LLMが生成した引数がローカルのPydantic検証に失敗し、詳細な実行ログなしに中断
- 不透明な実行: printデバッグや静的コンソールロガーは、パラメータの変異や状態更新、ネットワーク遅延を隠す
- 再デプロイの遅延: ローカルツールのコード変更には、コンテナのビルドやサーバーレスの再展開が必要
リバーストンネリングによるライブツール実行のアーキテクチャ
ローカルコードをステージング環境にデプロイせずに、Persistent TLS Reverse Tunnels(ngrok、Cloudflare Tunnels、devtunnelなど)を利用してインターネットに公開できます。
これにより、localhost上で動作するローカル開発サーバーに暗号化されたトンネルを通じて外部からコールバックをルーティングし、PythonやTypeScriptのIDE(VS Code / PyCharm)内にブレークポイントを設定し、LLMがリアルタイムでツールをトリガーする際のスタックフレームをライブで検査できます。
┌────────────────────────────────────────────────────────────────────────┐
│ パブリックインターネット / クラウド                                         │
│                                                                        │
│   ┌────────────────────────┐            ┌──────────────────────────┐   │
│   │ クラウドオーケストレーション /│            │ リバーストンネルゲートウェイ │   │
│   │ リモートエージェントワーカー  │            │ (例:ngrok / Cloudflare)   │   │
│   └───────────┬────────────┘            └────────────▲─────────────┘   │
└───────────────│──────────────────────────────────────│─────────────────┘
                │ Webhook HTTP POST                    │
                │ https://agent-dev.ngrok.app/execute  │ パーシステント
                └──────────────────────────────────────┼─ TLSトンネル
                                                       │
┌──────────────────────────────────────────────────────│─────────────────┐
│ ローカル開発環境                                    │                 │
│                                                    │                 │
│   ┌────────────────────────┐            ┌────────────┴─────────────┐   │
│   │ ローカルIDEデバッガー   │ ◄───────── │ トンネルクライアント  │   │
│   │ (ブレークポイント&状態)  │ ローカルホスト │ (localhost:8000)     │   │
│   └────────────────────────┘            └────────────────────────┘   │
└────────────────────────────────────────────────────────────────────────┘
ステップバイステップの実行設定
ステップ1:Persistent TLSトンネルの設定
ローカルツールサーバーのポート(例:8000)をターゲットにした安全なリバーストンネルを初期化します。
# ngrokを使ったHTTPトンネルの例(ホストヘッダーを保持)
ngrok http 8000 --domain=agent-dev-environment.ngrok.app

# もしくはMicrosoft devtunnel CLIを使用
devtunnel host -p 8000 --allow-anonymous
ステップ2:ツールサーバーとブレークポイント機能の実装
以下は、拡張可能なツールインターフェースを公開し、クラウドオーケストレーションされたモデルから要求されたローカル関数を実行できるFastAPIの完全な例です。
# tool_server.py
import uvicorn
from fastapi import FastAPI, HTTPException, Request
from pydantic import BaseModel, Field
from typing import Any, Dict

app = FastAPI(title="ローカルツールデバッグブリッジ")

# サンプルツールペイロードスキーマ
class ToolExecutionRequest(BaseModel):
    call_id: str
    tool_name: str
    arguments: Dict[str, Any]

class ToolExecutionResponse(BaseModel):
    call_id: str
    status: str
    result: Any

# デバッグ用のビジネスロジック関数
def calculate_database_query(query: str, limit: int) - dict:
    # IDEブレークポイント設定ポイント
    # ここでライブの引数を検査
    processed_query = query.strip().lower()

    if limit > 100:
        # LLMの誤 hallucination 引数をキャッチ
        limit = 100

    return {
        "status": "success",
        "rows_returned": limit,
        "executed_query": processed_query
    }

REGISTERED_TOOLS = {
    "calculate_database_query": calculate_database_query
}

@app.post("/execute-tool", response_model=ToolExecutionResponse)
async def handle_tool_call(payload: ToolExecutionRequest):
    """
    Webhookエンドポイントはリバーストンネル経由で呼び出されます。
    """
    print(f"\n[ツール呼び出し] ID: {payload.call_id} | ツール: {payload.tool_name}")
    print(f"[引数]: {payload.arguments}")

    if payload.tool_name not in REGISTERED_TOOLS:
        raise HTTPException(status_code=404, detail=f"ツール '{payload.tool_name}' はローカルに登録されていません。")

    # IDEデバッガでライブステップ可能
    target_function = REGISTERED_TOOLS[payload.tool_name]

    try:
        # LLMからの引数を動的に展開
        execution_result = target_function(**payload.arguments)

        return ToolExecutionResponse(
            call_id=payload.call_id,
            status="完了",
            result=execution_result
        )
    except TypeError as e:
        # パラメータスキーマ違反を即座に検知
        print(f"[スキーマエラー] LLMから渡された引数が不正: {str(e)}")
        raise HTTPException(status_code=422, detail=f"引数不一致: {str(e)}")

if __name__ == "__main__":
    # ローカルサーバ起動
    uvicorn.run("tool_server:app", host="127.0.0.1", port=8000, reload=True)
ステップ3:クラウドオーケストレータークライアントの設定
ツール呼び出しコールバックを、内部実行の代わりに動的リバーストンネルURLに向ける設定を行います。
# orchestrator_client.py
import requests
from langchain_openai import ChatOpenAI
from langchain_core.messages import HumanMessage, ToolMessage

TUNNEL_URL = "https://agent-dev-environment.ngrok.app/execute-tool"

# モデルの初期化
llm = ChatOpenAI(model="gpt-4o", temperature=0)

# モデルに提供するツールスキーマ
tools = [{
    "type": "function",
    "function": {
        "name": "calculate_database_query",
        "description": "ローカルデータベースに対して構造化クエリを実行",
        "parameters": {
            "type": "object",
            "properties": {
                "query": {"type": "string", "description": "SQLクエリ文字列"},
                "limit": {"type": "integer", "description": "返す最大行数"}
            },
            "required": ["query", "limit"]
        }
    }
}]

# 初期モデル呼び出し
messages = [HumanMessage(content="アクティブユーザのクエリをリミット50で実行")]
response = llm.invoke(messages, tools=tools)

# 関数呼び出しの処理
if response.tool_calls:
    for tool_call in response.tool_calls:
        print(f"リバーストンネル経由で'{tool_call['name']}'をルーティング...")

        # 実行リクエストを外部トンネル経由でローカルIDEに送信
        webhook_payload = {
            "call_id": tool_call["id"],
            "tool_name": tool_call["name"],
            "arguments": tool_call["args"]
        }

        tunnel_response = requests.post(TUNNEL_URL, json=webhook_payload)
        tool_result = tunnel_response.json()

        print(f"ローカル結果受信: {tool_result}")
高度な検査技術
1. ヘッダーとペイロードの検査
リバーストンネルツールは、ローカルWeb UIダッシュボード(例:http://127.0.0.1:4040 for ngrok)を公開します。開発者は、HTTPヘッダーやJSONシリアル化エラーを検査し、ワンクリックリプレイで失敗したツール実行をローカルブレークポイントから再トリガーできます。
2. 条件付きブレークポイント
IDE内で条件付きブレークポイントを設定し、LLMの実行特性に基づいて停止条件を指定します:
# Python IDE 条件付きブレークポイント条件
len(payload.arguments.get("query", "")) > 100 or payload.arguments.get("limit") is None
これにより、長いコンテキスト条件下で生成される不正な引数のエッジケースを特定できます。
3. 企業セキュリティとアクセス制御
ローカルエンドポイントのトンネリング時には、厳格なセキュリティ制御を適用し、公開アクセスを防ぎます:
- Mutual TLS (mTLS): クライアント証明書検証をトンネルクライアント側で強制
- ヘッダー署名: オーケストレーションエンドポイントから送信されるHMACヘッダー(
X-Signature-SHA256)を検証し、リクエストが認証済みクラウドサービスからのみ送信されたことを確認
トピック2:ローカルマルチエージェントスウォームのトンネリング:NAT境界を越えたエージェント間通信のデバッグ
分散エージェントアーキテクチャのネットワークボトルネック
AutoGen/AG2、CrewAI、またはカスタムのA2A / Model Context Protocolのような多様なマルチエージェントスウォームの設計が進む中、各エージェントは異なる環境に分散しています:
- エージェントA(プランナー): 企業のAWS VPC内
- エージェントB(コードインタープリター): NAT背後のローカルDockerコンテナ
- エージェントC(ハードウェアコントローラー): 制限されたセルフファイアウォール背後のエッジデバイス(例:Raspberry Pi、NVIDIA Jetson)
┌─────────────────────────────────────────────────────────────────────────────┐
│ 企業VPC (AWS)                                                               │
│                                                                             │
│   ┌─────────────────────────────────────────────────────────────────────┐   │
│   │ エージェントA (スーパーバイザー / コーディネーター)             │   │
│   └──────────────────────────────────┬──────────────────────────────────┘   │
└──────────────────────────────────────│──────────────────────────────────────┘
                                       │
     ❌ パブリックIPなしで直接ルーティング不可
                                       │
┌──────────────────────────────────────┴──────────────────────────────────────┐
│ ローカルオフィス / ワークステーション(NAT&ファイアウォール背後)             │
│                                                                             │
│   ┌────────────────────────────────┐     ┌──────────────────────────────┐   │
│   │ エージェントB (コードサンドボックスDocker)│     │ エージェントC (エッジセンサーノード)│   │
│   │ IP: 172.18.0.2 (プライベート)             │     │ IP: 192.168.1.45 (プライベート)  │   │
│   └────────────────────────────────┘     └──────────────────────────────┘   │
└─────────────────────────────────────────────────────────────────────────────┘
インフラの課題
これらのトポロジーでは、標準的なネットワーキングプロトコルは機能しません:
- 対称NATと厳格なファイアウォール: ローカルエージェントノードへのインバウンド接続をブロックし、ピアツーピア呼び出しを阻止
- 動的IP割り当て: 静的エンドポイントのハードコーディングを不可能に
- 高遅延: HTTP RESTポーリングは複雑なエージェント交渉ループの遅延を増大させる
プロトコル選択マトリクス:gRPC vs JSON-RPC over Tunnel Meshes
分散エージェントスウォームの通信層選択時、トランスポートの選択はスループット、スキーマの厳格さ、ストリーミング効率に大きく影響します:
| 特徴 | JSON-RPC 2.0 over HTTP/2 WebSocket | gRPC over HTTP/2 Tunnel |
|---|---|---|
| ペイロード形式 | テキストベースのJSON | バイナリのProtocol Buffers |
| スキーマの強制 | 動的 / ランタイム(Pydantic / Zod) | 静的 / コンパイル時(.protoファイル) |
| ストリーミング能力 | WebSocket / SSEによるフルデュプレックス | ネイティブの双方向ストリーミング |
| 遅延特性 | 中程度(パースオーバーヘッド) | 超低(ゼロコピーシリアル化) |
| NATトラバーサル適合性 | 軽量、ウェブデバッグ容易 | 複合TCP上の効率的通信 |
| 理想的なエージェントワークフロー | アドホックなテキストスウォーム、柔軟なJSONスキーマ | 高頻度センサースウォーム、多モーダルストリーミング |
マルチエンドポイントWireGuard / トンネルトポロジーの実装
NAT境界を越えたシームレスなエージェント間ルーティングを可能にするため、WireGuard、Tailscale、またはP2Pリバーストンネルゲートウェイを用いた暗号化オーバーレイネットワークを展開できます。
                         ┌─────────────────────────┐
                         │   リレーノード (パブリックオーバーレイネット) │
                         │   (例:Tailscale / WireGuard)             │
                         └────────────▲────────────┘
                                      │
            ┌─────────────────────────┴─────────────────────────┐
            │ WireGuard / オーバーレイメッシュトンネル (暗号化UDP)   │
            └────────────▲─────────────────────────▲────────────┘
                         │                         │
     ┌───────────────────┴──────────┐   ┌──────────┴───────────────────┐
     │ ノード1:クラウドオーケストレーター│   │ ノード2:ローカル開発者エッジ │
     │ メッシュIP: 10.0.0.1             │   │ メッシュIP: 10.0.0.2          │
     │ (スーパーバイザーエージェント)     │   │ (ワーカーエージェントコンテナ) │
     └──────────────────────────────┘   └──────────────────────────────┘
本番実装:非同期JSON-RPC 2.0によるエージェント間通信
以下は、トンネリングされたJSON-RPCメッシュ上で実行される分散マルチエージェントシステムの完全な実装例です。
1. JSON-RPCプロトコル定義 & ベースエージェント (agent_protocol.py)
# agent_protocol.py
import json
from typing import Any, Dict, Optional
from pydantic import BaseModel, Field

class JSONRPCRequest(BaseModel):
    jsonrpc: str = "2.0"
    method: str
    params: Dict[str, Any]
    id: str

class JSONRPCResponse(BaseModel):
    jsonrpc: str = "2.0"
    result: Optional[Any] = None
    error: Optional[Dict[str, Any]] = None
    id: str

class AgentCapability(BaseModel):
    agent_id: str
    description: str
    methods: list[str]
2. ローカルワーカーエージェント実装 (local_worker_agent.py)
このエージェントはローカルプライベートネットワーク内で動作し、暗号化トンネル経由で通信します。
# local_worker_agent.py
import asyncio
from fastapi import FastAPI, WebSocket, WebSocketDisconnect
from agent_protocol import JSONRPCRequest, JSONRPCResponse
import uvicorn

app = FastAPI(title="ローカルワーカーエージェントノード")

async def execute_code_analysis(code: str) - dict:
    """ローカルでのコード解析タスクを模擬"""
    await asyncio.sleep(0.5)  # 処理時間のシミュレーション
    return {
        "complexity_score": 4,
        "vulnerabilities_found": 0,
        "suggestion": "ループ構造を12行目で最適化"  # 例
    }

@app.websocket("/ws/rpc")
async def websocket_rpc_endpoint(websocket: WebSocket):
    await websocket.accept()
    print("[メッシュ] クラウドエージェントがローカルワーカーエージェントのRPCインターフェースに接続")

    try:
        while True:
            # RPCリクエストを受信
            raw_data = await websocket.receive_text()
            request_data = JSONRPCRequest.model_validate_json(raw_data)

            print(f"[RPCリクエスト] メソッド: {request_data.method}")

            # メソッドのディスパッチ
            if request_data.method == "analyze_code":
                code_param = request_data.params.get("code", "")
                execution_output = await execute_code_analysis(code_param)

                response = JSONRPCResponse(
                    result=execution_output,
                    id=request_data.id
                )
            else:
                response = JSONRPCResponse(
                    error={"code": -32601, "message": "メソッドが見つかりません"},
                    id=request_data.id
                )

            # RPCレスポンスをWebSocket経由で送信
            await websocket.send_text(response.model_dump_json())

    except WebSocketDisconnect:
        print("[メッシュ] スウォームノードが切断されました")

if __name__ == "__main__":
    # ローカル待受、トンネル経由でネットワークに公開
    uvicorn.run(app, host="0.0.0.0", port=9001)
3. リモートクラウドスーパーバイザーエージェント (cloud_supervisor.py)
このエージェントは、ワークフローのステップを管理し、RPCコマンドをメッシュ経由でローカルワーカーにルーティングします。
# cloud_supervisor.py
import asyncio
import websockets
import uuid
from agent_protocol import JSONRPCRequest, JSONRPCResponse

# トンネルメッシュのローカルワーカーエンドポイント
LOCAL_WORKER_TUNNEL_ENDPOINT = "ws://10.0.0.2:9001/ws/rpc"

async def dispatch_task_to_local_agent(method: str, params: dict):
    request_id = str(uuid.uuid4())

    rpc_payload = JSONRPCRequest(
        method=method,
        params=params,
        id=request_id
    )

    print(f"[スーパーバイザー] ローカルエージェントに接続 {LOCAL_WORKER_TUNNEL_ENDPOINT}...")

    async with websockets.connect(LOCAL_WORKER_TUNNEL_ENDPOINT) as ws:
        # RPC呼び出しを送信
        await ws.send(rpc_payload.model_dump_json())
        print(f"[スーパーバイザー] メソッド '{method}' [ID: {request_id}] を送信")

        # レスポンスを待つ
        raw_response = await ws.recv()
        response = JSONRPCResponse.model_validate_json(raw_response)

        if response.error:
            print(f"[RPCエラー] コード {response.error['code']}: {response.error['message']}")
        else:
            print(f"[成功] 実行結果: {response.result}")

if __name__ == "__main__":
    # エージェント間のワークフロー実行
    sample_code = "def fibonacci(n):\n    return n if n <= 1 else fibonacci(n-1) + fibonacci(n-2)"
    asyncio.run(dispatch_task_to_local_agent("analyze_code", {"code": sample_code}))
追跡・可観測性・NAT維持戦略
1. OpenTelemetryによるトレースコンテキストの伝播
エージェント間の呼び出し時に、traceparentヘッダーをRPCパラメータに含めて分散トレーシングを可能にします:
{
  "jsonrpc": "2.0",
  "method": "analyze_code",
  "params": {
    "code": "...",
    "_telemetry_context": {
      "traceparent": "00-4bf92f3577b34da6a3ce929d0e0e4736-00f067aa0ba902b7-01"
    }
  },
  "id": "req-001"
}
これにより、JaegerやHoneycomb、LangSmithといった分散トレーシングツールで、クラウドとローカルの実行ツリーを可視化できます。
2. NAT状態テーブルのキープアライブ
ファイアウォールは一定期間アイドル状態のTCP接続を切断します(30〜120秒)。これを防ぐために:
- TCP Keepalives: ソケットの
SO_KEEPALIVEとTCP_KEEPIDLE=30を設定 - アプリケーションレベルのPing: WebSocketやgRPCの接続内で15秒ごとにpingフレームを送信
# WebSocketクライアントのキープアライブ設定例
async with websockets.connect(endpoint, ping_interval=15, ping_timeout=10):
    ...
3. 自動リルーティング&メッシュのフェイルオーバー
本番環境では、ローカルワーカーエージェントが切断された場合、スーパーバイザーエージェントはタスクをクラウドのキューやフォールバックエージェントに切り替えます:
# サーキットブレーカーの概念例
try:
    await dispatch_task_to_local_agent(...)
except (websockets.exceptions.ConnectionClosedError, TimeoutError):
    print("[サーキットブレーカー] ローカルエージェントがオフライン。クラウドにリルート")
    await dispatch_task_to_cloud_fallback(...)
結論とアーキテクチャチェックリスト
ローカルとクラウド、分散エージェントの堅牢なインフラ構築には、静的デプロイからトンネル対応のアーキテクチャへの移行が必要です:
- [x] 関数呼び出し用: reverse TLSトンネル(
ngrok、devtunnel)を使い、クラウドモデルの実行をローカルブレークポイント付きサーバに橋渡し - [x] エージェント間通信: JSON-RPCやgRPC over HTTP/2をプライベートメッシュネットワーク(WireGuard、Tailscale)上に層状に配置し、NAT制約を回避
- [x] 可観測性: トレースコンテキストをネットワーク境界を越えて伝播させ、分散スウォームのエンドツーエンドの可視性を確保
Related InstaTunnel pages
Continue from this article into the most relevant product guides and workflows.
Related Topics
Keep building with InstaTunnel
Read the docs for implementation details or compare plans before you ship.