Behebung von SSE Buffer-Bloat in lokalen Tunneln: Garantierte Null-Latenz-Streams für lokale LLMs
Eliminieren Sie SSE Buffer-Bloat in Ihren Reverse-Proxies. Lernen Sie, TCP nodelay zu konfigurieren und HTTP-Buffering für null-Latenz-Token-Streaming bei lokalen LLMs zu deaktivieren.
Quick answer
Fix SSE Buffer-Bloat: Null-Latenz-Streaming für lokale LLMs: webhook testing answer
For local webhook testing, run your app locally, expose it with a public HTTPS tunnel, and paste the stable callback URL into the provider dashboard.
How do I test webhooks on localhost?
Start your local server, open a public HTTPS tunnel to that port, configure the provider webhook URL, and inspect events in your local logs.
Why does a stable webhook URL matter?
Stable URLs prevent provider dashboards from needing manual callback updates every time you restart a tunnel.
Sie haben gerade ein hochmodernes lokales LLM mit vLLM, Ollama oder llama.cpp bereitgestellt. Wenn Sie es auf localhost testen, ist die Token-Generierung ein echtes Highlight – ein reibungsloser, kontinuierlicher Textstrom, der sich sofort reaktionsschnell anfühlt. Doch sobald Sie diesen Endpunkt über einen Reverse-Proxy (wie Nginx) oder einen lokalen Tunnel (wie Cloudflare Tunnels oder Ngrok) nach außen freigeben, ist die Magie vorbei.
Statt eines flüssigen Flusses erhält Ihr Frontend mehrere Sekunden lang nichts, gefolgt von einem riesigen, klumpigen Textblock auf einmal.
Wenn Sie Echtzeit-Konversations-KI-Interfaces bauen, zerstört dieses “hackerhafte” Token-Ausgabe die Benutzererfahrung (UX). Es beeinträchtigt Ihre Time to First Token (TTFT)-Metrik und lässt Ihre Anwendung träge wirken, egal wie schnell Ihre GPUs tatsächlich inferieren.
Der Übeltäter? SSE Buffer-Bloat.
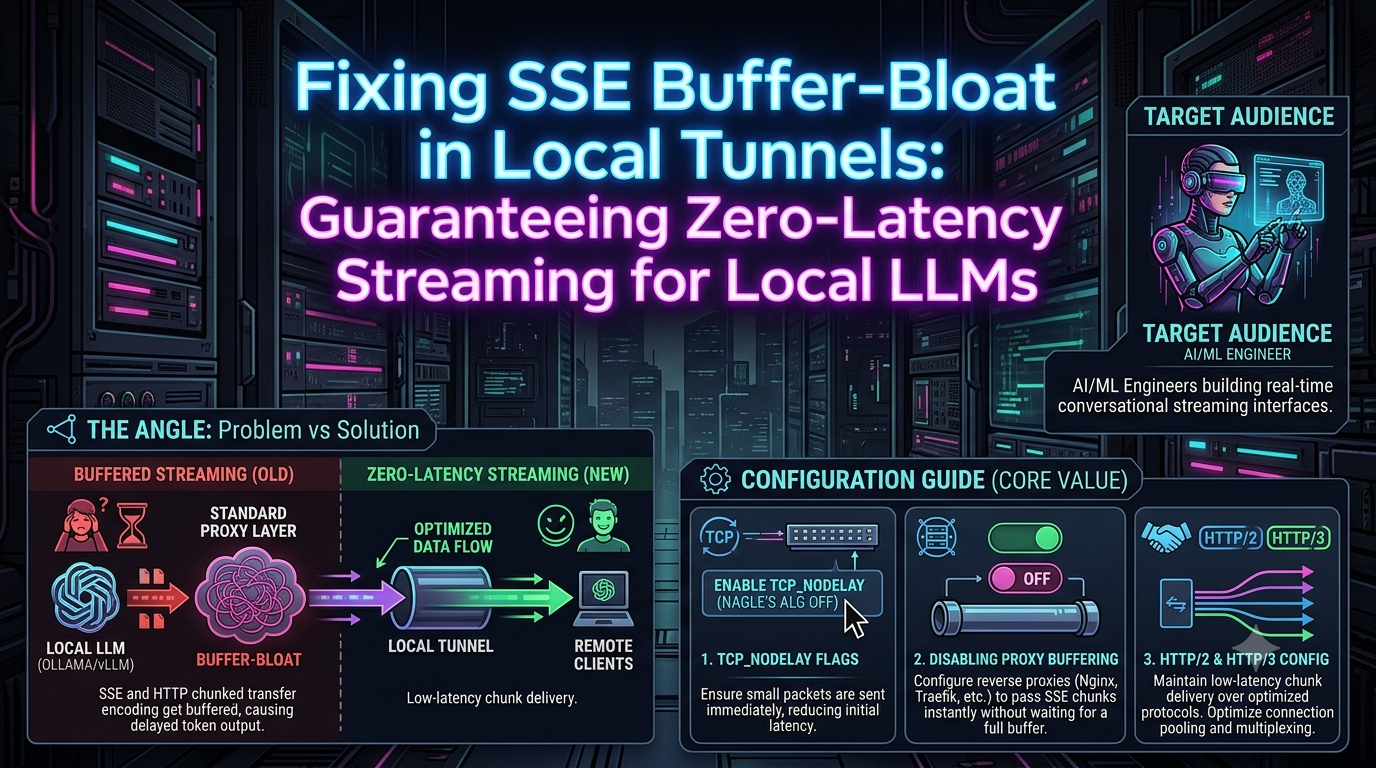
In diesem Leitfaden analysieren wir, warum Standard-Netzwerkschichten unbeabsichtigt Server-Sent Events (SSE) und HTTP-Chunked-Transfer-Encoding sabotieren. Noch wichtiger ist, wir geben eine definitive Konfigurationsanleitung, um Proxy-Buffering vollständig zu deaktivieren, TCP-Flags zu optimieren und eine Null-Latenz-Chunk-Lieferung für Ihren lokalen KI-Stack zu garantieren.
Die Ursache: Warum Proxies LLM-Streaming stören
Um die Lösung zu verstehen, müssen wir den Fehlermodus kennen. Das LLM-Streaming basiert standardmäßig auf Server-Sent Events (SSE). Bei einer SSE-Verbindung hält der Server eine einzelne HTTP-Verbindung offen und schiebt Daten (Tokens) sofort nach ihrer Generierung durch die Leitung, mit Transfer-Encoding: chunked.
Die Standard-Web-Infrastruktur ist nicht dafür ausgelegt. Proxies, Load Balancer und Tunnel sind historisch für hohe Durchsatzraten, statische oder vollständig gerenderte dynamische Payloads optimiert. Um Bandbreite und CPU-Zyklen zu sparen, setzen sie auf Buffering.
1. Reverse-Proxy-Buffering
Wenn ein Reverse-Proxy (wie Nginx) zwischen Ihrem LLM und dem Client sitzt, erfolgt standardmäßig eine Pufferung der Antworten. Nginx wartet, bis es eine bestimmte Datenmenge (z.B. 4KB oder 8KB) vom Upstream-Server gesammelt hat, bevor es diese an den Client weitergibt. Bei einer Generationsrate von 15 Tokens pro Sekunde kann es Sekunden dauern, bis dieser Puffer gefüllt ist. Der Nutzer sieht einen eingefrorenen Bildschirm, dann erscheint sofort ein riesiger Absatz.
2. Nagle’s Algorithmus (Transportschicht)
Auf TCP/IP-Ebene bestimmt Nagle’s Algorithmus, dass kleine Pakete verzögert und zu größeren Paketen zusammengefasst werden, um Netzwerküberlastung zu verringern. Da einzelne LLM-Tokens oft nur wenige Bytes groß sind, cached Nagle’s Algorithmus sie eifrig, was künstliche Latenz in den Stream einführt.
3. Mismatches bei Tunneling-Protokollen
Tools wie Cloudflare Tunnels (cloudflared) oder Ngrok multiplexen den Traffic häufig über HTTP/2 oder HTTP/3. Während HTTP/2-Multiplexing gut ist, um viele kleine Bilder gleichzeitig zu laden, kann aggressives Stream-Buffering durch Tunnel-Clients den kontinuierlichen, ungebufferten Fluss, den SSE benötigt, stören.
Lassen Sie uns diese Buffer Schicht für Schicht systematisch entfernen.
Layer 1: Transport- & Anwendungs-Tuning (Deaktivierung von Nagle’s Algorithmus)
Bevor Sie den Proxy fixen, stellen Sie sicher, dass Ihre Anwendung nicht der Flaschenhals ist. Wenn Sie einen eigenen Inference-Server (z.B. mit Python/FastAPI) schreiben, müssen Sie Nagle’s Algorithmus mit dem TCP_NODELAY-Flag deaktivieren.
TCP_NODELAY weist den TCP-Stack an, Daten sofort zu senden, unabhängig von der Paketgröße.
Python / FastAPI (Uvicorn)
Wenn Sie Uvicorn verwenden, können Sie dies auf Socket-Ebene erzwingen. Stellen Sie außerdem sicher, dass Ihr Anwendungs-Generator tatsächlich Daten ohne internes Caching liefert.
from fastapi import FastAPI
from fastapi.responses import StreamingResponse
import asyncio

app = FastAPI()

async def token_generator():
    tokens = ["Hallo", " Welt", ",", " das", " ist", " Streaming", " live!"]
    for token in tokens:
        # Wichtig: Formatieren als korrektes SSE-Payload
        yield f"data: {token}\n\n"
        await asyncio.sleep(0.1) # Simuliere Inference-Zeit

@app.get("/stream")
async def stream_llm():
    return StreamingResponse(
        token_generator(),
        media_type="text/event-stream",
        headers={
            "Cache-Control": "no-cache",
            "Connection": "keep-alive",
            "X-Accel-Buffering": "no" # Signalisiert Nginx, Buffering zu stoppen
        }
    )
Hinweis: Der Header X-Accel-Buffering: no ist ein mächtiger Trick. Viele Proxies (insbesondere Nginx) respektieren diesen und deaktivieren das Buffering für diese Antwort automatisch.
Layer 2: Reverse-Proxy-Konfiguration
Wenn Sie Ollama oder vLLM hinter einem Reverse-Proxy betreiben, um TLS-Termination oder API-Key-Authentifizierung zu handhaben, müssen Sie den Proxy explizit für Streaming konfigurieren.
Nginx
Nginx ist der häufigste Übeltäter bei SSE Buffer-Bloat. Standardmäßig ist proxy_buffering aktiviert. Sie müssen es für Ihre Inference-Endpunkte deaktivieren. Außerdem sollten Timeout-Limits erhöht werden, da die LLM-Generierung Minuten dauern kann.
server {
    listen 443 ssl;
    server_name api.ihredomain.de;

    location /v1/chat/completions {
        proxy_pass http://localhost:8000; # vLLM oder Ollama Backend

        # 1. Buffering deaktivieren
        proxy_buffering off;
        proxy_cache off;

        # 2. HTTP/1.1 ist zwingend erforderlich für WebSockets/SSE in älteren Nginx-Versionen
        proxy_http_version 1.1;
        proxy_set_header Connection '';

        # 3. Chunked-Transfer-Encoding-Interferenzen ausschalten
        chunked_transfer_encoding on;

        # 4. Lange Timeout-Zeiten für lange Prompts
        proxy_read_timeout 600s;
        proxy_connect_timeout 600s;
        proxy_send_timeout 600s;

        # Standard-Header
        proxy_set_header Host $host;
        proxy_set_header X-Real-IP $remote_addr;
    }
}
Caddy Server
Caddy ist in der Regel intelligenter bei modernen Webstandards, aber für Null-Latenz-KI-Streaming sollten Sie explizit das Flush-Intervall setzen, damit Chunks sofort gepusht werden.
api.ihredomain.de {
    reverse_proxy localhost:8000 {
        header_up Host {host}
        header_up X-Real-IP {remote}

        # Sofortiges Flushen, Buffering deaktivieren
        flush_interval -1
    }
}
Traefik
Wenn Sie Traefik in einer Docker- oder Kubernetes-Umgebung verwenden, kann Buffering über Labels oder Middleware deaktiviert werden.
# Beispiel docker-compose.yml
labels:
  - "traefik.http.middlewares.unbuffer.buffering.maxRequestBodyBytes=0"
  - "traefik.http.middlewares.unbuffer.buffering.memRequestBodyBytes=0"
  - "traefik.http.middlewares.unbuffer.buffering.maxResponseBodyBytes=0"
  - "traefik.http.middlewares.unbuffer.buffering.memResponseBodyBytes=0"
Layer 3: Lokale Tunnels (Cloudflare & Ngrok)
Oft möchten KI-Entwickler keine öffentlichen Ports öffnen oder Port-Weiterleitung konfigurieren, sondern lokale Tunnel verwenden. Diese führen eigene aggressive Buffer-Mechanismen ein.
Cloudflare Tunnels (cloudflared)
Cloudflare sitzt an der Netzwerkkante und puffert Antworten häufig, um WAF-Regeln, Caching oder Kompression anzuwenden. Beim Streaming durch einen Cloudflare Tunnel müssen zwei wichtige Regeln beachtet werden:
- Strikte Content-Type: Cloudflare puffert Ihre Antwort, es sei denn, der
Content-Type-Header ist exakttext/event-stream. Wenn Ihre Anwendungapplication/jsonoder reinen Text beim Streaming sendet, wartet Cloudflare, bis die Verbindung geschlossen ist, bevor die Payload geliefert wird. - Deaktivieren Sie Response Buffering im Dashboard: Falls Sie Verzögerungen feststellen, können Sie das Buffering explizit für Ihre Subdomain im Cloudflare-Dashboard deaktivieren. Erstellen Sie eine Regel für
api.ihredomain.de/*und setzen Sie Cache Level aufBypasssowie Response Buffering aus.
Troubleshooting: In hochsicheren Unternehmensumgebungen (z.B. Cloudflare Zero Trust oder Zscaler) wird HTTP/2 bidirektionales Streaming manchmal abgefangen und gebuffert. Moderne Tools (wie der Cursor AI-Editor) fallen bei Erkennung von HTTP/2-Buffering aktiv auf HTTP/1.1 SSE zurück. Wenn Sie Probleme mit cloudflared haben, kann das Erzwingen von HTTP/1.1 auf Ihrem Origin-Server manchmal das aggressive Layer-7-Firewall-Buffering umgehen.
Ngrok
Ngrok verhält sich in der Regel gut bei SSE out of the box, vorausgesetzt, die Header sind korrekt gesetzt. Wenn Sie Ngrok-Edges verwenden, stellen Sie sicher, dass die Kompression deaktiviert ist. Gzip/Brotli benötigen eine gewisse Datenmenge, um die Kompressionsalgorithmen zu aktivieren.
Beim Durchreichen von SSE durch einen Tunnel sollten Sie explizit die Kompression in Ihren Anwendung-Headern deaktivieren:
Accept-Encoding: identity (Client-Seite) oder Content-Encoding: identity (Server-Seite).
Layer 4: HTTP/2 und HTTP/3 Überlegungen
Da das Web sich in Richtung HTTP/2 und HTTP/3 (QUIC) bewegt, wird Streaming komplizierter.
HTTP/2 nutzt eine einzelne TCP-Verbindung und multiplext mehrere Streams. Obwohl dies das Head-of-Line-Blocking bei statischen Assets löst, können Flow-Control-Fenster unbeabsichtigt lange, langsame SSE-Verbindungen drosseln oder puffern, wenn sie nicht sorgfältig eingestellt sind.
Wenn Sie einen lokalen LLM über ein Hochlatenznetzwerk (z.B. Streaming vom Heimrechner auf ein Smartphone mit 5G) reverse-proxien, bietet HTTP/3 einen Vorteil. Da QUIC UDP-basiert ist, wird bei Paketverlust nur das einzelne Paket erneut gesendet, das den Token enthält, ohne den gesamten Stream zu blockieren (im Gegensatz zu TCP, das den Stream bei Paketverlusten pausiert).
Viele KI-Inferenzserver (wie vLLM’s eingebetteter FastAPI-Server) unterstützen nativ kein HTTP/3.
Best Practice Stack für 2026:
1. Betreiben Sie vLLM/Ollama lokal auf Bare-Metal (HTTP/1.1).
2. Nutzen Sie Nginx oder Envoy auf demselben Rechner, um TLS zu terminieren, proxy_buffering off anzuwenden und eine HTTP/3 (QUIC)-Grenzschicht nach außen zu setzen.
3. Stellen Sie sicher, dass der Client (React/Next.js Frontend) einen SSE-Parser nutzt, der moderne Fetch-Streams unterstützt, ohne auf den Verbindungsabschluss zu warten.
Zusammenfassung: Checkliste für Null-Latenz KI-Streams
Wenn Ihre Tokens in Chunks ankommen, prüfen Sie Folgendes:
- [ ] Anwendungsschicht: Geben Sie Daten sofort aus? (Keine großen Array-Append-Operationen vor dem Yield)
- [ ] Headers: Gibt Ihr Server
Content-Type: text/event-streamzurück? - [ ] Headers: Senden Sie
X-Accel-Buffering: no, um Nginx-Standardverhalten automatisch zu umgehen? - [ ] Proxy: Ist
proxy_buffering off;in Ihrem Nginx-Location-Block gesetzt? - [ ] Kompression: Ist Gzip/Brotli für die SSE-Route deaktiviert?
- [ ] Tunnels: Ist bei Cloudflare Response Buffering in Routing-Regeln deaktiviert?
Durch systematisches Entfernen von Buffern in Ihrer Netzwerkschicht können Sie die Magie der lokalen LLMs wiederherstellen. Ihre Nutzer (und Ihre Frontend-Anwendungen) profitieren von echtem Echtzeit-Token-Delivery, das nahezu latenzfreie Interaktionen ermöglicht, die der menschlichen Konversation entsprechen.
Related InstaTunnel pages
Continue from this article into the most relevant product guides and workflows.
Related Topics
Keep building with InstaTunnel
Read the docs for implementation details or compare plans before you ship.