Hochleistungsfähige Edge-Tunneling-Architektur: Kernel-Bypass, XDP und BBR-Tuning
Erfahren Sie, wie Sie den Tunnel-Durchsatz mit Solarflare Onload, DPDK, XDP-Paketfilterung und TCP BBRv3-Tuning für hochleistungsfähiges Edge-Netzwerk beschleunigen.
Quick answer
Low-Level Networking & Kernel-Optimierung für Edge: localhost tunnel answer
A localhost tunnel gives your local app a public HTTPS URL without opening router ports, which is useful for demos, QA, mobile testing, and provider callbacks.
How do I expose localhost without opening ports?
Use a reverse HTTPS tunnel. Your machine connects outbound to the tunnel service, and the public URL forwards requests back to your local app.
When should I use a localhost tunnel?
Use one for webhook testing, OAuth callbacks, client demos, QA previews, mobile device checks, and short-lived development reviews.
In latenzempfindlichen Systemen wie Handels-Gateways, Telemetrie-Pipelines und Edge-Relay-Netzen kann der allgemeine Linux-Netzwerkstack zum Flaschenhals werden. Arbeit pro Paket im Kernel verursacht Jitter, und übergroße Warteschlangen auf der Route erhöhen die Verzögerung. Ein Tunnel-Relay, das Millionen von Paketen pro Sekunde weiterleitet, spürt beide Probleme.
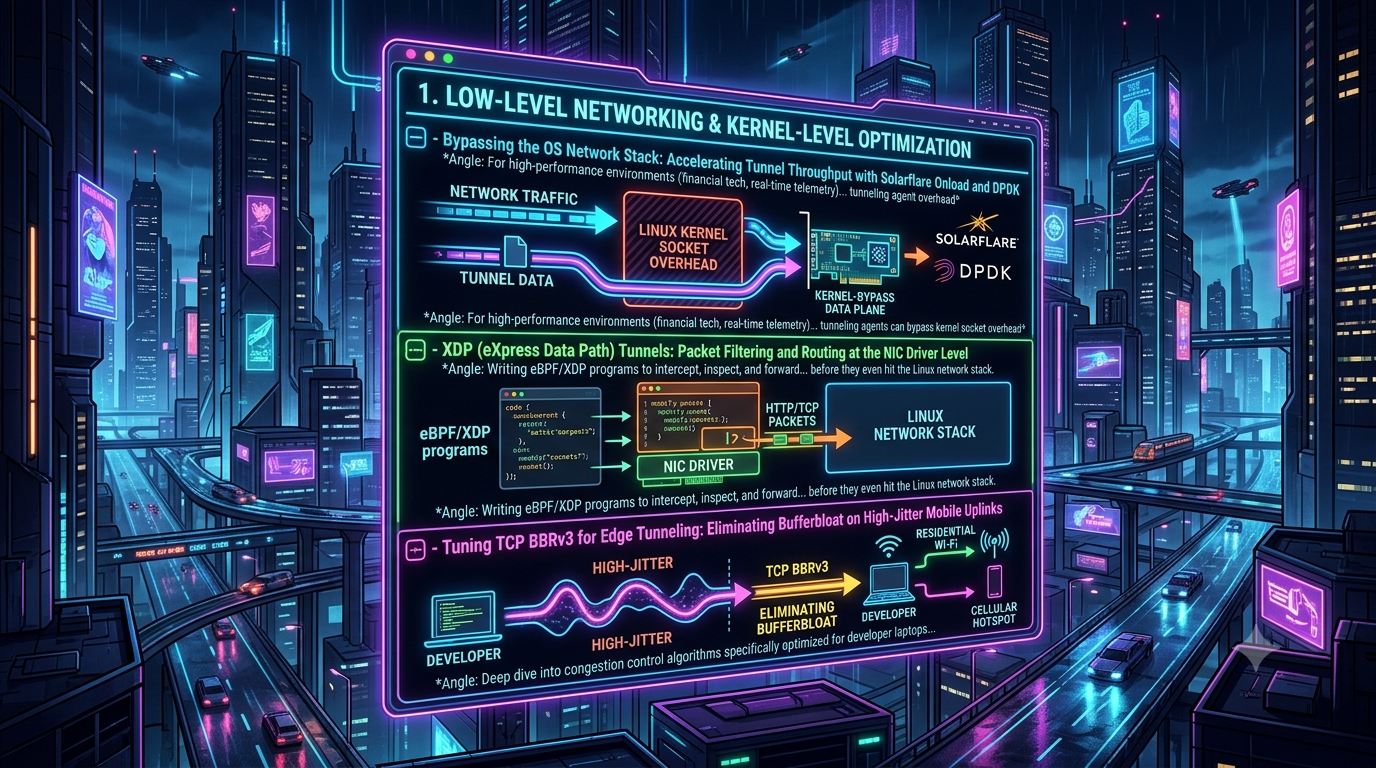
Dieses Handbuch behandelt drei Techniken, die unterschiedliche Teile des Problems angehen:
- Kernel-Bypass-Datenebenen mit AMD Solarflare Onload und dem Data Plane Development Kit (DPDK).
- eBPF/XDP (eXpress Data Path) zur Filterung und Weiterleitung von Paketen auf Treiber-Ebene, bevor der Kernel Socket-Puffer zuweist.
- BBR-Staukontrolle für Pfade mit variablem Bandbreitenangebot und tiefen Puffern, wie z.B. Mobilfunk- und Wohn-Wi-Fi-Uplinks.
Ein Vorbehalt gilt durchgehend. Nur Kernel-Bypass und XDP helfen bei der CPU-Kosten pro Paket. BBR adressiert die Warteschlangenverzögerung im Netzwerkpfad, was ein anderes Problem ist. Wählen Sie die Technik, die zu Ihrem gemessenen Flaschenhals passt.
1. Kernel-Bypass: Onload und DPDK
Wo der Standard-Stack seine Zeit verbringt
Auf dem normalen Linux-Empfangspfad löst die NIC einen Interrupt aus, und die NAPI-Schicht des Kernels pollt das Gerät. Der Treiber weist dann einen sk_buff zu, und das Paket durchläuft die Protokollschichten und Netfilter-Hooks. Schließlich kopiert ein Systemaufruf wie recv die Nutzdaten in den Benutzerspeicher.
Moderne Kerne batchen viel dieser Arbeit mit NAPI und Interrupt-Coalescing, sodass es nicht einen Interrupt pro Paket gibt. Dennoch summieren sich bei sehr hohen Paketraten die Allokation, das Kopieren, Sperren und Cache-Verkehr, was die Latenz weniger vorhersehbar macht.
Kernel-Bypass-Designs verschieben den Datenpfad in den Benutzerspeicher. Die NIC liefert Pakete per DMA in den Speicher, den die Anwendung besitzt, und die Anwendung verarbeitet sie ohne systemweite Systemaufrufe pro Paket.
Onload: Transparente Beschleunigung für Socket-Anwendungen
Solarflare wurde von Xilinx übernommen und ist jetzt Teil von AMD. Die Onload-Software wird weiterhin unter dem Namen AMD Solarflare entwickelt, mit Quellcode als OpenOnload auf GitHub.
- Funktionsweise: OpenOnload ist eine benutzerseitige Shared Library, die netzwerkbezogene Systemaufrufe abfängt und den TCP/UDP-Protokollstack in Benutzerspace implementiert. Es wird durch Kernel-Module unterstützt und ist binär kompatibel mit bestehenden BSD-sockets-Anwendungen. Die meisten Anwendungen benötigen daher keine Codeänderungen.
- Hardware-Pfad: Onload nutzt die native
ef_vi-Schnittstelle auf AMD Solarflare-Adaptern.ef_viist eine Low-Level-API mit ultrniedriger Latenz, die Anwendungen auch direkt aufrufen können. - Andere NICs: Onload kann auch über Linux’s AF_XDP-Mechanismus laufen, der keine Solarflare-Hardware benötigt. Die Dokumentation des Projekts weist darauf hin, dass der native
ef_vi-Pfad bessere Beschleunigung und zusätzliche Funktionen bietet als der AF_XDP-Modus. - Aktuelle Hardware: Die aktuelle AMD-Produktlinie ist die Alveo X3-Serie mit bis zu 4×10/25 GbE-Ports. Sie unterstützt vollständigen Kernel-Bypass durch Onload, TCPDirect und
ef_vi. TCPDirect ist ein separater Benutzerspeicher-Stack, den AMD als noch latenzärmer als Onload beschreibt. Ältere SFN8522- und SFN8542-Adapter bleiben auf der unterstützten Hardwareliste von Onload. - Kernel-Unterstützung: Das Upstream-Repository verfolgt aktuelle Kernel-Versionen, und das README listet derzeit Kernel.org-Kerne von 6.1 bis 7.0. Prüfen Sie dies, bevor Sie eine Kernel-Version festlegen.
DPDK: Ein Polling-Framework, das Sie um Ihre Anwendung bauen
DPDK ist ein Benutzerspeicher-Framework, das auf Poll-Mode-Treibern (PMDs) basiert. Ihre Anwendung pollt die NIC-Empfangsqueues in einer Schleife, es gibt keine Interrupts auf dem Datenpfad. Paketpuffer stammen aus großen Speicherpools. Anders als Onload ist DPDK nicht transparent: Sie schreiben Ihre eigene Paketverarbeitungs-Schleife, und die NIC wird für die Dauer vom Kernel-Netzwerkstack genommen.
Für die Release-Planung ist 25.11 die aktuelle LTS-Version. DPDK folgt einem etwa vierteljährlichen Rhythmus, und der veröffentlichte Zeitplan listet 26.11.0 für den 18. November 2026.
Produktions-Checkliste für Bypass-Deployments
- Kerne isolieren. Dedizieren Sie Kerne für Polling-Threads und halten Sie andere Arbeiten von ihnen fern. Der Performance-Leitfaden von DPDK empfiehlt
isolcpuszusammen mit Hugepage-Reservierung in der Kernel-Startkonfiguration. Seit Linux 6.6 ist der Standard-Scheduler EEVDF, der CFS ersetzt. Die Kernisolation ist bei beiden Schedulern wichtig, weil ein Polling-Thread niemals einen Kern mit unrelated work teilen sollte. - Alles NUMA-lokal halten. Der DPDK-Leitfaden empfiehlt, die Polling-Kerne und die NIC auf demselben Socket zu platzieren für beste Leistung. Sie können den Node einer NIC in
/sys/bus/pci/devices/<adresse>/numa_nodefinden. Allokieren Sie Paketpuffer vom selben Node. - Hugepages beim Boot reservieren für Paket-Speicherpools.
- Planen Sie für Operationen. Eine bypassed Schnittstelle erscheint nicht mehr in
tcpdump, iptables oder den üblichen Kernel-Observability-Tools im normalen Betrieb. Planen Sie Monitoring und Debugging vor dem Live-Betrieb.
Hersteller veröffentlichen Latenzvergleiche für diese Stacks, z.B. AMDs eigener Onload versus Kernel-TCP-Ergebnisse. Betrachten Sie diese als Hersteller-Messungen auf spezifischer Hardware, Payload-Größen und Tuning, und benchmarken Sie Ihre eigene Arbeitslast.
2. XDP: Programmierbare Paketbehandlung auf Treiber-Ebene
XDP wurde in Linux 4.8 eingeführt und basiert auf eBPF. Mit nativer Treiber-Unterstützung läuft ein XDP-Programm direkt nach dem Empfang eines Pakets durch die NIC, noch bevor der Kernel einen Socket-Puffer zuweist. Das macht Drops und Redirects so günstig. Im Gegensatz zu einem vollständigen Bypass arbeitet XDP neben dem normalen Kernel-Stack, sodass herkömmliche Sockets, Tools und das restliche System weiterhin funktionieren.
Ausführungsmodi
- Native (Treiber-)Modus: der Standard- und der schnelle Pfad. Er erfordert Treiberunterstützung.
- Generic (SKB) Modus: funktioniert auf jeder Schnittstelle, indem der Hook nach der Zuweisung eines
sk_buffdurch den Stack läuft. Nützlich für Entwicklung, verliert aber die meisten Leistungsgewinne. - Hardware-Offload: das Programm läuft auf der NIC selbst. Unterstützung ist selten. Laut der Dokumentation von xdp-tools unterstützen nur Netronome/Corigine-Karten mit dem
nfp-Treiber dies im Mainline-Kernel.
Beispiel: eine Allowlist für Tunnel-Peers
Dieses Skizzenprogramm droppt UDP-Verkehr zum Tunnel-Port, es sei denn, die Quelladresse ist in einer Allowlist-Karte, die vom Benutzerspeicher gepflegt wird. Der Linux VXLAN-Treiber verwendet standardmäßig UDP-Port 8472. Der IANA-zugewiesene VXLAN-Port ist 4789, Linux behielt 8472 aus historischen Gründen. VXLAN läuft über UDP, nicht TCP. Die gleiche Logik gilt für jeden UDP-basierten Tunnel.
Dies ist eine illustrative Skizze, kein gehärteter Firewall. Erstellen und laden Sie sie mit libbpf und xdp-tools.
#include <linux/bpf.h>
#include <linux/if_ether.h>
#include <linux/in.h>
#include <linux/ip.h>
#include <linux/udp.h>
#include <bpf/bpf_helpers.h>
#include <bpf/bpf_endian.h>

#define TUNNEL_PORT 8472

struct {
    __uint(type, BPF_MAP_TYPE_HASH);
    __uint(max_entries, 1024);
    __type(key, __u32);   /* IPv4-Quelladresse */
    __type(value, __u8);
} allowed_peers SEC(".maps");

SEC("xdp")
int tunnel_peer_filter(struct xdp_md *ctx)
{
    void *data     = (void *)(long)ctx->data;
    void *data_end = (void *)(long)ctx->data_end;

    struct ethhdr *eth = data;
    if ((void *)(eth + 1) > data_end)
        return XDP_PASS;
    if (eth->h_proto != bpf_htons(ETH_P_IP))
        return XDP_PASS;

    struct iphdr *iph = (void *)(eth + 1);
    if ((void *)(iph + 1) > data_end)
        return XDP_PASS;
    if (iph->protocol != IPPROTO_UDP || iph->ihl < 5)
        return XDP_PASS;

    struct udphdr *udph = (void *)iph + (iph->ihl * 4);
    if ((void *)(udph + 1) > data_end)
        return XDP_PASS;

    if (bpf_ntohs(udph->dest) != TUNNEL_PORT)
        return XDP_PASS;

    __u32 src = iph->saddr;
    if (!bpf_map_lookup_elem(&allowed_peers, &src))
        return XDP_DROP;   /* unbekannter Peer: vor dem Stack verwerfen */

    return XDP_PASS;
}

char _license[] SEC("license") = "GPL";
XDP-Aktionen
XDP_DROP: verwirft das Paket auf Treiber-Ebene, der Puffer wird wieder in den Empfangsring zurückgeführt. Effektiv gegen Flooding und Blocklisten.XDP_PASS: übergibt das Paket, eventuell modifiziert, an den normalen Netzwerk-Stack.XDP_TX: sendet das Paket wieder aus der Schnittstelle, auf der es empfangen wurde. Load Balancer verwenden dies nach Adress-Rewrite.XDP_REDIRECT: sendet den Frame an eine andere Stelle, z.B. eine andere XDP-fähige Schnittstelle (devmap), einen anderen CPU (cpumap) oder einen Benutzerspeicher-AF_XDP-Socket (xskmap).
AF_XDP ist die Brücke zum vorherigen Abschnitt. Es ermöglicht Benutzerspeicher, rohe Frames direkt aus einer Treiber-Warteschlange zu empfangen, ohne den vollen Netzwerk-Stack zu durchlaufen. Ein AF_XDP-Socket bindet an eine einzelne netdev-Warteschlange, und der XSKMAP-Typ existiert seit Linux 4.18. Es bietet einen DPDK-ähnlichen Benutzerspeicher-Datenpfad, während die NIC unter Kernel-Kontrolle bleibt. DPDK selbst hat auch ein AF_XDP-PMD, und Onload kann AF_XDP verwenden, wie oben erwähnt.
3. Staukontrolle für variable Edge-Links
Das Problem
Mobile Hotspots, Wohnrouter und Mobilfunk-Basisstationen halten oft große Warteschlangen, was Bufferbloat verursacht. Ein verlustbasiertes Algorithmus wie CUBIC erhöht seine Fenstergröße, bis ein Puffer überläuft. Die Warteschlange bleibt voll, und die Latenz für alle Flows steigt.
Nach einem Verlustereignis reduziert CUBIC sein Stau-Fenster um den Faktor 0.7 (RFC 9438 setzt den multiplikativen Rückgangfaktor auf 0.7, im Vergleich zu 0.5 bei klassischem Reno). Es schneidet das Fenster also um etwa 30%, nicht 50%.
Was BBR anders macht
BBR ist ein modellbasierter Algorithmus. Es schätzt zwei Pfadeigenschaften:
- BtlBw: die Flaschenhals-Bandbreite, die maximale Rate, die der Pfad liefern kann.
- RTprop: die Round-Trip-Propagationsverzögerung, die Basisverzögerung bei leeren Warteschlangen.
Es steuert die Pakete mit der geschätzten Bandbreite und versucht, die in Flug befindliche Datenmenge nahe am Bandbreiten-Verzögerungs-Produkt (BDP), BtlBw × RTprop, zu halten. Das hält Warteschlangen kurz und Durchsatz hoch, ohne auf Paketverluste als Hauptsignal zu setzen.
BBRv3 ist wahrscheinlich nicht im Kernel
Das Setzen von net.ipv4.tcp_congestion_control = bbr in einem Mainline-Linux-Kernel liefert BBRv1, nicht v3. Das tcp_bbr-Modul im Mainline ist seit Linux 4.9 BBRv1. Googles BBRv3 lebt in einem separaten Branch (v3 des google/bbr-Repositories), der auf neuere Kernel umgebasst wurde. Maintainer des BBR-Codes erklärten 2025, dass net-next und Mainline noch BBR 1.x tragen. Eine spätere Aussage von Google enthielt keine Ankündigung eines neuen BBR-Releases. Es gibt keine Hinweise auf eine Mainline-Integration zum Zeitpunkt.
Da der sysctl-Wert nur bbr ist, kann man v1 von v3 nicht anhand der Einstellung unterscheiden. Prüfen Sie, wo Ihr Kernel herkommt, ob von Googles v3-Branch, einem Distributionskernel mit den Patches oder einem Drittanbieter-Kernel. Das BBRv3-README dokumentiert sysctl net.ipv4.tcp_available_congestion_control zur Überprüfung der verfügbaren Algorithmen, sowie gepatchte iproute2-Tools für die ss-Ausgabe von BBRv3.
BBRv3 wird auch standardisiert. Das IETF-Entwurf draft-ietf-ccwg-bbr, dessen letzte Revision (-06, Juli 2026) angibt, dass Version 3 des Algorithmus spezifiziert wird, soll als Experimental-RFC veröffentlicht werden.
Im Vergleich zu v1 berücksichtigen BBRv2 und v3 Verluste und ECN-Signale, um die Koexistenz mit verlustbasierten Flows wie CUBIC zu verbessern.
Wo es in einem Tunneling-Stack Anwendung findet
Staukontrolle läuft auf dem Sender der Daten. Für ein Tunnel-Relay bedeutet das:
- Die Einstellung am Relay steuert den Traffic, den es zu Clients sendet, z.B. Downloads durch den Tunnel.
- Die Einstellung eines Clients steuert seine eigenen Uploads über die lokale Uplink-Verbindung.
Nur das Ändern des Relays bewirkt nichts für die Upload-Richtung von einem Laptop auf einer Mobilfunkverbindung. Außerdem, wenn Ihr Tunnel TCP in TCP trägt, interagieren der innere und äußere Staukontroller, was bekannt für schlechtes Verhalten ist. UDP-basierte Tunnel wie WireGuard vermeiden die äußere TCP-Schleife.
Baseline sysctl-Konfiguration
Fügen Sie dies in /etc/sysctl.d/99-edge-bbr.conf ein:
# Fair Queuing qdisc: effizientes Pacing für viele Flows
net.core.default_qdisc = fq

# Verwenden Sie BBR (v1 in Mainline-Kernels; v3 nur in Kernel mit Unterstützung)
net.ipv4.tcp_congestion_control = bbr

# Erhöhen Sie Puffergrenzen für Pfade mit hohem Bandbreiten-Verzögerungs-Produkt
net.core.rmem_max = 67108864
net.core.wmem_max = 67108864
net.ipv4.tcp_rmem = 4096 87380 33554432
net.ipv4.tcp_wmem = 4096 65536 33554432
Hinweise zu diesen Einstellungen:
fqwird empfohlen, ist aber nicht zwingend erforderlich. Seit Linux 4.13 hat der TCP-Stack eine interne Pacing-Fallback-Option, sodass BBR mit anderen qdiscs funktioniert. Der Kernel-Commit erwähnt, dass ohnesch_fqTCP mit einem hochauflösenden Timer pro Socket paced.- Puffergrößen sollten zu Ihren Pfaden passen. Ein Maximalpuffer von 32 MiB eignet sich für eine etwa 1 Gbit/s-Verbindung bei ca. 250 ms RTT (≈31 MB BDP). Kleinere Werte sind für langsamere oder kürzere Pfade ausreichend. Größere Puffer kosten Speicher pro Verbindung.
- Fenster-Skalierung und Timestamps sind standardmäßig in aktuellen Kernel aktiviert.
ECN: Optional und leicht falsch zu konfigurieren
ECN ermöglicht Routern, Überlastung durch Markierung von Paketen anstelle von Drop zu signalisieren. Der Kernel-Standard für net.ipv4.tcp_ecn ist 2, was ECN bei eingehenden Verbindungen akzeptiert, aber nicht bei ausgehenden anfordert. Das Setzen auf 1 fordert ECN bei ausgehenden Verbindungen an.
Dies hilft nur, wenn der Flaschenhals-Router tatsächlich ECN-Markierungen anwendet. Gehen Sie nicht von einem kostenlosen Gewinn aus. Die eigene ECN-Logik von BBRv3 wird durch eine per-Route ecn_low-Funktion gesteuert, die im README als für Umgebungen gedacht beschrieben wird, in denen bekannt ist, dass ECN-Marken DCTCP/L4S-ähnliche Markierungen sind. Diese unterscheiden sich stark von klassischen RFC 3168-Markierungen auf einem Consumer-Router. Für einen typischen Tunnel mit unbekannten letzten Meilen-Netzen lassen Sie diese Funktion ausgeschaltet. Aktivieren Sie tcp_ecn = 1 nur nach Tests in Ihrer realen Umgebung.
Verhalten prüfen
Verwenden Sie ss, um Live-Sockets zu inspizieren:
ss -tin '( dport = :443 or sport = :443 )'
Die Ausgabe enthält pacing_rate, delivery_rate und minrtt. Bei BBRv1-Kernen erhalten Sie auch einen bbr:(...)-Block mit Bandbreiten- und RTT-Schätzungen. Bei BBRv3-Kernen zeigt die gepatchte ss aus dem BBRv3-Distribution die v3-spezifischen Zustände. Diese Felder bestätigen, dass BBR aktiv ist und was es schätzt. Sie beweisen jedoch nicht automatisch eine niedrigere Latenz. Messen Sie die Latenz unter Last, z.B. durch gleichzeitiges Pingen und einen Bulk-Transfer, und vergleichen Sie mit CUBIC und BBR.
Das richtige Werkzeug wählen
| Problem | Technik | Kosten |
|---|---|---|
| Socket-API-Anwendung ist durch Kernel-CPU und Jitter limitiert | Onload (transparent) | Spezifische NICs oder AF_XDP-Modus, plus Kernel-Modul |
| Höchste Paketrate auf einer speziell entwickelten Datenebene | DPDK | Komplette Anwendungsumgestaltung mit Polling-Schleife, dedizierte Kerne und NICs |
| Frühe Filterung oder Weiterleitung, und Sie wollen den Kernel-Stack behalten | XDP / AF_XDP | eBPF-Entwicklung, Treiberunterstützung für native Modi |
| Hohe Latenz unter Last auf variablen Last-Mile-Verbindungen | BBR mit fq, getestet gegen CUBIC |
Überprüfen Sie, welche BBR-Version Sie tatsächlich verwenden |
Für die meisten Entwickler-orientierten Tunneling-Relays sind eine XDP-Allowlist und sinnvolles Staukontroll-Tuning realistische erste Schritte. Vollständiger Kernel-Bypass gehört zu den engen Anwendungsfällen, bei denen der Kernel-Stack als Flaschenhals gemessen wurde.
Quellen
- DPDK Linux Getting-Started-Guide: NIC-Performance auf Intel-Plattformen
- DPDK Release-Status-Minuten, August 2026
- Xilinx-CNS/onload auf GitHub
- AMD Alveo X3-Serie Adapter
- Kernel-Dokumentation: BPF_MAP_TYPE_XSKMAP
- xdp-loader(8) Manual
- google/bbr, v3-Branch-README
- bbr-dev-Thread: Verwendung von BBRv3 mit neueren Kernel
- IETF Entwurf-ietf-ccwg-bbr-06
- RFC 9438: CUBIC
- Linux-Kernel-Commit 218af599fa63: Internes TCP-Pacing
- Linux 6.6 EEVDF Scheduler (Phoronix)
Related InstaTunnel pages
Continue from this article into the most relevant product guides and workflows.
Related Topics
Keep building with InstaTunnel
Read the docs for implementation details or compare plans before you ship.