Low-Level Networking & Kernel-Level Optimization: Architektur für Ultra-Hochdurchsatz-Tunnel in Go und Rust
Meistere Low-Level-Netzwerke für lokale Entwicklungstunnel. Lerne, Zero-Copy-Systemaufrufe zu implementieren, mit SO_REUSEPORT zu skalieren und Buffer-Bloat zu beheben.
Quick answer
Zero-Copy-Ingress & Kernel-Optimierung für Hochdurchsatz: webhook testing answer
For local webhook testing, run your app locally, expose it with a public HTTPS tunnel, and paste the stable callback URL into the provider dashboard.
How do I test webhooks on localhost?
Start your local server, open a public HTTPS tunnel to that port, configure the provider webhook URL, and inspect events in your local logs.
Why does a stable webhook URL matter?
Stable URLs prevent provider dashboards from needing manual callback updates every time you restart a tunnel.
Moderne verteilte Systeme, lokale Entwicklungstools für Tunneling (wie ngrok, Cloudflare Tunnels oder maßgeschneiderte Enterprise-Ingress-Gateways) und hochfrequente Webhook-Router stoßen an eine unnachgiebige Engstelle: die Linux Kernel-Benutzerraum-Grenze. Wenn Proxy-Daemons skalieren sollen, um Hunderttausende gleichzeitiger Verbindungen zu verarbeiten, die Gigabit-Telemetrie, API-Payloads oder Dateiübertragungen handhaben, brechen herkömmliche Socket-Programmierungsmuster (read() und write()) zusammen. CPU-Zyklen werden bei Kontextwechseln verschwendet, Speicherbusse saturieren durch redundantes Buffer-Kopieren, CPU-Caches thrashen, und die Latenzzeiten steigen dramatisch.
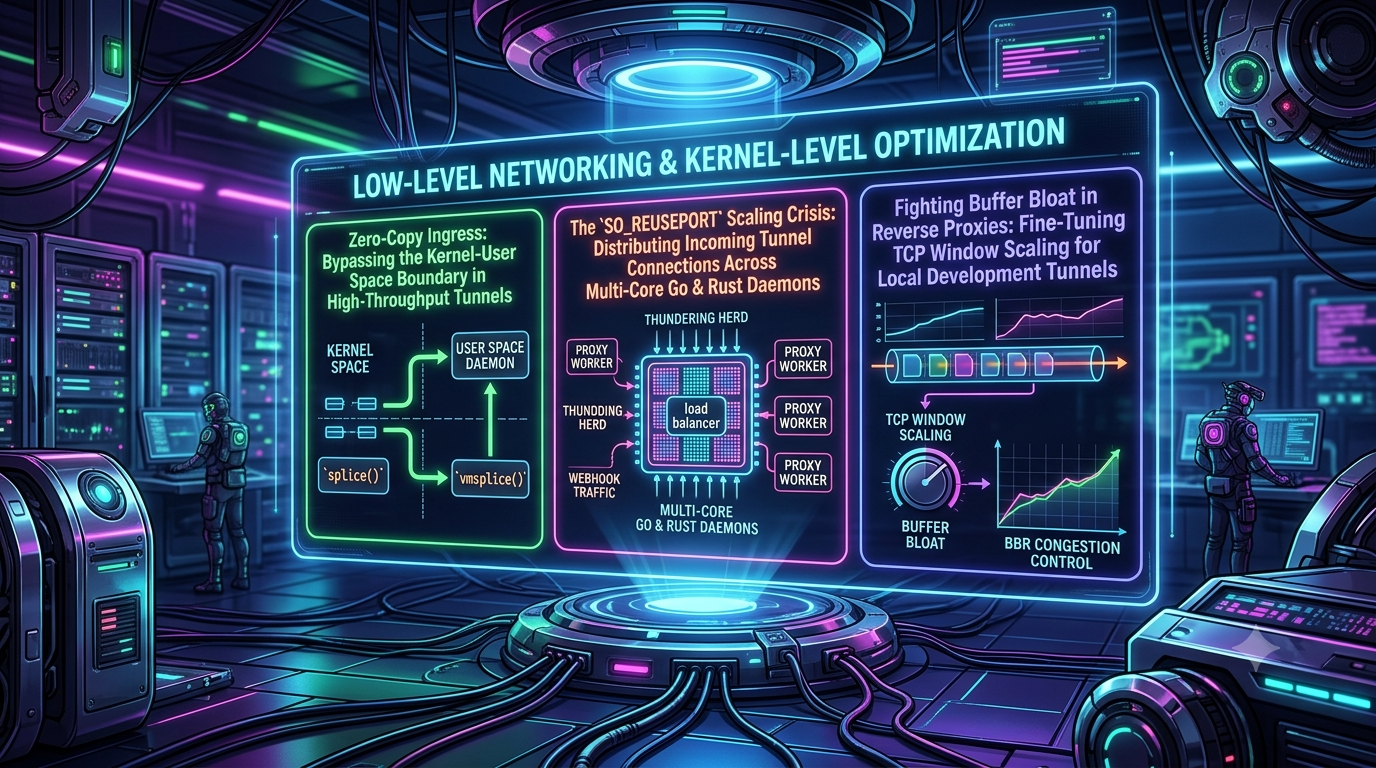
Um eine Kabelgeschwindigkeit beim Tunneling zu erreichen, ist ein tiefgehendes Verständnis des Linux-Netzwerkstacks erforderlich. Dieser umfassende Leitfaden beleuchtet drei entscheidende Säulen der Low-Level-Optimierung: das Umgehen der Kernel-Benutzerraum-Grenze mit Zero-Copy-Primitiven wie splice(), die Lösung der SO_REUSEPORT-Skalierungsproblematik bei Multi-Core-Go- und Rust-Daemons sowie die Beseitigung von Buffer-Bloat durch BBR-Staukontrolle und Socket-Tuning.
1. Zero-Copy-Ingress: Umgehen der Kernel-Benutzerraum-Grenze bei Hochdurchsatz-Tunneln
Die Kosten des Standard-I/O bei Proxies
Bei einer herkömmlichen Proxy-Daemon-Implementierung erfordert das Verschieben von Daten von einem eingehenden Netzwerk-Socket zu einer ausgehenden Tunnelverbindung mehrere Speicher-Kopien und Kontextwechsel. Betrachtet man einen traditionellen Datenpfad für eine Proxy-Payload:
- NIC zu Kernel-Socket-Puffer: Die DMA des Netzwerk-Interface-Controllers (NIC) schreibt eingehende Pakete in den Kernel-Ringpuffer (sk_buff).
- Kontextwechsel 1: Der CPU löst einen Hardware-Interrupt aus, wechselt vom Kernel- in den Benutzerspeicher, wenn die Anwendung
read()aufruft. - Kopie 1 (Kernel zu User): Der Kernel kopiert Daten vom Kernel-Socket-Read-Puffer in einen vom Proxy-Daemon zugewiesenen User-Space-Puffer (z.B. ein Byte-Slice in Go oder ein
Vec<u8>in Rust). - Kontextwechsel 2: Der Proxy-Daemon verarbeitet oder inspiziert den Header, ruft dann
write()odersend()auf, um die Payload an den Backend- oder Tunnel-Partner zu senden, und wechselt zurück in den Kernel-Space. - Kopie 2 (User zu Kernel): Der Kernel kopiert Daten vom User-Puffer in den Write-Puffer des Sockets.
- Kernel zu NIC: Der Netzwerk-Driver überträgt die Daten vom Kernel-Write-Puffer via DMA an die NIC.
Für einen Proxy, der 10 Gbps Verkehr verarbeitet, zwingt diese Architektur die CPU, jedes Byte zweimal zu kopieren und Millionen von Kontextwechseln pro Sekunde durchzuführen. Das führt zu Cache-Thrashing im CPU, da User-Space-Puffer heiße Instruktions-Caches und Arbeitssets aus L1/L2-Caches verdrängen, sowie zu erheblichen Jitter-Effekten.
Implementierung von splice() und vmsplice() in maßgeschneiderten Proxy-Daemons
Linux bietet die Systemaufrufe splice() (zusammen mit vmsplice() und tee()), um Daten zwischen zwei Dateideskriptoren zu verschieben, ohne Daten in den User-Space zu kopieren. splice() bewegt Daten in und aus einem Pipe-Puffer (pipefs), der als in-Kernel-Ringpuffer für Speicherseiten fungiert.
+---------------------------------------------------------+
|                  Traditioneller I/O-Pfad                  |
|                                                         |
|  [NIC] -e [Kernel-Socket] ---e (Kontextwechsel)             |
|                          ---e [User-Space-Puffer]        |
|                          ---e (Kontextwechsel)            |
|                          ---e [Kernel-Socket] -e [NIC]  |
+---------------------------------------------------------+

+---------------------------------------------------------+
|                     Zero-Copy `splice()`                 |
|                                                         |
|  [Eingehender Socket] --\                                |
|                      \                                |
|                       +--e [In-Kernel Pipe-Buffer]     |
|                      /                                |
|  [Ausgehender Socket] -/                                |
|  (Daten gelangen nie in den User-Space; kein Cache-Thrashing) |
+---------------------------------------------------------+
Funktionsweise von splice() im Inneren
Die Signatur von splice() in C lautet:
loff_t splice(int fd_in, loff_t *off_in, int fd_out, loff_t *off_out, size_t len, unsigned int flags);
Beim Aufbau eines Hochdurchsatz-Proxys in Rust oder Go kann splice() über Foreign Function Interfaces (FFI) oder direkte Systemaufruf-Wrapper (wie Rusts nix-Crate oder Go’s golang.org/x/sys/unix) eingebunden werden.
Um einen eingehenden Socket (client_fd) mit einem ausgehenden Tunnel-Socket (tunnel_fd) über eine Zwischen-Pipe zu verbinden:
- Erstellen einer anonymen Pipe: Während der Initialisierung des Daemons eine unidirektionale Pipe mit
pipe2(O_NONBLOCK)anlegen. - Splice Inbound in Pipe: Aufruf von
splice(client_fd, NULL, pipe_write_fd, NULL, len, SPLICE_F_MOVE | SPLICE_F_NONBLOCK). Dies weist den Kernel an, Seitenreferenzen vom Socket-Buffer direkt in den Pipe-Buffer-Ring zu zeigen, ohne Bytes zu kopieren. - Splice Pipe zum Outbound: Aufruf von
splice(pipe_read_fd, NULL, tunnel_fd, NULL, len, SPLICE_F_MOVE | SPLICE_F_NONBLOCK). Der Kernel entleert die Pipe-Seiten direkt in den Ziel-Socket-Buffer.
Architektonische Fallstricke & Randfälle
- Dateideskriptor-Beschränkungen: Mindestens einer der beiden Deskriptoren, die an
splice()übergeben werden, muss auf eine Pipe verweisen. Direkte Splices von Socket A zu Socket B sind nicht möglich; es muss über eine Zwischen-Pipe vermittelt werden. - Nicht-blockierende Semantik: Proxy-Implementierungen müssen
EAGAIN-Fehler elegant handhaben. Wenn die Pipe voll ist oder der Socket-Buffer keine Daten mehr aufnehmen kann, gibtsplice()-1miterrno = EAGAINzurück, was eine Integration in epoll/kqueue-Event-Schleifen erfordert. - TLS und Entschlüsselung:
splice()arbeitet nur mit rohen Byte-Streams. Wenn dein Tunnel TLS-Entschlüsselung am Proxy-Layer durchführt, kannsplice()auf verschlüsseltem Ciphertext nicht direkt angewandt werden, es sei denn, Kernel-Level-TLS (KTLS) wird genutzt (setsockoptmitSOL_TCPundTCP_ULP). Mit aktivierter KTLS-Implementierung verarbeitet der Kernel TLS-Entschlüsselung innerhalb des Kernel, sodasssplice()Klartext-Payloads direkt in Proxy-Routing-Pipes streamen kann.
2. Die SO_REUSEPORT-Skalierungskrise: Verteilung eingehender Tunnel-Verbindungen auf Multi-Core-Go- & Rust-Daemons
Das Thundering Herd-Problem und Single-Socket-Flaschenhals
Historisch basierten Hochleistungsnetzwerk-Daemons auf einem einzelnen Master-Socket (listenfd). Wenn eine neue TCP-Verbindung durch den 3-Wege-Handshake ankam, weckte der Kernel die wartenden Worker-Threads oder Prozesse, die auf accept() blockierten.
Dieses Design führt zum berüchtigten Thundering Herd-Problem: Alle Worker-Threads wachen gleichzeitig auf, konkurrieren um das Mutex um die Akzeptanz-Warteschlange, und nur ein Thread akzeptiert die Verbindung, während die anderen wieder schlafen. Auf einem 128-Kern-Server mit 100.000 neuen Verbindungen pro Sekunde führt dies zu katastrophaler CPU-Lock-Konflikt auf sk_lock, was die Latenz in die Höhe treibt.
Einführung von SO_REUSEPORT
Um den Single-Listener-Flaschenhals zu beseitigen, führte Linux die Socket-Option SO_REUSEPORT (erweitert ab Linux 3.9+) ein. SO_REUSEPORT erlaubt mehreren unabhängigen Sockets, exakt dieselbe IP-Adresse und Port-Kombination zu binden.
Wenn eine Verbindung ankommt, nutzt die TCP-Schicht des Kernels einen Hash-Algorithmus basierend auf dem 4-Tupel (Quell-IP, Quellport, Ziel-IP, Zielport) in Kombination mit einem per-Socket-Seed, um die eingehende Verbindung direkt an einen bestimmten Listener-Socket zu routen. Jeder Worker-Thread oder Prozess hält seinen eigenen Listener-Socket und eine eigene Akzeptanz-Warteschlange, was den Lock-Konflikt vollständig eliminiert.
                         [Eingehendes TCP SYN-Paket]
                                     |
                                     v
                       +---------------------------+
                       | Kernel 4-Tupel-Hash-Ring |
                       +---------------------------+
                        /            |            \
                       /             |             \
                      v              v              v
               [Worker-Thread 1] [Worker-Thread 2] [Worker-Thread 3]
               (SO_REUSEPORT)    (SO_REUSEPORT)    (SO_REUSEPORT)
Implementierung von SO_REUSEPORT in Go- und Rust-Daemons
Herausforderung bei der Go-Implementierung
Go verwaltet das Netzwerk-Polling über den internen netpoller (basierend auf epoll unter Linux) und abstrahiert die Socket-Erstellung im net-Paket. Standardmäßig setzt net.Listen SO_REUSEPORT nicht.
Um SO_REUSEPORT in Go für Multi-Core-Proxy-Scaling zu nutzen, muss der Socket vor dem Binden mit einem syscall-Control-Callback konfiguriert werden:
package main

import (
	"context"
	"fmt"
	"net"
	"syscall"
)

func createReusePortListener(network, address string, port int) (net.Listener, error) {
	lc := net.ListenConfig{
		Control: func(network, address string, c syscall.RawConn) error {
			var err error
			c.Control(func(fd uintptr) {
				// Setze SO_REUSEADDR
				err = syscall.SetsockoptInt(int(fd), syscall.SOL_SOCKET, syscall.SO_REUSEADDR, 1)
				if err != nil {
					return
				}
				// Setze SO_REUSEPORT
				err = syscall.SetsockoptInt(int(fd), syscall.SOL_SOCKET, syscall.SO_REUSEPORT, 1)
			})
			return err
		},
	}

	addr := fmt.Sprintf("%s:%d", address, port)
	return lc.Listen(context.Background(), network, addr)
}
Rust-Implementierung
In Rust, mit async-Runtimes wie Tokio oder Mio, kannst du benutzerdefinierte Socket-Primitiven mit der Standardbibliothek oder socket2-Crate erstellen, um SO_REUSEPORT sauber auf mehrere Worker-Threads zu verteilen:
use socket2::{Domain, Protocol, Socket, Type};
use std::net::SocketAddr;

fn create_reuse_listener(addr: SocketAddr) -> std::io::Result<std::net::TcpListener> {
    let domain = Domain::for_address(addr);
    let socket = Socket::new(domain, Type::STREAM, Some(Protocol::tcp()))?;

    // Aktiviere SO_REUSEADDR und SO_REUSEPORT
    socket.set_reuse_address(true)?;
    socket.set_reuse_port(true)?;
    socket.set_nonblocking(true)?;

    socket.bind(&addr.into())?;
    socket.listen(1024)?;

    Ok(socket.into())
}
Die SO_REUSEPORT-Skalierungskrise: Verbindungsungleichgewicht bei Webhook-Bursts
Obwohl SO_REUSEPORT Lock-Konflikte löst, kann es bei bestimmten Traffic-Verteilungen zu subtilen Skalierungsproblemen kommen—z.B. bei hochfrequentem Webhook-Traffic, der von einem einzelnen Cloud-Anbieter (wie GitHub, Stripe oder Slack Webhooks) stammt.
Ursachen des Ungleichgewichts
Die Hash-Funktion des Kernels für SO_REUSEPORT basiert auf einem statischen Hash-Schlüssel, der beim Erstellen des Sockets generiert wird. Da Webhook-Traffic von einem großen Anbieter oft nur von wenigen Quell-IP-Adressen stammt, die mit einem einzigen Ziel-Proxy-Port interagieren, ist die Entropie des 4-Tupels stark eingeschränkt.
Folglich kann die Kernel-Hashfunktion Kollisionen oder Verzerrungen aufweisen, wodurch 80 % der eingehenden Webhook-Verbindungen an Worker-Thread 1 geleitet werden, während die Worker 2 bis 8 untätig bleiben. Das führt zu Thread-Starvation, Warteschlangenüberlauf und sporadischen Timeouts.
Strategien zur Abhilfe
- BPF-Load-Balancing (SO_ATTACH_REUSEPORT_CBPF / EBPF):
Anstatt sich auf den Standard-Hash des Kernels zu verlassen, können fortgeschrittene Proxies ein benutzerdefiniertes eBPF-Programm an die Listener-Sockets anhängen (
setsockoptmitSO_ATTACH_REUSEPORT_EBPF). Das eBPF-Programm inspiziert den Payload, HTTP-Header oder benutzerdefinierte Routing-Schlüssel und steuert explizit die Socket-Auswahl, um eine perfekte Round-Robin- oder Lastverteilungsstrategie zu gewährleisten. - Work-Stealing-Akzeptanzwarteschlangen: In benutzerdefinierten Rust-Async-Runtimes oder Daemon-Architekturen teilen sich Worker-Threads eine Überlauf-Ringpuffer. Wenn ein Worker seine Akzeptanzrate über seine Verarbeitungskapazität hinaus erhöht, werden neu akzeptierte Deskriptoren in eine globale Work-Stealing-Warteschlange gepusht, aus der inaktive Worker-Threads ziehen und verarbeiten können.
3. Buffer-Bloat bei Reverse-Proxies bekämpfen: Feinabstimmung der TCP-Fenster-Skalierung für lokale Entwicklungstunnel
Was ist Buffer Bloat bei Tunneling?
Lokale Entwicklungstunnel (z.B. das Freigeben eines lokalen Ports wie http://localhost:3000 für das öffentliche Internet via sichere Edge-Proxys) schaffen komplexe Netztopologien. Entwickler testen diese Tunnel häufig über Hochbandbreiten- und Hochlatenz-Verbindungen (z.B. 500 Mbps Glasfaser mit 30ms–80ms Latenz zu regionalen Edge-Knoten) oder mobile Hotspots.
Buffer Bloat tritt auf, wenn überschüssige Pufferkapazität im Netzwerkpfad—sei es in Routern, ISP-Queues oder den TCP-Socket-Puffern des Linux-Kernels—voll ausgelastet ist. Anstatt Pakete zu verwerfen, um Stau anzuzeigen, werden sie in den Zwischenspeichern aufgestaut. Bei Reverse-Proxies, die große Datei-Uploads oder Artefakt-Deployments durch einen Tunnel handhaben, führen aufgeblähte Socket-Puffer zu Latenzspitzen von 25 ms auf über 2000 ms (Bufferbloat-Latenz), was interaktive Streams zerstört und zu vorzeitigen HTTP-Gateway-Timeouts führt.
Diagnose von Latenzspitzen bei großen Datei-Uploads
Bei der Analyse eines Proxy-Daemons unter hoher Upload-Last mit Tools wie ss, bpftrace oder ethtool beobachtet man häufig:
* Aufgeblähte Send-/Receive-Queues: Die Metriken Send-Q und Recv-Q in ss -t -i bleiben hartnäckig hoch.
* Aggressives CUBIC-Stauverhalten: Das Standard-Linux-TCP-Stack nutzt traditionell den CUBIC-Algorithmus. CUBIC erhöht das Fenster aggressiv, bis Paketverluste auftreten. Bei Hochbandbreiten- und Hochlatenz-Links (hoher Bandwidth-Delay-Product, BDP) überfüllt CUBIC Router-Puffer, was zu massiven Warteschlangenverzögerungen führt.
Die BDP-Formel (Bandwidth-Delay Product)
Der BDP bestimmt, wie viel Daten “im Flug” sein können, um eine Netzwerkverbindung vollständig zu saturieren:
$$\text{BDP (Bits)} = \text{Bandbreite (bps)} \times \text{Round-Trip Time (Sekunden)}$$
Für eine 100 Mbps-Verbindung mit einer RTT von 50 ms ($0.050$s):
$$\text{BDP} = 100{,}000{,}000 \times 0.050 = 5{,}000{,}000 \text{ Bits} = 625{,}000 \text{ Bytes} \approx 610 \text{ KB}$$
Wenn der TCP-Socket-Puffer des Linux-Kernels (net.ipv4.tcp_wmem) auf ein statisches Maximum von 16 MB eingestellt ist, schaufelt der TCP-Stack 16 MB Daten in den Puffer, schneller als der Client sie bestätigen kann. Die lokalen NICs und Zwischenspeicher blähen auf, um den Überschuss zu absorbieren, was die interaktive Latenz zerstört.
Feinabstimmung von BBR-Staukontrolle und Socket-Puffern
1. Umstellung auf BBR (Bottleneck Bandwidth and RTT)
Im Gegensatz zu CUBIC, das auf Paketverluste reagiert, modelliert Google’s BBR (Bottleneck Bandwidth and Round-trip propagation time) die Netzwerkflaschenhals-Engstelle explizit. Es misst kontinuierlich die maximale Übertragungsrate und die minimale RTT, um die Paketübertragung zu steuern und Pufferüberfüllung zu vermeiden.
Um BBR auf deinem Linux-Proxy-Server zu aktivieren:
# Verfügbare Staualgorithmen prüfen
sysctl net.ipv4.tcp_available_congestion_control

# BBR sofort aktivieren
sudo sysctl -w net.core.default_qdisc=fq
sudo sysctl -w net.ipv4.tcp_congestion_control=bbr

# Permanent in /etc/sysctl.conf
echo "net.core.default_qdisc=fq" | sudo tee -a /etc/sysctl.conf
echo "net.ipv4.tcp_congestion_control=bbr" | sudo tee -a /etc/sysctl.conf
2. Dynamisches Tuning der Socket-Puffer (tcp_rmem und tcp_wmem)
Statt statischer Konfigurationen empfiehlt es sich, dynamisches Tuning in /etc/sysctl.conf zu verwenden, um hohe BDP-Tunnel ohne Buffer-Bloat zu ermöglichen:
# Min, Default, Max für Empfangspuffer (Bytes)
net.ipv4.tcp_rmem = 4096 87380 16777216

# Min, Default, Max für Sendepuffer (Bytes)
net.ipv4.tcp_wmem = 4096 65536 16777216

# TCP-Fenster-Skalierung aktivieren (RFC 1323)
net.ipv4.tcp_window_scaling = 1

# MTU-Erkennung aktivieren, um Fragmentierung zu vermeiden
net.ipv4.tcp_mtu_discovery = 1
3. Programmgesteuertes Socket-Tuning in Rust- und Go-Proxy-Daemons
Neben systemweiten sysctl-Einstellungen sollten produktive Proxy-Daemons Socket-Buffer-Größen und Staualgorithmen bei Verbindungsaufbau programmatisch konfigurieren:
Rust-Beispiel (Staualgorithmus und Buffer-Größen setzen):
use socket2::{Socket, Domain, Type, Protocol};
use std::os::unix::io::AsRawFd;

fn tune_proxy_socket(socket: &Socket) -> std::io::Result<()> {
    // Setze Send- und Empfangspuffer auf 2MB
    socket.set_send_buffer_size(2 * 1024 * 1024)?;
    socket.set_recv_buffer_size(2 * 1024 * 1024)?;

    // Setze TCP-Staualgorithmus auf BBR
    let bbr = b"bbr\0";
    unsafe {
        let ret = libc::setsockopt(
            socket.as_raw_fd(),
            libc::IPPROTO_TCP,
            libc::TCP_CONGESTION,
            bbr.as_ptr() as *const libc::c_void,
            bbr.len() as libc::socklen_t,
        );
        if ret != 0 {
            return Err(std::io::Error::last_os_error());
        }
    }
    Ok(())
}
Go-Beispiel (Socket-Optionen setzen):
import (
	"net"
	"syscall"
)

func configureSocketBuffers(c net.Conn) error {
	tcpConn, ok := c.(*net.TCPConn)
	if !ok {
		return nil
	}

	rawConn, err := tcpConn.SyscallConn()
	if err != nil {
		return err
	}

	var sockErr error
	err = rawConn.Control(func(fd uintptr) {
		// Setze Sendpuffer auf 2MB
		sockErr = syscall.SetsockoptInt(int(fd), syscall.SOL_SOCKET, syscall.SO_SNDBUF, 2*1024*1024)
		if sockErr != nil {
			return
		}
		// Setze Empfangspuffer auf 2MB
		sockErr = syscall.SetsockoptInt(int(fd), syscall.SOL_SOCKET, syscall.SO_RCVBUF, 2*1024*1024)
		if sockErr != nil {
			return
		}
		// Setze TCP-Staualgorithmus auf BBR
		sockErr = syscall.SetsockoptString(int(fd), syscall.IPPROTO_TCP, syscall.TCP_CONGESTION, "bbr")
	})

	if err != nil {
		return err
	}
	return sockErr
}
Zusammenfassung und Checkliste für die Architektur
Der Aufbau hochleistungsfähiger, latenzarmer Tunneling-Proxies erfordert das Überwinden naiver Anwendungsschicht-Ansätze und das Meistern des Linux-Kernel-Netzwerkstacks. Mit den in diesem Leitfaden vorgestellten Techniken können Entwickler große Flaschenhälse eliminieren:
- CPU-Cache-Thrashing vermeiden: Zero-Copy-Ingress mit
splice()undvmsplice()in Kombination mit Pipe-Puffern und KTLS, um große Payloads vollständig im Kernel zu halten. - Multi-Core-Daemons skalieren:
SO_REUSEPORTmit benutzerdefinierten eBPF-Paketfiltern nutzen, um eingehende Webhook- und Tunnel-Verbindungen gleichmäßig auf Worker-Threads zu verteilen, ohne Lock-Konflikte. - Buffer Bloat beseitigen: Von legacy CUBIC-Staukontrolle auf BBR umstellen, Fair Queueing (
fq) aktivieren und Socket-Buffer dynamisch an das reale Bandwidth-Delay-Produkt anpassen.
Durch die Implementierung dieser Low-Level-Optimierungen können Proxy-Daemons Millionen von Anfragen, Gigabit-Datenraten und Sub-Millisekunden-Tail-Latenzen selbst bei extremer Netzwerkauslastung aufrechterhalten.
Related InstaTunnel pages
Continue from this article into the most relevant product guides and workflows.
Related Topics
Keep building with InstaTunnel
Read the docs for implementation details or compare plans before you ship.