Solucionando el Buffer-Bloat en SSE en Túneles Locales: Garantizando Streaming sin Latencia para LLMs Locales
Elimina el buffer-bloat en SSE en tus reverse proxies. Aprende a configurar TCP nodelay y desactivar el buffering HTTP para streaming de tokens LLM sin latencia.
Quick answer
Solución Buffer-Bloat en SSE: Streaming sin Latencia para LLMs Locales: webhook testing answer
For local webhook testing, run your app locally, expose it with a public HTTPS tunnel, and paste the stable callback URL into the provider dashboard.
How do I test webhooks on localhost?
Start your local server, open a public HTTPS tunnel to that port, configure the provider webhook URL, and inspect events in your local logs.
Why does a stable webhook URL matter?
Stable URLs prevent provider dashboards from needing manual callback updates every time you restart a tunnel.
Acabas de desplegar un LLM local de última generación usando vLLM, Ollama o llama.cpp. Cuando lo pruebas en localhost, la generación de tokens es una maravilla: un flujo suave y continuo de texto que se siente instantáneamente receptivo. Pero en cuanto expones este endpoint al exterior mediante un reverse proxy (como Nginx) o un túnel local (como Cloudflare Tunnels o Ngrok), la magia desaparece.
En lugar de un flujo fluido, tu frontend recibe nada durante varios segundos, seguido de un bloque masivo y fragmentado de texto de golpe.
Si estás construyendo interfaces de IA conversacional en tiempo real, esta salida “entrecortada” de tokens arruina la experiencia de usuario (UX). Afecta tus métricas de Time to First Token (TTFT) y hace que tu aplicación parezca lenta, independientemente de la velocidad de tus GPUs.
¿El culpable? SSE Buffer-Bloat.
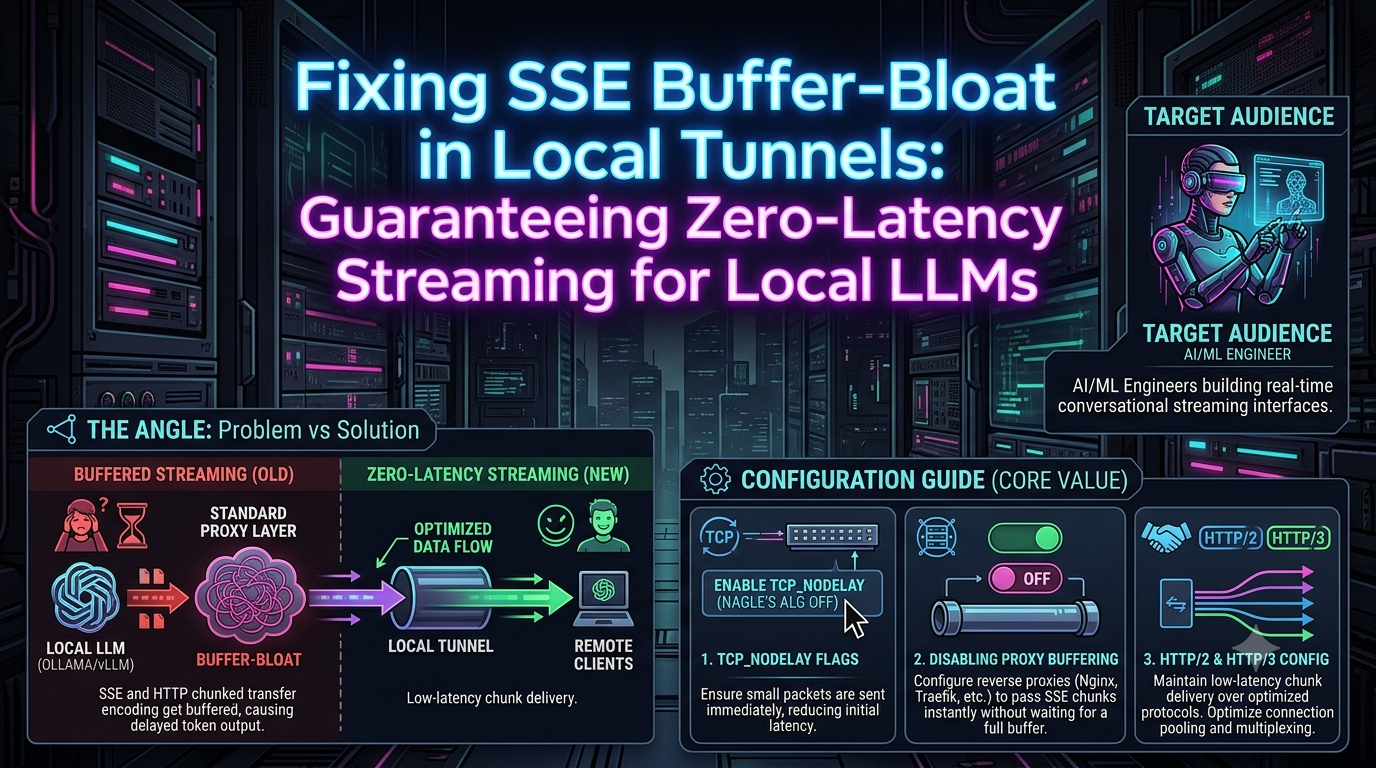
En esta guía, analizaremos por qué las capas de red estándar sabotéan inadvertidamente los Server-Sent Events (SSE) y la codificación de transferencia en chunks HTTP. Además, proporcionaremos una guía definitiva de configuración para desactivar completamente el buffering en proxy, ajustar las banderas TCP y garantizar la entrega de chunks sin latencia para tu stack de IA local.
La causa raíz: por qué los proxies rompen el streaming de LLM
Para entender la solución, primero hay que comprender el modo en que falla. El streaming de LLM normalmente depende de Server-Sent Events (SSE). En una conexión SSE, el servidor mantiene abierta una única conexión HTTP y envía datos (tokens) en cuanto se generan, usando Transfer-Encoding: chunked.
La infraestructura web estándar no fue diseñada para esto. Los proxies, balanceadores de carga y túneles están optimizados históricamente para cargas altas, payloads estáticos o dinámicos completamente renderizados. Para ahorrar ancho de banda y ciclos de CPU, emplean buffering.
1. Buffering en reverse proxy
Cuando un reverse proxy (como Nginx) se sitúa entre tu LLM y el cliente, por defecto realiza buffering de las respuestas. Nginx espera acumular cierta cantidad de datos del servidor upstream (por ejemplo, 4KB o 8KB) antes de enviarlos al cliente. Si tu LLM genera 15 tokens por segundo, puede tardar segundos en llenar ese buffer. El usuario ve una pantalla congelada, y luego aparece un párrafo enorme de golpe.
2. Algoritmo de Nagle (Capa de transporte)
A nivel TCP/IP, el algoritmo de Nagle indica que los paquetes pequeños deben retrasarse y agruparse en uno más grande para reducir congestión de red. Como los tokens de LLM son diminutos (a menudo solo unos bytes), Nagle los cachea ansiosamente, introduciendo latencia artificial en tu flujo.
3. Mismatches en protocolos de túnel
Herramientas como Cloudflare Tunnels (cloudflared) o Ngrok multiplexan tráfico sobre HTTP/2 o HTTP/3. Aunque HTTP/2 es excelente para cargar múltiples imágenes pequeñas simultáneamente, el buffering agresivo por parte del cliente del túnel puede romper el flujo continuo y sin buffer que requiere SSE.
Vamos a eliminar sistemáticamente estos buffers, capa por capa.
Capa 1: Ajuste en transporte y aplicación (Desactivar Nagle)
Antes de arreglar el proxy, asegúrate de que tu aplicación no sea el cuello de botella. Si estás escribiendo un servidor de inferencia personalizado (por ejemplo, usando Python/FastAPI para envolver un modelo ML), debes desactivar Nagle usando la bandera TCP_NODELAY.
Configurar TCP_NODELAY indica a la pila TCP que envíe los datos inmediatamente, sin esperar a llenar paquetes.
Python / FastAPI (Uvicorn)
Si usas Uvicorn, puedes forzar esto a nivel de socket. Además, asegúrate de que tu generador en la capa de aplicación realmente produzca datos sin caché interno.
from fastapi import FastAPI
from fastapi.responses import StreamingResponse
import asyncio

app = FastAPI()

async def token_generator():
    tokens = ["Hello", " world", ",", " this", " is", " streaming", " live!"]
    for token in tokens:
        # Crucial: formatear como carga útil SSE adecuada
        yield f"data: {token}\n\n"
        await asyncio.sleep(0.1) # Simular tiempo de inferencia

@app.get("/stream")
async def stream_llm():
    return StreamingResponse(
        token_generator(),
        media_type="text/event-stream",
        headers={
            "Cache-Control": "no-cache",
            "Connection": "keep-alive",
            "X-Accel-Buffering": "no" # Indica a Nginx que deje de hacer buffering
        }
    )
Nota: La cabecera X-Accel-Buffering: no es un truco muy efectivo. Muchos proxies (especialmente Nginx) respetan esta cabecera y desactivan automáticamente el buffering para esa respuesta específica.
Capa 2: Configuración del reverse proxy
Si colocas Ollama o vLLM detrás de un reverse proxy para gestionar TLS o autenticación por API key, debes configurarlo explícitamente para streaming.
Nginx
Nginx es el culpable más común del buffer-bloat en SSE. Por defecto, proxy_buffering está activado. Debes desactivarlo en tus endpoints de inferencia. Además, extiende los límites de timeout, ya que la generación de LLM puede tardar minutos.
server {
    listen 443 ssl;
    server_name api.tudominio.com;

    location /v1/chat/completions {
        proxy_pass http://localhost:8000; # backend vLLM u Ollama

        # 1. Desactivar buffering
        proxy_buffering off;
        proxy_cache off;

        # 2. Es obligatorio usar HTTP/1.1 para WebSockets/SSE en configuraciones antiguas de Nginx
        proxy_http_version 1.1;
        proxy_set_header Connection '';

        # 3. Desactivar interferencias en codificación en chunks
        chunked_transfer_encoding on;

        # 4. Evitar timeouts prematuros en prompts largos
        proxy_read_timeout 600s;
        proxy_connect_timeout 600s;
        proxy_send_timeout 600s;

        # Encabezados estándar
        proxy_set_header Host $host;
        proxy_set_header X-Real-IP $remote_addr;
    }
}
Caddy
Caddy suele ser más inteligente con estándares modernos, pero para streaming de IA sin latencia, conviene establecer explícitamente el intervalo de flush para que los chunks se envíen inmediatamente.
api.tudominio.com {
    reverse_proxy localhost:8000 {
        header_up Host {host}
        header_up X-Real-IP {remote}

        # Enviar inmediatamente, desactivando buffering interno
        flush_interval -1
    }
}
Traefik
Si usas Traefik en Docker/Kubernetes, puedes desactivar buffering mediante etiquetas o middleware.
# ejemplo docker-compose.yml
labels:
  - "traefik.http.middlewares.unbuffer.buffering.maxRequestBodyBytes=0"
  - "traefik.http.middlewares.unbuffer.buffering.memRequestBodyBytes=0"
  - "traefik.http.middlewares.unbuffer.buffering.maxResponseBodyBytes=0"
  - "traefik.http.middlewares.unbuffer.buffering.memResponseBodyBytes=0"
Capa 3: Navegando túneles locales (Cloudflare y Ngrok)
Muchos ingenieros de IA prefieren túneles locales para no exponer puertos públicos ni configurar reenvíos, pero estos introducen sus propios mecanismos agresivos de buffering.
Cloudflare Tunnels (cloudflared)
Cloudflare opera en el borde y suele hacer buffering de respuestas para aplicar reglas WAF, caching o compresión. Al pasar SSE por un túnel de Cloudflare, debes seguir dos reglas clave:
- Tipo de contenido estricto: Cloudflare bufferizará tu respuesta a menos que la cabecera
Content-Typesea exactamentetext/event-stream. Si tu app devuelveapplication/jsono texto plano mientras transmite, Cloudflare esperará a que la conexión cierre para entregar la carga útil. - Desactivar buffering en el panel: Si aún ves retrasos, puedes desactivar explícitamente el buffering en las reglas de página o configuración en el panel de Cloudflare. Crea una regla para
api.tudominio.com/*y establece Cache Level enBypassy desactiva Response Buffering.
Nota de troubleshooting: En entornos empresariales muy seguros (como Cloudflare Zero Trust o Zscaler), la transmisión bidireccional HTTP/2 puede ser interceptada y bufferizada por la capa de seguridad. Herramientas modernas (como el editor de Cursor AI) están diseñadas para volver a HTTP/1.1 SSE cuando detectan buffering en HTTP/2. Si tienes problemas con cloudflared, forzar HTTP/1.1 en tu origen puede evitar el buffering agresivo.
Ngrok
Ngrok generalmente funciona bien con SSE por defecto, siempre que las cabeceras sean correctas. Sin embargo, si usas Ngrok en los extremos, asegúrate de desactivar compresión. Gzip/Brotli requiere buffer para actuar.
Al pasar SSE por un túnel, desactiva explícitamente la compresión en las cabeceras:
Accept-Encoding: identity (cliente) o Content-Encoding: identity (servidor).
Capa 4: Consideraciones sobre HTTP/2 y HTTP/3
Con la evolución hacia HTTP/2 y HTTP/3 (QUIC), el streaming se complica.
HTTP/2 usa una única conexión TCP y multiplexa múltiples streams. Aunque resuelve el problema de head-of-line blocking para assets estáticos, las ventanas de control de flujo pueden limitar o bufferizar conexiones SSE de larga duración si no se ajustan cuidadosamente.
Si haces reverse proxy de un LLM local en una red de alta latencia (por ejemplo, desde tu equipo en casa a un móvil 5G), HTTP/3 ofrece ventajas. Como QUIC es UDP, si se pierde un paquete con un token, no bloquea la entrega de tokens siguientes (a diferencia de TCP, que reenvía y retrasa toda la transmisión).
Sin embargo, muchos servidores de inferencia (como el servidor FastAPI embebido en vLLM) no soportan HTTP/3 nativamente.
La mejor pila para 2026:
1. Ejecuta vLLM/Ollama localmente en hardware dedicado (HTTP/1.1).
2. Usa Nginx o Envoy en la misma máquina para terminar TLS, aplicar proxy_buffering off, y exponer un borde HTTP/3 (QUIC) a internet.
3. Asegúrate de que el cliente (frontend React/Next.js) use un parser SSE que soporte streams modernos sin esperar a que la conexión cierre.
Lista de verificación para streams de IA sin latencia
Si tus tokens llegan en chunks, verifica lo siguiente:
- [ ] Capa de app: ¿Estás produciendo datos inmediatamente? (¿No hay grandes acumulaciones antes de yield?)
- [ ] Headers: ¿Tu servidor devuelve
Content-Type: text/event-stream? - [ ] Headers: ¿Pasas
X-Accel-Buffering: nopara evitar buffers en Nginx automáticamente? - [ ] Proxy: ¿
proxy_buffering off;está en tu bloque de configuración de Nginx? - [ ] Compresión: ¿Gzip/Brotli están desactivados en la ruta SSE?
- [ ] Túneles: ¿En Cloudflare, Response Buffering está desactivado en tus reglas de enrutamiento?
Eliminando sistemáticamente los buffers de tu pila de red, podrás recuperar la magia de los LLMs locales. Tus usuarios (y tu frontend) disfrutarán de una entrega de tokens en tiempo real, logrando interacciones casi sin latencia, tan rápidas como una conversación humana.
Related InstaTunnel pages
Continue from this article into the most relevant product guides and workflows.
Related Topics
Keep building with InstaTunnel
Read the docs for implementation details or compare plans before you ship.