Arquitectura de Túneles de Alto Rendimiento en el Borde: Kernel Bypass, XDP y Ajuste de BBR
Aprende a acelerar el rendimiento de túneles usando Solarflare Onload, DPDK, filtrado de paquetes con XDP y ajuste de TCP BBRv3 para redes de borde de alto rendimiento.
Quick answer
Networking de Bajo Nivel y Optimización en Kernel para el Borde: localhost tunnel answer
A localhost tunnel gives your local app a public HTTPS URL without opening router ports, which is useful for demos, QA, mobile testing, and provider callbacks.
How do I expose localhost without opening ports?
Use a reverse HTTPS tunnel. Your machine connects outbound to the tunnel service, and the public URL forwards requests back to your local app.
When should I use a localhost tunnel?
Use one for webhook testing, OAuth callbacks, client demos, QA previews, mobile device checks, and short-lived development reviews.
En sistemas sensibles a la latencia, como puertas de enlace de trading, pipelines de telemetría y mallas de relé en el borde, la pila de red Linux de propósito general puede convertirse en un cuello de botella. El trabajo por paquete en el kernel añade jitter, y las colas sobredimensionadas en el camino aumentan la demora. Un relé de túnel que reenvía millones de paquetes por segundo enfrenta ambos problemas.
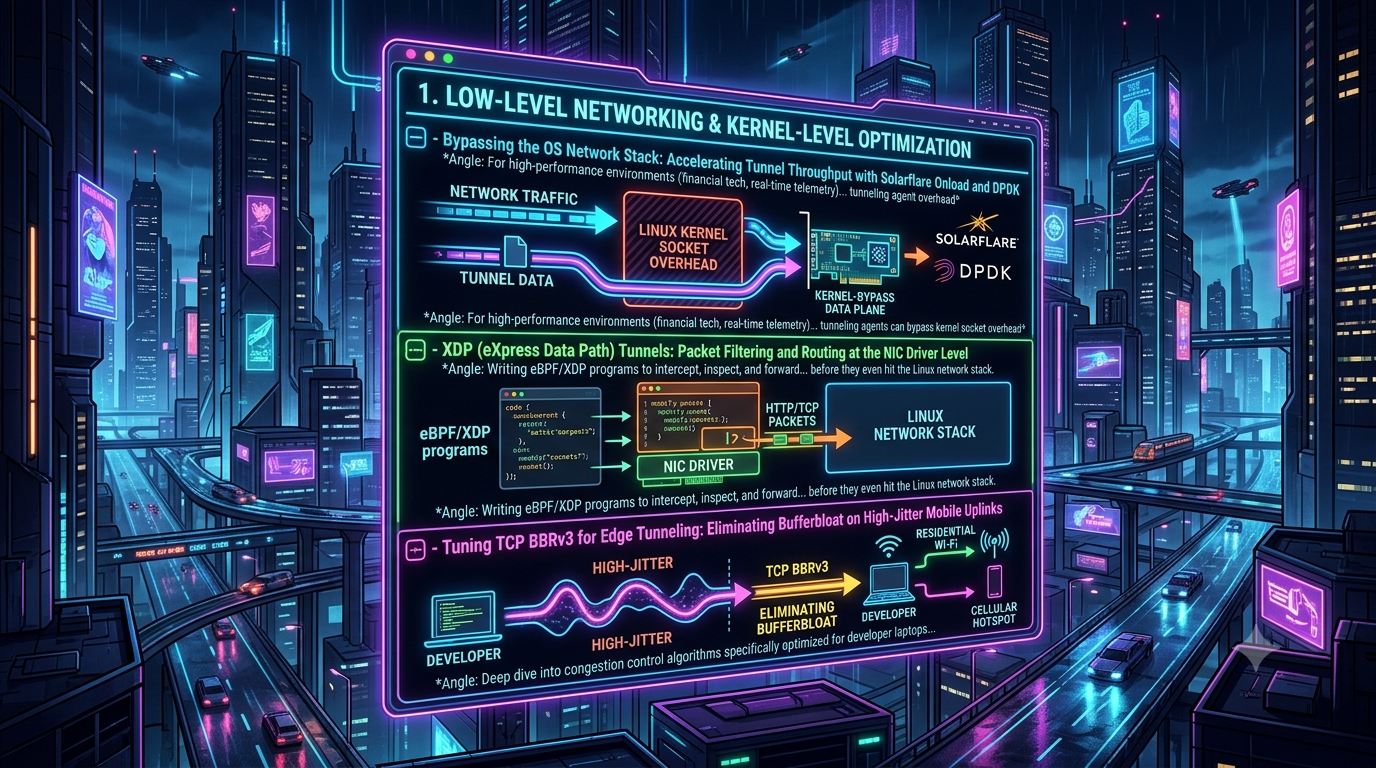
Esta guía cubre tres técnicas que abordan diferentes partes del problema:
- Planes de datos sin Kernel-bypass con AMD Solarflare Onload y el Data Plane Development Kit (DPDK).
- eBPF/XDP (eXpress Data Path) para filtrar y redirigir paquetes a nivel del controlador, antes de que el kernel asigne buffers de socket.
- Control de congestión BBR para rutas con ancho de banda variable y buffers profundos, como enlaces celulares y Wi-Fi residencial.
Una advertencia aplica en todo momento. Solo kernel bypass y XDP ayudan con el coste de CPU por paquete. BBR trata la demora por encolamiento en el camino de red, que es un problema diferente. Elige la técnica que coincida con el cuello de botella que has medido.
1. Kernel Bypass: Onload y DPDK
Dónde gasta tiempo la pila estándar
En la ruta de recepción normal de Linux, la NIC genera una interrupción y la capa NAPI del kernel hace sondeos en el dispositivo. El driver luego asigna un sk_buff, y el paquete pasa por las capas de protocolo y hooks de netfilter. Finalmente, una llamada al sistema como recv copia la carga útil en memoria de usuario.
Los kernels modernos agrupan gran parte de este trabajo con NAPI y coalescencia de interrupciones, por lo que no es una interrupción por paquete. Sin embargo, a tasas muy altas, la asignación, copia, bloqueo y tráfico de caché se acumulan y hacen que la latencia sea menos predecible.
Los diseños sin Kernel-bypass trasladan la ruta de datos al espacio de usuario. La NIC entrega paquetes mediante DMA en memoria que la aplicación posee, y la aplicación los procesa sin llamadas al sistema por paquete.
Onload: aceleración transparente para aplicaciones de socket
Solarflare fue adquirida por Xilinx y ahora forma parte de AMD. Su software Onload sigue desarrollándose bajo el nombre AMD Solarflare, con código fuente disponible como OpenOnload en GitHub.
- Cómo funciona: OpenOnload es una biblioteca compartida a nivel de usuario que intercepta llamadas relacionadas con la red y implementa la pila TCP/UDP en espacio de usuario. Es compatible con módulos del kernel y con aplicaciones BSD-socket existentes. La mayoría de las aplicaciones no necesitan cambios en el código.
- Ruta de hardware: Onload usa la interfaz nativa
ef_vien adaptadores AMD Solarflare.ef_vies una API de baja latencia que las aplicaciones también pueden llamar directamente. - Otros NICs: Onload puede también ejecutarse sobre el mecanismo AF_XDP de Linux, que no requiere hardware Solarflare. La documentación del proyecto indica que la ruta nativa
ef_viofrece mejor aceleración y funciones adicionales que el modo AF_XDP. - Hardware actual: La línea actual de AMD es la serie Alveo X3, con hasta 4 puertos 10⁄25 GbE. Soporta kernel bypass completo mediante Onload, TCPDirect y
ef_vi. TCPDirect es una pila de espacio de usuario separada que AMD describe como de menor latencia que Onload. Los adaptadores SFN8522 y SFN8542 más antiguos siguen en la lista de hardware soportado. - Soporte del kernel: El repositorio principal soporta kernels recientes, y su README lista kernels de kernel.org desde 6.1 hasta 7.0. Verifica esto antes de fijar una versión del kernel.
DPDK: un marco de sondeo que construyes a tu alrededor
DPDK es un marco de espacio de usuario basado en controladores en modo sondeo (PMDs). Tu aplicación hace sondeos en las colas de recepción NIC en un bucle activo, sin interrupciones en la ruta de datos. Los buffers de paquetes provienen de pools de memoria respaldados por hugepages. A diferencia de Onload, DPDK no es transparente: tú escribes tu propio ciclo de procesamiento de paquetes, y la NIC se retira de la pila de red del kernel durante ese tiempo.
Para planificación de versiones, la 25.11 es la versión LTS actual en upstream. DPDK sigue un ciclo de aproximadamente cuatro meses, y el calendario publicado indica la versión 26.11.0 para el 18 de noviembre de 2026.
Lista de verificación para despliegues de bypass
- Aislar núcleos. Dedica núcleos a hilos de sondeo y evita otras tareas en ellos. La guía de rendimiento de DPDK sugiere
isolcpusjunto con reserva de hugepages en la línea de comandos del kernel. Desde Linux 6.6, el planificador predeterminado es EEVDF, que reemplazó CFS. La aislamiento de núcleos importa con cualquiera de los planificadores, porque un hilo de sondeo nunca debe compartir núcleo con trabajo no relacionado. - Mantén todo NUMA-local. La guía de DPDK recomienda poner los núcleos de sondeo y la NIC en el mismo socket para mejor rendimiento. Puedes encontrar el nodo de una NIC en
/sys/bus/pci/devices/<dirección>/numa_node. Asigna buffers de paquete desde ese mismo nodo. - Reserva hugepages en el arranque para pools de memoria de paquetes.
- Planifica las operaciones. Una interfaz bypassed ya no aparece en
tcpdump, iptables o herramientas de observabilidad del kernel en la forma habitual. Planifica tu monitoreo y depuración antes de poner en marcha.
Los proveedores publican comparativas de latencia para estas pilas, como los resultados de AMD con Onload frente a TCP del kernel. Considéralas mediciones de proveedor en hardware, tamaños de carga útil y ajuste específicos, y realiza tus propios benchmarks.
2. XDP: Manejo programable de paquetes en el controlador
XDP fue introducido en Linux 4.8 y se basa en eBPF. Con soporte nativo en el driver, un programa XDP se ejecuta justo después de que la NIC recibe un paquete y antes de que el kernel asigne un buffer de socket. Esto hace que las caídas y redirecciones sean muy baratas. A diferencia de un bypass completo, XDP funciona junto con la pila normal del kernel, por lo que sockets, herramientas y el resto del sistema siguen funcionando.
Modos de ejecución
- Modo nativo (driver): el predeterminado y la ruta rápida. Requiere soporte del driver.
- Modo genérico (SKB): funciona en cualquier interfaz ejecutando el hook después de que la pila ha asignado un
sk_buff. Es útil para desarrollo, pero pierde la mayor parte del beneficio de rendimiento. - Offload de hardware: el programa se ejecuta en la NIC misma. El soporte es raro. Según la documentación de xdp-tools, solo las tarjetas Netronome/Corigine usando el driver
nfplo soportan en el kernel principal.
Ejemplo: lista blanca para pares de túneles
Este esquema descarta tráfico UDP hacia el puerto del túnel a menos que la dirección fuente esté en un mapa de lista blanca mantenido desde espacio de usuario. El driver VXLAN de Linux usa por defecto el puerto UDP 8472. El puerto VXLAN asignado por IANA es 4789, y Linux mantuvo 8472 por razones históricas. VXLAN corre sobre UDP, no TCP. La misma lógica aplica a cualquier túnel basado en UDP.
Este esquema es ilustrativo, no un firewall robusto. Construye y carga con libbpf y xdp-tools.
#include <linux/bpf.h>
#include <linux/if_ether.h>
#include <linux/in.h>
#include <linux/ip.h>
#include <linux/udp.h>
#include <bpf/bpf_helpers.h>
#include <bpf/bpf_endian.h>

#define TUNNEL_PORT 8472

struct {
    __uint(type, BPF_MAP_TYPE_HASH);
    __uint(max_entries, 1024);
    __type(key, __u32);   /* Dirección IPv4 fuente */
    __type(value, __u8);
} allowed_peers SEC(".maps");

SEC("xdp")
int tunnel_peer_filter(struct xdp_md *ctx)
{
    void *data     = (void *)(long)ctx->data;
    void *data_end = (void *)(long)ctx->data_end;

    struct ethhdr *eth = data;
    if ((void *)(eth + 1) > data_end)
        return XDP_PASS;
    if (eth->h_proto != bpf_htons(ETH_P_IP))
        return XDP_PASS;

    struct iphdr *iph = (void *)(eth + 1);
    if ((void *)(iph + 1) > data_end)
        return XDP_PASS;
    if (iph->protocol != IPPROTO_UDP || iph->ihl < 5)
        return XDP_PASS;

    struct udphdr *udph = (void *)iph + (iph->ihl * 4);
    if ((void *)(udph + 1) > data_end)
        return XDP_PASS;

    if (bpf_ntohs(udph->dest) != TUNNEL_PORT)
        return XDP_PASS;

    __u32 src = iph->saddr;
    if (!bpf_map_lookup_elem(&allowed_peers, &src))
        return XDP_DROP;   /* peer desconocido: descartar antes del stack */

    return XDP_PASS;
}

char _license[] SEC("license") = "GPL";
Acciones XDP
XDP_DROP: descarta el paquete en el driver, y el buffer se recicla en la cola de recepción. Es efectivo contra inundaciones y listas negras.XDP_PASS: entrega el paquete, posiblemente modificado, a la pila normal de red.XDP_TX: envía el paquete de vuelta por la interfaz por la que llegó. Los balanceadores usan esto tras reescribir direcciones.XDP_REDIRECT: envía la trama a otro destino, usando un mapa de redirección. Los destinos comunes son otra interfaz habilitada para XDP (devmap), otro CPU (cpumap), o un socket AF_XDP en espacio de usuario (xskmap).
AF_XDP es el puente con la sección anterior. Permite que espacio de usuario reciba tramas crudas desde una cola del driver sin recorrer toda la pila de red. Un socket AF_XDP se enlaza a una sola cola de red, y el tipo XSKMAP existe desde Linux 4.18. Ofrece una ruta de datos en espacio de usuario similar a DPDK, manteniendo el control del NIC en el kernel. DPDK también tiene un PMD AF_XDP, y Onload puede usar AF_XDP, como se mencionó.
3. Control de congestión para enlaces de borde con tasa variable
El problema
Hotspots móviles, routers residenciales y estaciones base celulares suelen mantener grandes colas, lo que causa bufferbloat. Un algoritmo basado en pérdidas como CUBIC aumenta su ventana hasta que un buffer se desborda. La cola se llena, y la latencia de cada flujo que comparte esa cola aumenta.
Tras un evento de pérdida, CUBIC reduce su ventana de congestión por un factor de 0.7 (RFC 9438 establece el factor de disminución multiplicativa en 0.7, frente a 0.5 de Reno clásico). Así, recorta la ventana en aproximadamente un 30%, no un 50%.
Qué hace diferente BBR
BBR es un algoritmo basado en modelos. Estima dos propiedades del camino:
- BtlBw: el ancho de banda del cuello de botella, la tasa máxima que puede entregar el camino.
- RTprop: el retardo de propagación de ida y vuelta, el retardo base con colas vacías.
Pauta los paquetes a la tasa estimada y trata de mantener la cantidad de datos en vuelo cerca del producto ancho de banda-retardo (BDP), que es BtlBw × RTprop. Esto mantiene las colas cortas y el rendimiento alto sin depender principalmente de pérdidas.
BBRv3 probablemente no esté en tu kernel
Configurar net.ipv4.tcp_congestion_control = bbr en un kernel Linux principal te da BBRv1, no v3. El módulo tcp_bbr en el kernel principal ha sido BBRv1 desde que se fusionó en Linux 4.9. La rama v3 de google/bbr está en un branch separado, rebased sobre kernels más recientes. Los mantenedores del código BBR indicaron en 2025 que net-next y mainline aún llevan BBR 1.x. No hay anuncio de una fusión en mainline hasta ahora.
Dado que el valor sysctl es simplemente bbr, no puedes distinguir v1 de v3 solo con esa configuración. Verifica el origen de tu kernel, si es la rama v3 de Google, un kernel de distribución con los parches, o una compilación de terceros. La documentación de BBRv3 indica usar sysctl net.ipv4.tcp_available_congestion_control para verificar algoritmos disponibles, y herramientas iproute2 parcheadas para la salida ss de BBRv3.
BBRv3 también está en proceso de estandarización. El borrador draft-ietf-ccwg-bbr del grupo de trabajo IETF CCWG, cuya última revisión (-06, julio 2026) indica que especifica la versión 3 del algoritmo, está destinado a publicarse como RFC Experimental.
En comparación con v1, BBRv2 y v3 consideran señales de pérdida y ECN para mejorar la coexistencia con flujos basados en pérdida como CUBIC.
Dónde se aplica en una pila de túneles
El control de congestión se ejecuta en el remitente de los datos. Para un relé de túnel, eso significa:
- La configuración en el relé regula el tráfico que envía a los clientes, como descargas a través del túnel.
- La configuración del cliente regula sus propias cargas hacia su uplink local.
Cambiar solo el relé no afecta la subida desde un portátil en un enlace celular. Además, si tu túnel lleva TCP dentro de TCP, los controladores de congestión interno y externo interactúan, lo cual es una causa conocida de mal comportamiento. Los túneles basados en UDP, como WireGuard, evitan ese ciclo TCP externo.
Configuración básica de sysctl
Pon esto en /etc/sysctl.d/99-edge-bbr.conf:
# Qdisc de cola justa: gestiona el pacing eficientemente para muchas cargas
net.core.default_qdisc = fq

# Usa BBR (v1 en kernels principales; v3 solo en kernels que lo soportan)
net.ipv4.tcp_congestion_control = bbr

# Aumenta los límites de buffers para caminos con alto producto ancho de banda-retardo
net.core.rmem_max = 67108864
net.core.wmem_max = 67108864
net.ipv4.tcp_rmem = 4096 87380 33554432
net.ipv4.tcp_wmem = 4096 65536 33554432
Notas sobre estas configuraciones:
fqes recomendable, no obligatorio. Desde Linux 4.13, la pila TCP tiene un fallback interno de pacing, así que BBR funciona con otros qdiscs. El commit del kernel indica que sinsch_fq, TCP pacea con un temporizador de alta resolución por socket. El mantenedor de red Linux, Eric Dumazet, recomienda usarsch_fqen escala.- Los tamaños de buffer deben coincidir con tus caminos. Un buffer máximo de 32 MiB es adecuado para un camino de aproximadamente 1 Gbit/s con unos 250 ms de RTT (≈31 MB de BDP). Valores menores sirven para caminos más lentos o cortos. Buffers mayores consumen más memoria por conexión.
- El escalado de ventana y los timestamps están habilitados por defecto en kernels actuales, así que no necesitan entradas.
ECN: opcional y fácil de configurar mal
ECN permite a los routers señalar congestión marcando paquetes en lugar de descartarlos. El valor predeterminado en el kernel para net.ipv4.tcp_ecn es 2, que acepta ECN en conexiones entrantes pero no lo solicita en salientes. Configurarlo a 1 solicita ECN en conexiones salientes también.
Esto solo ayuda si el router en el cuello de botella realmente aplica marcas ECN. No asumas que es una victoria automática. La lógica ECN de BBRv3 se controla mediante una característica ecn_low por ruta, que la documentación describe como destinada a entornos donde las marcas ECN serán de tipo DCTCP/L4S. Estas son muy diferentes de la marca RFC 3168 clásica en un router de consumidor. Para un túnel típico con redes de última milla desconocidas, deja esa opción desactivada. Activa tcp_ecn = 1 solo tras probar en tus caminos reales.
Verificando comportamiento
Usa ss para inspeccionar sockets activos:
ss -tin '( dport = :443 or sport = :443 )'
El resultado incluye pacing_rate, delivery_rate y minrtt. En kernels con BBRv1 también aparece un bloque bbr:(...) con estimaciones de ancho de banda y RTT. En kernels con BBRv3, ss con parches de la distribución BBRv3 muestra estado específico de v3. Estos campos confirman que BBR está activo y qué estima. No prueban latencia menor por sí mismos. Mide latencia bajo carga, por ejemplo con un ping y una transferencia masiva, comparando CUBIC y BBR.
Elegir la herramienta adecuada
| Problema | Técnica | Costo |
|---|---|---|
| Aplicación Socket-API limitada por CPU y jitter del kernel | Onload (transparente) | NICs específicos o modo AF_XDP, más el módulo kernel de Onload |
| Mayor tasa de paquetes en una capa de datos construida a medida | DPDK | Reescritura completa de la aplicación, bucle de sondeo, núcleos dedicados y NICs |
| Filtrado o redirección temprana, y quieres mantener la pila del kernel | XDP / AF_XDP | Desarrollo en eBPF, soporte del driver para modo nativo |
| Alta latencia bajo carga en enlaces de última milla variables | BBR con fq, probado contra CUBIC |
Verifica qué versión de BBR estás usando realmente |
Para la mayoría de los relés de túneles orientados a desarrolladores, una lista blanca en XDP y ajuste sensato del control de congestión son pasos iniciales realistas. Kernel bypass completo pertenece a cargas de trabajo donde la pila del kernel ha sido medida como cuello de botella.
Referencias
- Guía de inicio rápido DPDK Linux: rendimiento NIC en plataformas Intel
- Minutas de estado de lanzamiento DPDK, agosto 2026
- Xilinx-CNS/onload en GitHub
- Adaptadores AMD Alveo X3
- Documentación del kernel: BPF_MAP_TYPE_XSKMAP
- Página de manual xdp-loader(8)
- README rama v3 de google/bbr
- Hilo bbr-dev: uso de BBRv3 con kernels más recientes
- Borrador IETF- draft-ietf-ccwg-bbr-06
- RFC 9438: CUBIC
- Compromiso del kernel Linux 218af599fa63: pacing TCP interno
- Kernel Linux 6.6, scheduler EEVDF (Phoronix)
Related InstaTunnel pages
Continue from this article into the most relevant product guides and workflows.
Related Topics
Keep building with InstaTunnel
Read the docs for implementation details or compare plans before you ship.