Redes de bajo nivel y optimización a nivel kernel: Arquitectura de túneles de ultra alto rendimiento en Go y Rust
Domina redes de bajo nivel para túneles de desarrollo local. Aprende a implementar llamadas al sistema sin copia, escalar con SO_REUSEPORT y solucionar el buffer bloat.
Quick answer
Optimización de ingreso Zero-Copy y kernel para alto rendimiento: webhook testing answer
For local webhook testing, run your app locally, expose it with a public HTTPS tunnel, and paste the stable callback URL into the provider dashboard.
How do I test webhooks on localhost?
Start your local server, open a public HTTPS tunnel to that port, configure the provider webhook URL, and inspect events in your local logs.
Why does a stable webhook URL matter?
Stable URLs prevent provider dashboards from needing manual callback updates every time you restart a tunnel.
Los sistemas distribuidos modernos, las herramientas de túneles para desarrollo local (como ngrok, Cloudflare Tunnels o gateways de ingreso empresariales personalizados) y los routers de webhooks de alta frecuencia enfrentan un cuello de botella implacable: el límite entre el espacio usuario y el kernel en Linux. Cuando escalas daemons proxy para manejar cientos de miles de conexiones concurrentes procesando gigabits de telemetría, cargas útiles de API o transferencias de archivos, los patrones tradicionales de programación con sockets (read() y write()) se descomponen. Los ciclos de CPU se desperdician en cambios de contexto, los buses de memoria se saturan por copias redundantes de buffers, las cachés de CPU se sobrecargan y las latencias finales se disparan.
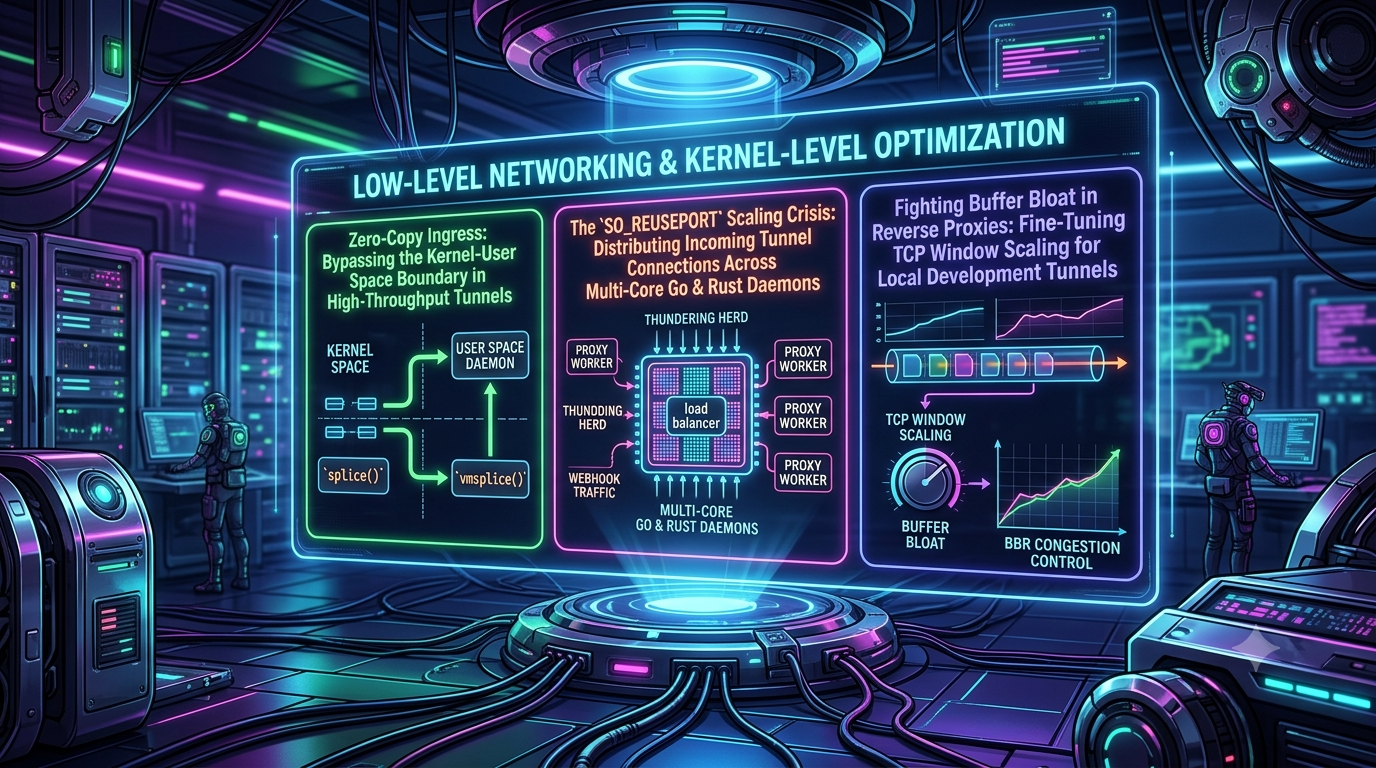
Lograr un rendimiento de túneles a velocidad de línea requiere profundizar en la pila de red de Linux. Esta guía exhaustiva explora tres pilares críticos de la optimización de bajo nivel: evitar el límite entre kernel y espacio usuario usando primitivas de cero copia como splice(), resolver la crisis de escalabilidad de SO_REUSEPORT en daemons en Go y Rust multinúcleo, y erradicar el buffer bloat mediante control de congestión BBR y ajuste de sockets.
1. Ingreso Zero-Copy: Evitar el límite entre kernel y espacio usuario en túneles de alto rendimiento
El costo del I/O estándar en proxies
En una implementación típica de daemon proxy, mover datos desde un socket de red entrante a una conexión de túnel saliente implica múltiples copias de memoria y cambios de contexto. Considera un camino de datos tradicional para una carga útil de proxy:
- NIC a Buffer de socket del kernel: La tarjeta de interfaz de red (NIC) realiza DMA y escribe los paquetes entrantes en el buffer circular del kernel (sk_buff).
- Cambio de contexto 1: La CPU genera una interrupción de hardware, pasando del espacio kernel al usuario cuando la aplicación llama a
read(). - Copia 1 (Kernel a Usuario): El kernel copia datos del buffer de lectura del socket kernel a un buffer en espacio usuario asignado por el daemon proxy (por ejemplo, un slice de bytes en Go o un
Vec<u8>en Rust). - Cambio de contexto 2: El daemon procesa o inspecciona el encabezado, luego invoca
write()osend()para transmitir la carga útil al backend o al peer del túnel, volviendo a cambiar al espacio kernel. - Copia 2 (Usuario a Kernel): El kernel copia datos del buffer en espacio usuario al buffer de escritura del socket destino.
- Kernel a NIC: El controlador de red toma los datos del buffer de escritura del kernel y los transmite vía DMA a la NIC.
Para un proxy que maneja 10 Gbps de tráfico, esta arquitectura obliga a la CPU a copiar cada byte dos veces y a soportar millones de cambios de contexto por segundo. Esto resulta en sobrecarga de caché de CPU—ya que los buffers en espacio usuario desalojan cachés de instrucciones calientes y conjuntos de trabajo de las cachés L1/L2—y genera una latencia severa.
Implementando splice() y vmsplice() en daemons proxy personalizados
Linux ofrece la llamada al sistema splice() (junto con vmsplice() y tee()) para mover datos entre dos descriptores de archivos sin copiar datos en el espacio usuario. splice() transfiere datos a y desde un buffer de tubería (pipefs), que actúa como un anillo de memoria en kernel con páginas.
+---------------------------------------------------------+
|                  Ruta I/O tradicional                   |
|                                                         |
|  [NIC] - [Socket Kernel] --- (Cambio de contexto) |
|                          --- [Buffer en espacio usuario] |
|                          --- (Cambio de contexto) |
|                          --- [Socket Kernel] - [NIC] |
+---------------------------------------------------------+

+---------------------------------------------------------+
|                     `splice()` Zero-Copy                |
|                                                         |
|  [Socket entrante] --\                                   |
|                      \                                  |
|                       +-- [Buffer en Kernel]     |
|                      /                                  |
|  [Socket saliente] -/                                   |
|  (Datos nunca entran en espacio usuario; sin sobrecarga de caché) |
+---------------------------------------------------------+
Cómo funciona splice() en el interior
La firma de splice() en C es:
loff_t splice(int fd_in, loff_t *off_in, int fd_out, loff_t *off_out, size_t len, unsigned int flags);
Al construir un daemon proxy de alto rendimiento en Rust o Go, splice() puede envolverse mediante Interfaces de Función Extranjera (FFI) o envoltorios directos de llamadas al sistema (como la crate nix en Rust o golang.org/x/sys/unix en Go).
Para enlazar un socket entrante (client_fd) con un socket de túnel saliente (tunnel_fd) usando una tubería intermedia:
- Crear una tubería anónima: Establecer un par de tuberías unidireccionales con
pipe2(O_NONBLOCK)durante la inicialización del daemon. - Splice de entrada a tubería: Llamar a
splice(client_fd, NULL, pipe_write_fd, NULL, len, SPLICE_F_MOVE | SPLICE_F_NONBLOCK). Esto indica al kernel que apunte referencias de páginas desde el buffer del socket directamente al anillo del buffer de la tubería sin copiar bytes. - Splice de tubería a salida: Llamar a
splice(pipe_read_fd, NULL, tunnel_fd, NULL, len, SPLICE_F_MOVE | SPLICE_F_NONBLOCK). El kernel vacía las páginas de la tubería directamente en el buffer del socket destino.
Consideraciones arquitectónicas y casos límite
- Restricciones en descriptores de archivos: Al menos uno de los dos descriptores pasados a
splice()debe referirse a una tubería. No puedes hacersplice()directamente de socket A a socket B; debes enrutar a través de una tubería intermedia. - Semántica no bloqueante: Los proxies deben manejar
EAGAINde manera elegante. Si la tubería está llena o el buffer del socket no puede aceptar más datos,splice()devuelve-1conerrno = EAGAIN, requiriendo integración con bucles de eventos epoll/kqueue. - TLS y descifrado:
splice()opera solo sobre flujos de bytes en bruto. Si tu túnel implementa terminación TLS en la capa proxy,splice()no puede aplicarse a cifrado cifrado a menos que utilices offloading de TLS a nivel kernel (setsockoptconSOL_TCPyTCP_ULP). Con KTLS habilitado, el kernel maneja el descifrado TLS dentro del espacio kernel, permitiendo quesplice()transmita cargas útiles en texto claro directamente en tuberías de enrutamiento proxy.
2. La crisis de escalabilidad de SO_REUSEPORT: Distribución de conexiones entrantes en daemons en Go y Rust multinúcleo
El problema del rebaño y los cuellos de botella en un solo socket
Históricamente, los daemons de red de alto rendimiento dependían de un socket maestro (listenfd). Cuando llegaba una nueva conexión TCP mediante el handshake de 3 vías, el kernel despertaba a los hilos o procesos trabajadores bloqueados en accept().
Este diseño provoca el infame problema del rebaño de toros: todos los hilos de trabajo se despiertan simultáneamente, compiten por el mutex en la cola de aceptación, y solo uno acepta la conexión mientras los demás vuelven a dormir. En un servidor sin hyperthreading de 128 núcleos manejando 100,000 nuevas conexiones por segundo, esto crea una contención catastrófica en el bloqueo del socket (sk_lock), disparando la latencia.
Introduciendo SO_REUSEPORT
Para eliminar el cuello de botella de un solo socket, Linux introdujo la opción de socket SO_REUSEPORT (ampliada en Linux 3.9+). SO_REUSEPORT permite que múltiples sockets independientes se enlacen a la misma dirección IP y puerto.
Cuando llega una conexión, la capa TCP del kernel usa un algoritmo de hashing basado en la 4-tupla (IP origen, puerto origen, IP destino, puerto destino) combinado con una semilla por socket para enrutar la conexión entrante directamente a un socket de escucha específico. Cada hilo o proceso trabajador mantiene su propio socket de escucha independiente y cola de aceptación, eliminando completamente la contención por bloqueo.
                         [Paquete TCP SYN entrante]
                                     |
                                     v
                       +---------------------------+
                       | Hash de 4-tupla en kernel |
                       +---------------------------+
                        /            |            \
                       /             |             \
                      v              v              v
               [Hilo trabajador 1] [Hilo trabajador 2] [Hilo trabajador 3]
               (SO_REUSEPORT)    (SO_REUSEPORT)    (SO_REUSEPORT)
Implementando SO_REUSEPORT en daemons en Go y Rust
El reto en Go
El runtime de Go gestiona el sondeo de red mediante su internal netpoller (basado en epoll en Linux) y abstrae la creación de sockets en el paquete net. Por defecto, net.Listen no configura SO_REUSEPORT.
Para aprovechar SO_REUSEPORT en Go y escalar en múltiples núcleos, debes configurar el socket usando un callback de control en net.ListenConfig antes de enlazar:
package main

import (
	"context"
	"fmt"
	"net"
	"syscall"
)

func createReusePortListener(network, address string, port int) (net.Listener, error) {
	lc := net.ListenConfig{
		Control: func(network, address string, c syscall.RawConn) error {
			var err error
			c.Control(func(fd uintptr) {
				// Configurar SO_REUSEADDR
				err = syscall.SetsockoptInt(int(fd), syscall.SOL_SOCKET, syscall.SO_REUSEADDR, 1)
				if err != nil {
					return
				}
				// Configurar SO_REUSEPORT
				err = syscall.SetsockoptInt(int(fd), syscall.SOL_SOCKET, syscall.SO_REUSEPORT, 1)
			})
			return err
		},
	}

	addr := fmt.Sprintf("%s:%d", address, port)
	return lc.Listen(context.Background(), network, addr)
}
La implementación en Rust
En Rust, usando runtimes asíncronos como Tokio o Mio, puedes construir primitivas de socket personalizadas usando la librería estándar o crates como socket2 para configurar SO_REUSEPORT de forma limpia en múltiples hilos de trabajo mapeados a núcleos CPU:
use socket2::{Domain, Protocol, Socket, Type};
use std::net::SocketAddr;

fn create_reuse_listener(addr: SocketAddr) -> std::io::Result<std::net::TcpListener> {
    let domain = Domain::for_address(addr);
    let socket = Socket::new(domain, Type::STREAM, Some(Protocol::tcp()))?;

    // Habilitar SO_REUSEADDR y SO_REUSEPORT
    socket.set_reuse_address(true)?;
    socket.set_reuse_port(true)?;
    socket.set_nonblocking(true)?;

    socket.bind(&addr.into())?;
    socket.listen(1024)?;

    Ok(socket.into())
}
La crisis de escalabilidad de SO_REUSEPORT: Desequilibrio en conexiones bajo picos de webhook
Aunque SO_REUSEPORT resuelve la contención por bloqueo, introduce una crisis sutil de escalabilidad en distribuciones de tráfico específicas, como tráfico de webhooks de alta frecuencia provenientes de un solo proveedor cloud (ej. GitHub, Stripe, Slack webhooks).
Causa raíz del desequilibrio
La función de hashing de 4-tupla del kernel para SO_REUSEPORT usa una clave de hash estática generada al crear el socket. Como el tráfico de webhooks de un proveedor importante suele originarse desde un conjunto limitado de IPs, interactuando con un puerto proxy único, la entropía de la 4-tupla está muy restringida.
Por ello, la función de hash puede sufrir colisiones o sesgos, enviando el 80% de las conexiones de webhook entrantes al Hilo Worker 1, mientras los Workers 2 a 8 permanecen inactivos. Esto provoca inanición de hilos, acumulación en colas y timeouts esporádicos.
Estrategias de mitigación
- Balanceo con BPF (SO_ATTACH_REUSEPORT_CBPF / EBPF):
En lugar de confiar en el hash predeterminado del kernel, proxies avanzados pueden adjuntar un programa eBPF personalizado a los sockets de escucha usando
setsockoptconSO_ATTACH_REUSEPORT_EBPF. El programa eBPF inspecciona la carga útil interna, encabezados HTTP o claves de enrutamiento personalizadas, y dirige explícitamente el índice de selección del socket, asegurando una distribución en round-robin perfecta o basada en carga entre los hilos. - Colas de aceptación con robo de trabajo: En arquitecturas de daemons en usuario (especialmente en runtimes asíncronos en Rust), los hilos de trabajo comparten una cola de desbordamiento. Si la tasa de aceptación de un hilo supera su capacidad de procesamiento, los nuevos descriptores aceptados se empujan a una cola global compartida para que hilos inactivos las tomen y procesen.
3. Combatiendo Buffer Bloat en proxies reversos: Ajuste fino del escalado de ventana TCP para túneles de desarrollo local
¿Qué es Buffer Bloat en tunneling?
Los túneles de desarrollo local (exponer un puerto local como http://localhost:3000 al internet público mediante un proxy de borde seguro) introducen topologías de red complejas. Los desarrolladores prueban estos túneles en conexiones residenciales de alta banda ancha y alta latencia (ej. fibra de 500 Mbps con 30ms–80ms de RTT) o hotspots móviles.
Buffer bloat ocurre cuando la capacidad excesiva de buffers en la ruta de red—ya sea en buffers de routers, colas de ISP o en los buffers TCP del kernel Linux—se llena completamente. En lugar de descartar paquetes para señalizar congestión, los buffers intermedios los encolan. Para proxies reversos que manejan cargas grandes de subida o despliegues de artefactos, los buffers de socket inflados causan que la latencia se dispare de 25ms a más de 2000ms (latencia inducida por Bufferbloat), rompiendo flujos interactivos y provocando timeouts prematuros en HTTP.
Diagnóstico de picos de latencia en cargas altas
Al inspeccionar un daemon proxy bajo carga de subida con herramientas como ss, bpftrace o ethtool, a menudo se observa:
* Colas de envío/recepción infladas: Las métricas Send-Q y Recv-Q en ss -t -i permanecen altas.
* Colapso de congestión CUBIC agresivo: El algoritmo CUBIC en Linux aumenta agresivamente la ventana hasta que ocurre pérdida de paquetes. En enlaces de alta banda ancha y alta latencia (alto BDP), CUBIC sobrecarga los buffers del router, causando enormes retrasos de cola antes de detectar congestión.
La matemática del BDP (Bandwidth-Delay Product)
El BDP determina cuánto dato puede estar “en vuelo” para saturar completamente un enlace:
$$\text{BDP (bits)} = \text{Ancho de banda (bps)} \times \text{RTT (segundos)}$$
Para una conexión de túnel de 100 Mbps con un RTT de 50ms ($0.050$s):
$$\text{BDP} = 100,000,000 \times 0.050 = 5,000,000 \text{ bits} = 625,000 \text{ bytes} \approx 610 \text{ KB}$$
Si el buffer TCP del kernel Linux (net.ipv4.tcp_wmem) está mal configurado con un máximo estático de 16 MB, el stack TCP llenará el buffer con más datos de los que el cliente residencial puede reconocer, inflando los buffers y arruinando la latencia interactiva.
Ajuste fino de control de congestión BBR y buffers
1. Cambiar a BBR (Bottleneck Bandwidth and RTT)
A diferencia de CUBIC, que reacciona a pérdida de paquetes, el algoritmo de control de congestión BBR de Google modela explícitamente el cuello de botella de la red. Mide la tasa máxima de entrega y el RTT mínimo continuamente, ajustando el ritmo de envío para igualar la capacidad real del camino en lugar de sobrellenar buffers.
Para habilitar BBR en tu servidor Linux que hospeda el túnel:
# Ver algoritmos de congestión disponibles
sysctl net.ipv4.tcp_available_congestion_control

# Habilitar BBR inmediatamente
sudo sysctl -w net.core.default_qdisc=fq
sudo sysctl -w net.ipv4.tcp_congestion_control=bbr

# Hacer permanente en /etc/sysctl.conf
echo "net.core.default_qdisc=fq" | sudo tee -a /etc/sysctl.conf
echo "net.ipv4.tcp_congestion_control=bbr" | sudo tee -a /etc/sysctl.conf
2. Ajuste dinámico de buffers de socket (tcp_rmem y tcp_wmem)
En lugar de dejar los buffers en valores predeterminados estáticos o sobreasignar memoria, configura un ajuste dinámico en /etc/sysctl.conf para adaptarse a BDP alto sin causar buffer bloat:
# Mínimo, predeterminado y máximo en bytes
net.ipv4.tcp_rmem = 4096 87380 16777216
net.ipv4.tcp_wmem = 4096 65536 16777216

# Habilitar escalado de ventana TCP (RFC 1323)
net.ipv4.tcp_window_scaling = 1

# Habilitar descubrimiento de MTU para evitar fragmentación
net.ipv4.tcp_mtu_discovery = 1
3. Ajuste programático en daemons proxy en Rust y Go
Además de los ajustes en sysctl, los daemons en producción deben configurar explícitamente los tamaños de buffers y el algoritmo de congestión en las conexiones de túnel entrantes y salientes en tiempo de ejecución.
Rust (configuración de congestión y buffers):
use socket2::{Socket, Domain, Type, Protocol};
use std::os::unix::io::AsRawFd;

fn tune_proxy_socket(socket: &Socket) -> std::io::Result<()> {
    // Configurar buffers de envío y recepción a 2MB
    socket.set_send_buffer_size(2 * 1024 * 1024)?;
    socket.set_recv_buffer_size(2 * 1024 * 1024)?;

    // Configurar control de congestión a BBR vía setsockopt (SOL_TCP, TCP_CONGESTION)
    let bbr = b"bbr\0";
    unsafe {
        let ret = libc::setsockopt(
            socket.as_raw_fd(),
            libc::IPPROTO_TCP,
            libc::TCP_CONGESTION,
            bbr.as_ptr() as *const libc::c_void,
            bbr.len() as libc::socklen_t,
        );
        if ret != 0 {
            return Err(std::io::Error::last_os_error());
        }
    }

    Ok(())
}
Go (configuración de opciones de socket):
import (
	"net"
	"syscall"
)

func configureSocketBuffers(c net.Conn) error {
	tcpConn, ok := c.(*net.TCPConn)
	if !ok {
		return nil
	}

	rawConn, err := tcpConn.SyscallConn()
	if err != nil {
		return err
	}

	var sockErr error
	err = rawConn.Control(func(fd uintptr) {
		// Establecer buffer de envío a 2MB
		sockErr = syscall.SetsockoptInt(int(fd), syscall.SOL_SOCKET, syscall.SO_SNDBUF, 2*1024*1024)
		if sockErr != nil {
			return
		}
		// Establecer buffer de recepción a 2MB
		sockErr = syscall.SetsockoptInt(int(fd), syscall.SOL_SOCKET, syscall.SO_RCVBUF, 2*1024*1024)
		if sockErr != nil {
			return
		}
		// Configurar control de congestión TCP a BBR
		sockErr = syscall.SetsockoptString(int(fd), syscall.IPPROTO_TCP, syscall.TCP_CONGESTION, "bbr")
	})

	if err != nil {
		return err
	}
	return sockErr
}
Resumen y lista de verificación arquitectónica
Construir proxies de túneles de alto rendimiento y baja latencia requiere superar abstracciones ingenuas de capa aplicación y dominar el subsistema de red del kernel Linux. Con las técnicas descritas en esta guía, los equipos de ingeniería pueden eliminar los principales cuellos de botella:
- Eliminar la sobrecarga de caché de CPU: Adoptar enrutamiento de ingreso sin copia con
splice()yvmsplice()junto con buffers de tubería y KTLS para mantener cargas útiles grandes completamente en espacio kernel. - Escalar daemons multinúcleo de forma segura: Utilizar
SO_REUSEPORTcombinado con filtros de paquetes eBPF personalizados para distribuir uniformemente las conexiones entrantes de webhooks y túneles entre hilos sin contención por bloqueo del rebaño. - Erradicar Buffer Bloat: Cambiar del control de congestión CUBIC heredado, habilitar BBR, configurar encolado justo (
fq) y ajustar dinámicamente los buffers de envío y recepción para coincidir con productos de retardo y ancho de banda reales.
Implementar estas optimizaciones de bajo nivel asegura que tus daemons proxy puedan sostener millones de solicitudes, gigabits de throughput y latencias finales menores a milisegundos incluso en entornos de red extremadamente volátiles.
Related InstaTunnel pages
Continue from this article into the most relevant product guides and workflows.
Related Topics
Keep building with InstaTunnel
Read the docs for implementation details or compare plans before you ship.