Multiplexed Multi-Protocol Gatewaying: Puente TCP, UDP y QUIC en un solo puerto de entrada
Aprende cómo la gateway multiplexada de múltiples protocolos conecta TCP, UDP y QUIC en un solo puerto sin agotar puertos.
Quick answer
Multiplexed Multi-Protocol Gatewaying: Puente TCP, UDP y QUIC: quick comparison answer
Choose the tunnel tool based on the network model: public HTTPS URLs for webhooks and demos, private mesh access for internal apps, and managed infrastructure when policy controls matter most.
Which tunnel tool is best for public webhook testing?
Use a public HTTPS localhost tunnel with stable URLs. InstaTunnel focuses on webhook testing, demos, OAuth callbacks, and MCP endpoint workflows.
When should I choose a private network tool instead?
Choose a private mesh or Zero Trust tool when every user and service should stay inside a controlled private network.
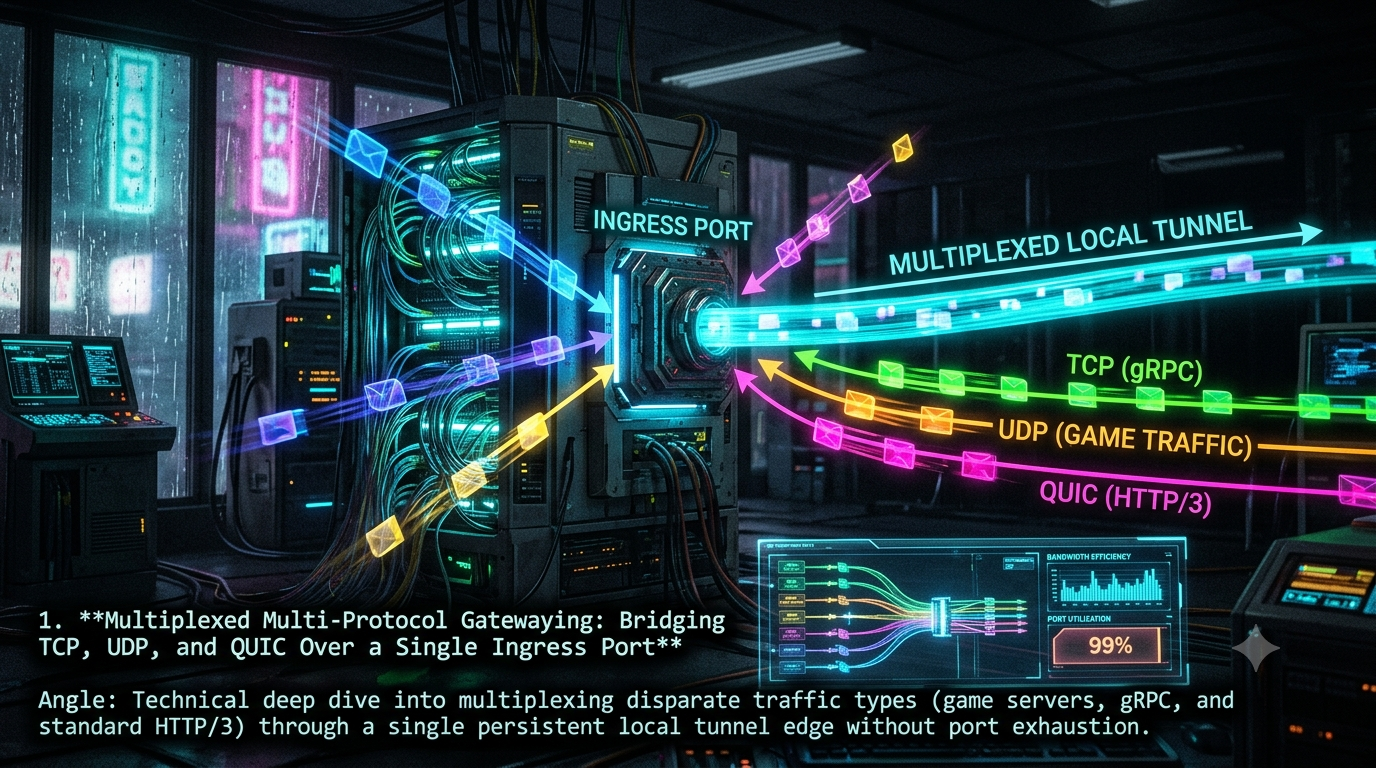
Los backends en la nube, servidores de juegos y redes edge buscan reducir la exposición de puertos. Menos puertos significan reglas de firewall más simples, menos balanceadores que administrar y menos agujeros en redes corporativas o de operadores. Un solo puerto público como 443 o 8443 puede gestionar gRPC y HTTP/2 sobre TCP, HTTP/3 sobre QUIC, y un protocolo UDP en tiempo real personalizado.
La idea es sencilla de expresar y fácil de malinterpretar sutilmente. Esta guía cubre lo que el sistema operativo ofrece gratis, cómo clasificar de forma segura el tráfico TCP y UDP, dónde ayudan eBPF y XDP, cómo los IDs de conexión QUIC afectan el enrutamiento, y qué realmente causa el agotamiento de puertos. Finaliza con una pequeña gateway en Go, probada y lista para construir.
1. Qué significa realmente “puerto único”
Un número de puerto no es un espacio de nombres único. El puerto TCP 443 y el UDP 443 son independientes, por lo que un host puede escuchar en ambos simultáneamente. HTTP/3 ya funciona así: los navegadores se conectan primero vía TCP, luego aprenden del encabezado de respuesta Alt-Svc: h3=":443" o un registro DNS HTTPS (RFC 9460). Como ese endpoint está en UDP 443, los clientes pueden necesitar volver a TCP si una red filtra UDP 443.
Por lo tanto, “un puerto” significa un número de puerto, con tres problemas adicionales a resolver:
- División de transporte. TCP y UDP se entregan a sockets diferentes por el kernel.
- Sub-protocolos TCP. TLS (y qué protocolo de aplicación transporta), HTTP/1.1 en texto claro, HTTP/2 en texto claro y flujos de bytes personalizados llegan en el mismo listener.
- Sub-protocolos UDP. QUIC y tu propio protocolo de datagramas comparten un socket UDP, y UDP no tiene un handshake para diferenciarlos.
             ┌───────────────────────────────────────────┐
             │          Ingreso público, puerto 443       │
             └───────────┬─────────────────────┬─────────┘
                         │ TCP                 │ UDP
               ┌─────────▼─────────┐   ┌───────▼────────────────┐
               │ ¿TLS? PRI?       │   │ Clasificador de primer byte │
               │ Verbo HTTP? ALPN?│   │ (rangos RFC 9443)          │
               └───┬─────┬─────┬───┘   └──────┬──────────┬──────┘
                   ▼     ▼     ▼              ▼          ▼
                 gRPC  HTTP/1  personalizado  QUIC / HTTP/3  UDP (juegos)
Hasta dónde llega la 4-tupla
Cuando una dirección de socket recibe varios protocolos, la búsqueda del kernel (protocolo, dirección y puerto fuente, dirección y puerto destino) solo llega al socket correcto. Todo lo demás es tarea del clasificador.
| Transporte | Lo que puedes inspeccionar | Marcador identificador | Estado |
|---|---|---|---|
| TCP (TLS, HTTP/2, gRPC) | Primeros bytes del flujo | 0x16 = registro de handshake TLS; ALPN en ClientHello |
Estado de conexión del kernel |
| TCP (texto claro) | Primeros bytes del flujo | PRI * HTTP/2.0… (prefacio HTTP/2) o método HTTP |
Estado de conexión del kernel |
| UDP (QUIC) | Primer byte de cada datagrama | Bit alto = encabezado largo; bits bajos según RFC 9443 | IDs de conexión QUIC, gestionados por los endpoints |
| UDP (personalizado) | Lo que defina tu protocolo | Tu propia convención en el primer byte | Tú defines |
2. La capa de sockets: no necesitas SO_REUSEPORT
Una afirmación común es que SO_REUSEPORT permite que un socket TCP y uno UDP compartan puerto. No es así. Linux mantiene las asignaciones TCP y UDP en tablas separadas, por lo que un listener TCP y un socket UDP pueden enlazarse en 0.0.0.0:443 sin opciones especiales.
SO_REUSEPORT resuelve otro problema: permite que varios sockets del mismo protocolo enlacen la misma dirección y puerto, distribuyendo las conexiones o datagramas entrantes entre ellos. Por defecto, hace hashing en la 4-tupla, y todos los sockets del grupo deben pertenecer al mismo usuario efectivo. Así escalas un listener en múltiples hilos o procesos.
En Go, la librería estándar es suficiente:
ln, _ := net.Listen("tcp", "0.0.0.0:443")        // socket TCP
pc, _ := net.ListenPacket("udp", "0.0.0.0:443")  // socket UDP, mismo puerto
Usa SO_REUSEPORT cuando quieras listeners por núcleo o reinicios sin caída. La sección 5 muestra cómo un programa eBPF puede sobreescribir el hashing por defecto.
3. Clasificación de UDP: QUIC versus tu propio protocolo
Esta es la parte difícil. Un datagrama UDP llega sin handshake, así que solo tienes el primer byte.
Lo que garantiza QUIC (y lo que no)
RFC 8999 define solo las propiedades que permanecen fijas en todas las versiones de QUIC:
- El bit más significativo del primer byte indica la forma del encabezado.
1= encabezado largo,0= encabezado corto. - Los encabezados largos llevan un campo de Versión de 32 bits (
0x00000000reservado para negociación de versión), seguido de IDs de conexión de destino y origen con longitud prefijada. - Los encabezados cortos solo llevan el ID de conexión de destino, sin campo de longitud, por lo que un gateway debe saber cuánto miden los IDs.
El Bit fijo (0x40) no es invariante. RFC 8999 lista “los paquetes QUIC siempre tienen el segundo bit del primer byte (0x40) puesto” como una suposición incorrecta que puede ser falsa en una versión dada. En la versión 1, el bit está puesto, pero RFC 9287 permite que endpoints negocien el parámetro de transporte grease_quic_bit y lo aleatoricen.
Asimismo, la versión 1 de QUIC requiere un tamaño mínimo para datagramas iniciales de cliente (1200 bytes, RFC 9000 sección 14.1), pero eso también es comportamiento de la versión 1, no invariante. Un paquete de encabezado corto no tiene una regla “mínima de 3 bytes” que puedas usar para clasificar.
El esquema estándar de multiplexación: RFC 9443
RFC 9443 (que actualiza RFC 7983) define cómo demultiplexar canales STUN, ZRTP, DTLS, TURN, RTP/RTCP y QUIC en un solo socket UDP mirando el primer byte:
| Primer byte | Protocolo |
|---|---|
| 0–3 | STUN |
| 4–15 | Descarta |
| 16–19 | ZRTP |
| 20–63 | DTLS |
| 64–79 | Canal TURN si el origen es un servidor TURN conocido, sino QUIC |
| 80–127 | QUIC (encabezado corto, bit fijo puesto) |
| 128–191 | RTP / RTCP |
| 192–255 | QUIC (encabezado largo, bit fijo puesto) |
Dos conclusiones importantes para un gateway:
- No clasifiques con “encabezado largo O bit fijo puesto”. Esa prueba, común en esquemas, coincide con aproximadamente tres cuartas partes de todos los primeros bytes. Cualquier protocolo personalizado cuyo primer byte caiga en
0x40–0xFFsería malruteado. RFC 9443 advierte que un clasificador mal implementado “podría clasificar mal los paquetes”. - Los endpoints detrás de un multiplexor no deben enviar
grease_quic_bit, porque el “engrasado” rompe el esquema del primer byte (sección 1 de RFC 9443).
Diseñando el protocolo personalizado para coexistir
Si controlas el protocolo de juego, elige un primer byte (una versión o tipo de mensaje funciona) que quede en un rango que QUIC no ocupe, como 0–63, o 128–191 si no transportas RTP. Si no puedes cambiar el protocolo, debes aceptar que la clasificación por primer byte es heurística, agregar una comprobación más fuerte en el camino de encabezado largo (el campo de Versión tiene 4 bytes en el desplazamiento 1, con valores válidos como 0x00000001 para QUIC v1 y 0x6b3343cf para QUIC v2, RFC 9369), y tratar con cuidado cualquier ambigüedad.
Procedimiento de decisión corregido
Datagrama recibido
   │
   ▼
¿byte0 en 64..127 o 192..255? ──no──► pipeline UDP personalizado
   │sí
   ▼
¿Encabezado largo (byte0 & 0x80)?
   ├─ sí ► verificar Versión (v1, v2 o 0 para negociación) ► QUIC
   └─ no  ► encabezado corto: buscar el DCID en tu tabla de conexiones
            ├─ acierto  ► mismo backend que la conexión
            └─ fallo ► descartar, o enviar al backend QUIC (puede emitir reset sin estado)
El camino del encabezado corto es el más delicado. Un gateway de paso solo puede enrutar paquetes de encabezado corto si recuerda los IDs de conexión (con estado) o si los IDs codifican la decisión de enrutamiento (ver sección 5). Sin uno de estos, solo puede enrutar por dirección del cliente, lo cual falla si cambia la IP del cliente.
4. Clasificación de TCP: ALPN, prefacios y Encrypted Client Hello
Para TCP, el gateway mira los primeros bytes del flujo sin consumirlos (recv(..., MSG_PEEK) en C, bufio.Reader.Peek en Go), y luego reenvía todo, incluyendo los bytes inspeccionados, al backend elegido.
| Primer bytes | Significado | Ruta |
|---|---|---|
0x16 + encabezado TLS |
ClientHello TLS | Parsear ALPN (abajo) |
PRI (PRI * HTTP/2.0\r\n\r\nSM\r\n\r\n) |
HTTP/2 en texto claro, “conocimiento previo” (h2c), usado por gRPC sin TLS | backend HTTP/2 / gRPC |
GET , POST, HEAD, … |
HTTP/1.1 en texto claro | backend HTTP |
| cualquier otra cosa | Protocolo personalizado | backend de respaldo |
Enrutamiento ALPN. En TLS 1.3, el ClientHello no está cifrado y contiene la extensión ALPN (tipo 16) que lista los protocolos ofrecidos (h2, http/1.1, o tokens personalizados como game-v1). El gateway lee la longitud del registro TLS del encabezado de 5 bytes, inspecciona el registro completo, analiza las extensiones y enruta por ALPN sin terminar TLS. La implementación en Go en la sección 7 hace exactamente esto y ha sido probada con ClientHellos reales de crypto/tls.
La advertencia ECH. RFC 9849 estandariza el Encrypted Client Hello. Con ECH, el cliente cifra el contenido sensible del ClientHello, protegiendo el SNI y también ALPN, dentro de un ClientHello interno. El ClientHello externo lleva valores inocuos. Por tanto, un gateway de paso solo ve lo que el cliente decide exponer en el hello externo. A medida que crece la adopción de ECH, el enrutamiento basado en ALPN será menos fiable, y las opciones son terminar TLS en el gateway o enrutar por el nombre externo. Planifica esto en lugar de asumir que ALPN siempre será visible.
5. Demultiplexación a nivel kernel: eBPF, XDP y direccionamiento de sockets
Inspeccionar en espacio de usuario cuesta una llamada al sistema por decisión y no da pista al kernel sobre dónde entregar. Dos mecanismos eBPF abordan esto, y resuelven problemas diferentes.
Opción A: programas SK_REUSEPORT (enrutamiento al socket correcto)
Un programa BPF_PROG_TYPE_SK_REUSEPORT reemplaza el hash de 4-tupla por defecto al escoger un socket de un grupo SO_REUSEPORT. Para UDP, el parche de Linux que lo introdujo describe el caso de uso: el programa puede inspeccionar la carga útil del datagrama para aprender información de conexión a nivel de aplicación, y escoger el socket desde un mapa BPF. Esto mantiene los paquetes en la pila normal del kernel y permite fijar una conexión QUIC a un trabajador específico por ID de conexión, incluso si cambia la IP del cliente. Se adjunta con setsockopt usando SO_ATTACH_REUSEPORT_EBPF (requiere CAP_SYS_ADMIN).
Opción B: XDP (actuar antes de la pila de red)
XDP corre en el nivel del driver tan pronto como la NIC entrega un paquete, antes de que el kernel asigne su buffer habitual. Katran, balanceador de carga de capa 4 de Meta, está basado en esto y describe cómo funciona “justo después de que la interfaz de red recibe el paquete… antes de que el kernel tenga oportunidad de procesarlo”, en modo driver, con modo genérico (más lento) como respaldo. XDP puede descartar, pasar, redirigir a otra interfaz, o redirigir a un socket AF_XDP.
AF_XDP es importante para el diseño, porque redirigir a él evade la pila de red del kernel: el paquete llega a una zona de memoria en espacio de usuario, y tú eres responsable de todo lo que la pila haría (checksums UDP, ARP, ICMP, demultiplexación de sockets). La documentación del kernel también especifica comportamientos que los esquemas a menudo malinterpretan:
- Un
XSKMAPse indexa por número, y una redirección solo funciona si el socket en ese índice está enlazado a la misma interfaz y cola de recepción en que llegó el paquete. Si no, se descarta. - Si el mapa está vacío en ese índice, también se descarta.
- El patrón seguro documentado es consultar primero el índice de cola y usar
XDP_PASSsi no hay socket AF_XDP enlazado. - Para tráfico específico en espacio de usuario, enrútalo a colas específicas con reglas NIC (
ethtool -N ... action <cola>).
Aquí tienes un programa XDP corregido que envía solo datagramas en rango QUIC en UDP puerto 443 a un socket AF_XDP y deja que todo lo demás (TCP, UDP personalizado, ARP, ICMP) siga en la pila del kernel. Se compila con clang -target bpf; no lo he probado en una NIC.
#include <linux/bpf.h>
#include <linux/if_ether.h>
#include <linux/in.h>
#include <linux/ip.h>
#include <linux/udp.h>
#include <bpf/bpf_helpers.h>
#include <bpf/bpf_endian.h>

#define INGRESS_PORT 443

struct {
    __uint(type, BPF_MAP_TYPE_XSKMAP);
    __uint(max_entries, 64);
    __type(key, __u32);
    __type(value, __u32);
} xsks_map SEC(".maps");

SEC("xdp")
int xdp_quic_steer(struct xdp_md *ctx)
{
    void *data_end = (void *)(long)ctx->data_end;
    void *data     = (void *)(long)ctx->data;

    struct ethhdr *eth = data;
    if ((void *)(eth + 1) > data_end)
        return XDP_PASS;
    if (eth->h_proto != bpf_htons(ETH_P_IP))
        return XDP_PASS;

    struct iphdr *iph = (void *)(eth + 1);
    if ((void *)(iph + 1) > data_end || iph->protocol != IPPROTO_UDP)
        return XDP_PASS;

    struct udphdr *udph = (void *)iph + iph->ihl * 4;
    if ((void *)(udph + 1) > data_end || udph->dest != bpf_htons(INGRESS_PORT))
        return XDP_PASS;

    unsigned char *payload = (void *)(udph + 1);
    if ((void *)(payload + 1) > data_end)
        return XDP_PASS;

    /* RFC 9443 sección 3: primer byte 64..127 o 192..255 es QUIC
     * (64..79 solo ambiguo si viene de un TURN; no se maneja aquí). */
    unsigned char b0 = *payload;
    if (!((b0 >= 64 && b0 <= 127) || b0 >= 192))
        return XDP_PASS;                 /* UDP personalizado: dejarlo en la pila del kernel */

    __u32 q = ctx->rx_queue_index;
    if (bpf_map_lookup_elem(&xsks_map, &q))
        return bpf_redirect_map(&xsks_map, q, 0);
    return XDP_PASS;                     /* sin socket AF_XDP en esta cola */
}

char _license[] SEC("license") = "GPL";
El programa maneja IPv4 sin VLAN ni fragmentación IP. Para producción, se necesita IPv6 y VLAN, además de decidir qué hacer con fragmentos.
Enrutamiento de QUIC por ID de conexión entre hosts
A escala, la pregunta es cómo enrutar paquetes de encabezado corto sin estado por flujo. Hay dos enfoques reales:
- Enrutamiento por ID de servidor. Meta describió un esquema sin estado en la Linux Plumbers Conference 2021, donde un ID de servidor codificado en los identificadores permite que el balanceador XDP enrute TCP y QUIC sin compartir estado.
- QUIC-LB. El borrador del grupo de trabajo de QUIC “QUIC-LB: Generación de IDs de conexión enrutables” define cómo codificar información de enrutamiento en IDs de conexión elegidos por el servidor. Nota su estado: a la fecha, es un borrador de Internet expirado (revisión 21, agosto 2025), no un RFC. Es una referencia de diseño, no un estándar.
6. Túneles de varios protocolos en una sola conexión de borde
Un túnel de borde (una conexión persistente saliente desde una red privada a un borde público) puede transportar los tres tipos de protocolo en una sola sesión, sin puertos entrantes en la red privada.
                BORDES PÚBLICO (puerto 443)
   flujos TCP ──┐
   datagramas QUIC ┼──► clasificador ──► multiplexor de túneles ══ una sesión exterior ══►
   datagramas UDP ┘                                                             │
                                                                                ▼
                                          LADO PRIVADO: demux por canal ► gRPC :50051
                                                                          ► HTTP/3 :9001
                                                                          ► juego  :7777
Usa la primitiva adecuada para cada tráfico
- TCP y otros flujos de bytes se mapean naturalmente en flujos (un flujo multiplexado por conexión aceptada). No los describas como “segmentos”; el túnel lleva un flujo de bytes, no segmentos TCP.
- UDP y QUIC son datagramas. Enviarlos en un solo flujo confiable y ordenado reintroduce bloqueo head-of-line y retrasos por retransmisión que el tráfico en tiempo real evita. Mejor transportarlos en datagramas no confiables. Las normas existentes cubren esto: cuadros QUIC DATAGRAM (RFC 9221), Datagramas HTTP (RFC 9297), y CONNECT-UDP (RFC 9298), que proxy UDP sobre HTTP/2 o HTTP/3 y pueden usar datagramas QUIC en HTTP/3. Si usas uno de estos, heredas compatibilidad de encuadre y soporte de proxy.
- WireGuard es un túnel de capa 3 que transporta IP sobre UDP, por lo que encaja como transporte para paquetes crudos, no como sustrato de flujo.
Un marco personalizado ilustrativo
Si construyes tu propio encuadre, mantenlo pequeño y explícito. Este diseño es un ejemplo, no un estándar:
 0                   1                   2                   3
 0 1 2 3 4 5 6 7 8 9 0 1 2 3 4 5 6 7 8 9 0 1 2 3 4 5 6 7 8 9 0 1
+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+
|  Mágico (0xA5) | Tipo de Protocolo |     ID de Canal             |
+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+
|     Token de Sesión                                          |
+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+
|     Longitud de Payload        |     Datos del Payload       |
+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+
| Campo | Tamaño | Propósito |
|---|---|---|
| Mágico | 8 bits | Verificación de límites del marco (0xA5) |
| Tipo de Protocolo | 8 bits | 0x01 datos de flujo, 0x02 datagrama UDP, 0x03 datagrama QUIC |
| ID de Canal | 16 bits | Servicio o inquilino backend |
| Token de Sesión | 32 bits | Identificador del cliente para búsqueda de estado |
| Longitud de Payload | 16 bits | Hasta 65,535 bytes, suficiente para el mayor payload UDP |
Un token de 32 bits es una clave de búsqueda, no una credencial. Todo lo que autentica un cliente de túnel debe venir de un handshake real (TLS, token firmado o claves WireGuard), nunca de un contador predecible.
7. Agotamiento de puertos, estado de sesión y qué realmente limita
El “agotamiento de puertos” se culpa de muchas cosas. Esto es lo que realmente aplica.
El límite de puertos efímeros es por destino. En Linux, el rango de salida predeterminado es 32768–60999, unos 28,232 puertos. Una conexión se identifica por su 4-tupla, así que la misma IP y puerto fuente pueden usarse para conexiones a destinos diferentes. El límite práctico aparece cuando un gateway abre muchas conexiones desde una IP fuente a una IP y puerto backend únicos: cerca del tamaño del rango.
Mitigaciones, en orden de preferencia:
- Multiplexa en lugar de un socket por cliente. Lleva múltiples flujos de cliente en unas pocas conexiones backend duraderas (HTTP/2 o tu propio encuadre). La explicación de Cloudflare sobre puertos efímeros también lo señala: conexiones duraderas y multiplexadas superan el churn.
- Distribuye en más 4-tuplas. Usa múltiples direcciones o puertos backend, o varias IPs fuente.
- Amplía o divide el rango. Aumenta el rango con
net.ipv4.ip_local_port_range; kernels más nuevos también ofrecen una opción por socketIP_LOCAL_PORT_RANGEpara dividir el rango.
Tablas de sesiones. Para tráfico sin conexión, el gateway necesita una tabla que relacione un cliente (o ID de conexión) con su ruta upstream, con un timeout inactivo para que las entradas expiren. Mantenla acotada y elimina las inactivas con agresividad; una tabla sin límite puede ser un riesgo de denegación de servicio.
Dispositivos TUN. Inyectar IPs crudos a través de una interfaz TUN (el dispositivo de clon /dev/net/tun; la interfaz creada suele llamarse tun0) enruta en capa 3, así que tu proceso no asigna puertos efímeros por cliente. Eso no equivale a “evadir” límites de puertos del OS: si el kernel hace NAT o mascaramiento para llegar al backend, aún asigna puertos fuente. Usa TUN cuando puedas enrutar end-to-end sin NAT.
Migración de conexión QUIC. QUIC separa una conexión de la IP y puerto del cliente usando IDs de conexión (RFC 9000, sección 5.1). Dos detalles cambian el comportamiento del gateway:
- Un cliente en migración cambia a un nuevo ID de conexión, no el mismo en ambos caminos. RFC 9000 requiere que los IDs no sean vinculables por observadores y que los endpoints limiten cada ID a un par de direcciones (secciones 5.1 y 9.5). Un gateway que rastrea “este CID mapea a este backend” perderá la conexión cuando el cliente cambie de red.
- Un gateway de paso no puede leer los nuevos IDs, porque los frames
NEW_CONNECTION_IDviajan cifrados. La solución es que el servidor emita IDs enrutables (enrutamiento por ID de servidor o QUIC-LB, sección 5), o que el gateway termine QUIC él mismo. La sección 5.2.3 de RFC 9000 describe la opción de fallback para balanceadores simples: los servidores pueden enviar el parámetro de transportedisable_active_migration, o usarpreferred_addresspara mover clientes a una dirección dedicada.
También, los IDs de conexión de longitud cero son frágiles tras una IP compartida: RFC 9000 prohíbe usar la misma IP y puerto para múltiples conexiones con CID cero a menos que se descarte migración y reencaminamiento NAT.
8. Gateway de referencia probado en Go
El siguiente programa implementa el diseño anterior usando solo la librería estándar:
- Escucha en un puerto para TCP y UDP.
- Para TCP, inspecciona los primeros bytes, analiza el ClientHello TLS para leer ALPN (
h2ohttp/1.1), reconoce el prefacio HTTP/2 en texto claro y métodos HTTP, y enruta todo lo demás a un backend de respaldo. Los bytes inspeccionados se reenvían al backend. - Para UDP, clasifica cada datagrama según los rangos RFC 9443 y mantiene un socket upstream por cliente y backend, con expiración inactiva, reenviando respuestas.
Lo compilé, ejecuté go vet y lo probé con backends de eco locales. Las pruebas cubren enrutamiento en texto claro (PRI, GET, bytes desconocidos), enrutamiento UDP en los límites de rango (0xC0, 0x45 a QUIC; 0x05, 0x3F, 0x90 a backend personalizado), y el analizador ALPN con ClientHellos reales (h2, http/1.1, protocolo desconocido y sin ALPN).
// Gateway TCP+UDP en un puerto: enrutamiento TCP por ALPN / prefacio TLS,
// enrutamiento UDP por rangos RFC 9443. Solo librería estándar.
package main

import (
	"bufio"
	"context"
	"io"
	"log"
	"net"
	"os"
	"os/signal"
	"sync"
	"syscall"
	"time"
)

type Config struct {
	Listen      string
	H2Backend   string // gRPC / HTTP/2
	HTTPBackend string // HTTP/1.1
	TCPFallback string // cualquier otro (protocolos TCP personalizados)
	QUICBackend string // UDP, QUIC / HTTP/3
	GameBackend string // UDP, protocolo personalizado
	UDPIdle     time.Duration
}

func main() {
	cfg := Config{
		Listen: "0.0.0.0:8443", H2Backend: "127.0.0.1:50051", HTTPBackend: "127.0.0.1:8080",
		TCPFallback: "127.0.0.1:9000", QUICBackend: "127.0.0.1:9001", GameBackend: "127.0.0.1:7777",
		UDPIdle: 60 * time.Second,
	}
	ctx, stop := signal.NotifyContext(context.Background(), os.Interrupt, syscall.SIGTERM)
	defer stop()
	go serveTCP(ctx, cfg)
	go serveUDP(ctx, cfg)
	<-ctx.Done()
}

// ---------- TCP ----------

func serveTCP(ctx context.Context, cfg Config) {
	ln, err := net.Listen("tcp", cfg.Listen)
	if err != nil {
		log.Fatalf("tcp listen: %v", err)
	}
	go func() { <-ctx.Done(); ln.Close() }()
	for {
		c, err := ln.Accept()
		if err != nil {
			return
		}
		go handleTCP(c, cfg)
	}
}

func handleTCP(c net.Conn, cfg Config) {
	defer c.Close()
	br := bufio.NewReaderSize(c, 16*1024+5)
	c.SetReadDeadline(time.Now().Add(5 * time.Second)) // límite de inspección
	backend := cfg.TCPFallback
	if hdr, err := br.Peek(5); err == nil {
		switch {
		case hdr[0] == 0x16: // registro de handshake TLS
			recLen := int(hdr[3])<<8 | int(hdr[4])
			if rec, err := br.Peek(5 + recLen); err == nil {
				switch alpnPick(rec[5:]) {
				case "h2":
					backend = cfg.H2Backend
				case "http/1.1":
					backend = cfg.HTTPBackend
				}
			}
		case string(hdr[:4]) == "PRI ": // prefacio HTTP/2 en texto claro
			backend = cfg.H2Backend
		case isHTTPVerb(hdr):
			backend = cfg.HTTPBackend
		}
	}
	c.SetReadDeadline(time.Time{})
	up, err := net.DialTimeout("tcp", backend, 3*time.Second)
	if err != nil {
		log.Printf("dial %s: %v", backend, err)
		return
	}
	defer up.Close()
	var wg sync.WaitGroup
	wg.Add(2)
	go func() { defer wg.Done(); io.Copy(up, br); closeWrite(up) }() // reenvía bytes inspeccionados
	go func() { defer wg.Done(); io.Copy(c, up); closeWrite(c) }()
	wg.Wait()
}

func closeWrite(c net.Conn) {
	if cw, ok := c.(interface{ CloseWrite() error }); ok {
		cw.CloseWrite()
	}
}

func isHTTPVerb(b []byte) bool {
	for _, v := range []string{"GET ", "POST", "HEAD", "PUT ", "DELE", "OPTI", "PATC"} {
		if string(b[:4]) == v {
			return true
		}
	}
	return false
}

// alpnPick devuelve el primer protocolo ALPN preferido por el cliente entre h2/http/1.1,
// o "" si el ClientHello no tiene extensión ALPN (o no se puede analizar).
func alpnPick(rec []byte) string {
	p := rec
	adv := func(n int) []byte {
		if len(p) < n {
			p = nil
			return nil
		}
		out := p[:n]
		p = p[n:]
		return out
	}
	if h := adv(4); h == nil || h[0] != 0x01 { // tipo handshake ClientHello + longitud 3 bytes
		return ""
	}
	adv(2 + 32) // versión legacy + random
	if l := adv(1); l != nil {
		adv(int(l[0])) // session id
	}
	if l := adv(2); l != nil {
		adv(int(l[0])<<8 | int(l[1])) // suites de cifrado
	}
	if l := adv(1); l != nil {
		adv(int(l[0])) // métodos de compresión
	}
	l := adv(2)
	if l == nil {
		return ""
	}
	exts := adv(int(l[0])<<8 | int(l[1]))
	for len(exts) >= 4 {
		typ := int(exts[0])<<8 | int(exts[1])
		n := int(exts[2])<<8 | int(exts[3])
		if len(exts) < 4+n {
			return ""
		}
		body := exts[4 : 4+n]
		exts = exts[4+n:]
		if typ != 16 || len(body) < 2 { // negociación de capa de aplicación
			continue
		}
		list := body[2:]
		for len(list) > 0 {
			k := int(list[0])
			if len(list) < 1+k {
				return ""
			}
			switch s := string(list[1 : 1+k]); s {
			case "h2", "http/1.1":
				return s
			}
			list = list[1+k:]
		}
	}
	return ""
}

// ---------- UDP ----------

// classifyUDP sigue RFC 9443 sección 3: primer byte 80..127 o 192..255 es QUIC;
// 64..79 es QUIC a menos que venga de un TURN (no manejado aquí).
// Mantén tu propio primer byte en 0..63 o 128..191.
func classifyUDP(first byte) (isQUIC bool) {
	return (first >= 64 && first <= 127) || first >= 192
}

type udpSession struct {
	up   *net.UDPConn
	seen time.Time
}

func serveUDP(ctx context.Context, cfg Config) {
	pc, err := net.ListenPacket("udp", cfg.Listen)
	if err != nil {
		log.Fatalf("udp listen: %v", err)
	}
	conn := pc.(*net.UDPConn)
	go func() { <-ctx.Done(); conn.Close() }()

	quicAddr, _ := net.ResolveUDPAddr("udp", cfg.QUICBackend)
	gameAddr, _ := net.ResolveUDPAddr("udp", cfg.GameBackend)

	var mu sync.Mutex
	sessions := map[string]*udpSession{} // clave: dirección cliente + backend

	go func() { // recolector de inactividad
		t := time.NewTicker(cfg.UDPIdle / 4)
		defer t.Stop()
		for range t.C {
			mu.Lock()
			for k, s := range sessions {
				if time.Since(s.seen) > cfg.UDPIdle {
					s.up.Close()
					delete(sessions, k)
				}
			}
			mu.Unlock()
		}
	}()

	buf := make([]byte, 65535)
	for {
		n, client, err := conn.ReadFromUDP(buf)
		if err != nil {
			return
		}
		if n == 0 {
			continue
		}
		target := gameAddr
		if classifyUDP(buf[0]) {
			target = quicAddr
		}
		key := client.String() + ">" + target.String()
		mu.Lock()
		s := sessions[key]
		if s == nil {
			up, err := net.DialUDP("udp", nil, target)
			if err != nil {
				mu.Unlock()
				continue
			}
			s = &udpSession{up: up}
			sessions[key] = s
			go func(up *net.UDPConn, client *net.UDPAddr) { // backend -e9 cliente
				b := make([]byte, 65535)
				for {
					m, err := up.Read(b)
					if err != nil {
						return
					}
					conn.WriteToUDP(b[:m], client)
				}
			}(up, client)
		}
		s.seen = time.Now()
		mu.Unlock()
		s.up.Write(buf[:n])
	}
}
Lo que este gateway no hace deliberadamente
Es una base, no un producto terminado. Antes de exponerlo a internet, planifica lo siguiente:
- Preservación de la IP del cliente. Los backends ven la IP del gateway. Usa el protocolo PROXY para TCP, o lleva la IP del cliente en el encuadre del túnel.
- Conciencia de ID de conexión QUIC. Las sesiones se identifican por IP del cliente, así que si un cliente migra de red, obtiene un socket upstream nuevo. Combínalo con IDs enrutables emitidos por el servidor (sección 5) si necesitas que la migración sobreviva.
- Un socket upstream por cliente UDP. Es simple y correcto, pero cada socket usa un puerto efímero, heredando los límites de la sección 7. Limita los conteos de sesiones y considera los diseños multiplexados.
- Controles de abuso. No hay límites de tasa, límites de conexión, ni protección contra amplificación. Los servidores QUIC deben limitar lo que envían a una IP no validada a tres veces lo que recibieron (RFC 9000, sección 8), y un gateway que reenvía respuestas a fuentes falsificadas puede ser abusado igual.
- Inspección Slowloris. El límite de 5 segundos en la inspección limita conexiones inactivas, pero también debes limitar las conexiones no clasificadas simultáneas.
- Comportamiento de cierre en fallo. Los bytes iniciales desconocidos o malformados actualmente caen en el backend de respaldo. Decide si tu despliegue debe descartarlos en su lugar.
9. Medir el beneficio en lugar de suponerlo
Consolidar puertos es principalmente una victoria operativa: menos reglas de firewall, menos listeners, un solo lugar para aplicar políticas. Las mejoras de rendimiento dependen de la carga, así que mide antes de afirmar. Los números de antes y después publicados o inventados para “puerto único vs múltiple” no se transfieren entre entornos, y los mecanismos principales que citan requieren cuidado:
- Latencia de handshake. Un puerto único no acorta el handshake TLS o QUIC, y ALPN viaja dentro del ClientHello, así que no añade ida y vuelta adicional. QUIC 0-RTT solo aplica a conexiones reanudadas, y RFC 9000 advierte que no protege contra ataques de repetición, por lo que no es una ganancia de latencia general ni seguro para solicitudes no idempotentes.
- Costo por paquete. La clasificación en espacio de usuario cuesta una llamada al sistema por datagrama. La clasificación en kernel (
SK_REUSEPORTo XDP) elimina ese costo para el tráfico que maneja. Lecturas en lote (recvmmsg, UDP GRO y GSO en kernels compatibles) lo reducen aún más sin eBPF. XDP con AF_XDP intercambia características de la pila del kernel por velocidad, y resulta rentable en altas tasas de paquetes, no en cargas típicas de servidores de juegos. - Qué medir. Tiempo de establecimiento de conexión en p50/p99, paquetes por segundo por núcleo en un objetivo de pérdida fija, CPU por Gbit/s, sockets y puertos efímeros en uso (
ss -s), y caídas en cada etapa (NIC, buffers de socket, tabla de sesiones). Prueba con tu mezcla real de clientes, incluyendo clientes QUIC que migran y detrás de NAT de operador.
10. Lista de verificación de implementación
- Sockets. Enlaza TCP y UDP en el mismo puerto con listeners normales; añade
SO_REUSEPORTsolo para escalado por núcleo. - Clasificación UDP. Usa los rangos RFC 9443, nunca “encabezado largo o bit fijo puesto”. Mantén tu propio primer byte fuera de los rangos QUIC, y no habilites
grease_quic_biten endpoints detrás de un multiplexor de primer byte. - Enrutamiento QUIC. Decide de antemano cómo los paquetes de encabezado corto encuentran su backend: IDs enrutables emitidos por el servidor (server-ID routing, QUIC-LB), una tabla de conexiones, o terminando QUIC en el gateway. Sin uno de estos, la migración se rompe.
- Clasificación TCP. Inspecciona sin consumir; analiza ALPN en el ClientHello; maneja el prefacio
PRIy métodos HTTP; ten un plan para ECH. - Aceleración en kernel. Usa primero
SK_REUSEPORTcon eBPF (mantiene la pila normal); usa XDP y AF_XDP solo cuando necesites velocidad en driver y puedas gestionar la pila en espacio de usuario. - Túneles. Lleva flujos como flujos y datagramas como datagramas (RFC 9221, RFC 9297, RFC 9298), y autentica correctamente a los clientes del túnel.
- Presupuestos de puertos. Cuenta puertos efímeros por 4-tupla backend, no por host, y multiplexa antes de ampliar rangos.
- Refuerzo. Limita cada tabla, expira sesiones, limita tasa en UDP no validado, y decide qué hacer con tráfico no clasificable.
Referencias
- RFC 8999: Propiedades independientes de versión de QUIC
- RFC 9000: QUIC: Transporte multiplexado y seguro basado en UDP
- RFC 9443: Actualizaciones del esquema de multiplexación para QUIC
- RFC 9849: TLS Encrypted Client Hello
- RFC 9298: Proxy UDP en HTTP
- AF_XDP, documentación del kernel Linux
- BPF_PROG_TYPE_SK_REUSEPORT, documentación de eBPF
- QUIC-LB: Generación de IDs de conexión enrutables (Borrador)
- Katran, balanceador de carga de capa 4 basado en XDP de Meta
- De XDP a Socket, Linux Plumbers Conference 2021
- Cloudflare: Cómo dejar de agotar puertos efímeros
- Peakhour: Cómo los navegadores deciden usar HTTP/3
Related InstaTunnel pages
Continue from this article into the most relevant product guides and workflows.
Related Topics
Keep building with InstaTunnel
Read the docs for implementation details or compare plans before you ship.