Construire le Pont : Proxys inverses pour le développement IA Cloud-vers-Local
Quick answer
Copilot API Bridge : Proxys inverses sécurisés pour le développement IA local: webhook testing answer
For local webhook testing, run your app locally, expose it with a public HTTPS tunnel, and paste the stable callback URL into the provider dashboard.
How do I test webhooks on localhost?
Start your local server, open a public HTTPS tunnel to that port, configure the provider webhook URL, and inspect events in your local logs.
Why does a stable webhook URL matter?
Stable URLs prevent provider dashboards from needing manual callback updates every time you restart a tunnel.
Le workspace moderne du développeur se trouve dans un état de tension architecturale. D’un côté, le cloud : clusters massifs LLM, assistants de codage hébergés dans le cloud comme GitHub Copilot, et plateformes d’agents gérés opérant dans des datacenters distants. De l’autre, l’environnement local : bases de code propriétaires, bases de données de test éphémères sur localhost, microservices internes, et outils spécialisés pour développeurs.
Pour que les systèmes IA basés sur le cloud offrent une automatisation véritablement contextuelle — déboguer une erreur de requête PostgreSQL locale, inspecter un diff git non validé, exécuter un script de projet spécialisé — ils doivent accéder en toute sécurité à la machine locale du développeur. Inversement, les développeurs ont souvent besoin de router des abonnements IA cloud vers des interfaces en ligne de commande (CLI) locales et des agents de développement personnalisés sans exposer de secrets d’entreprise ni dépasser les limites de taux API.
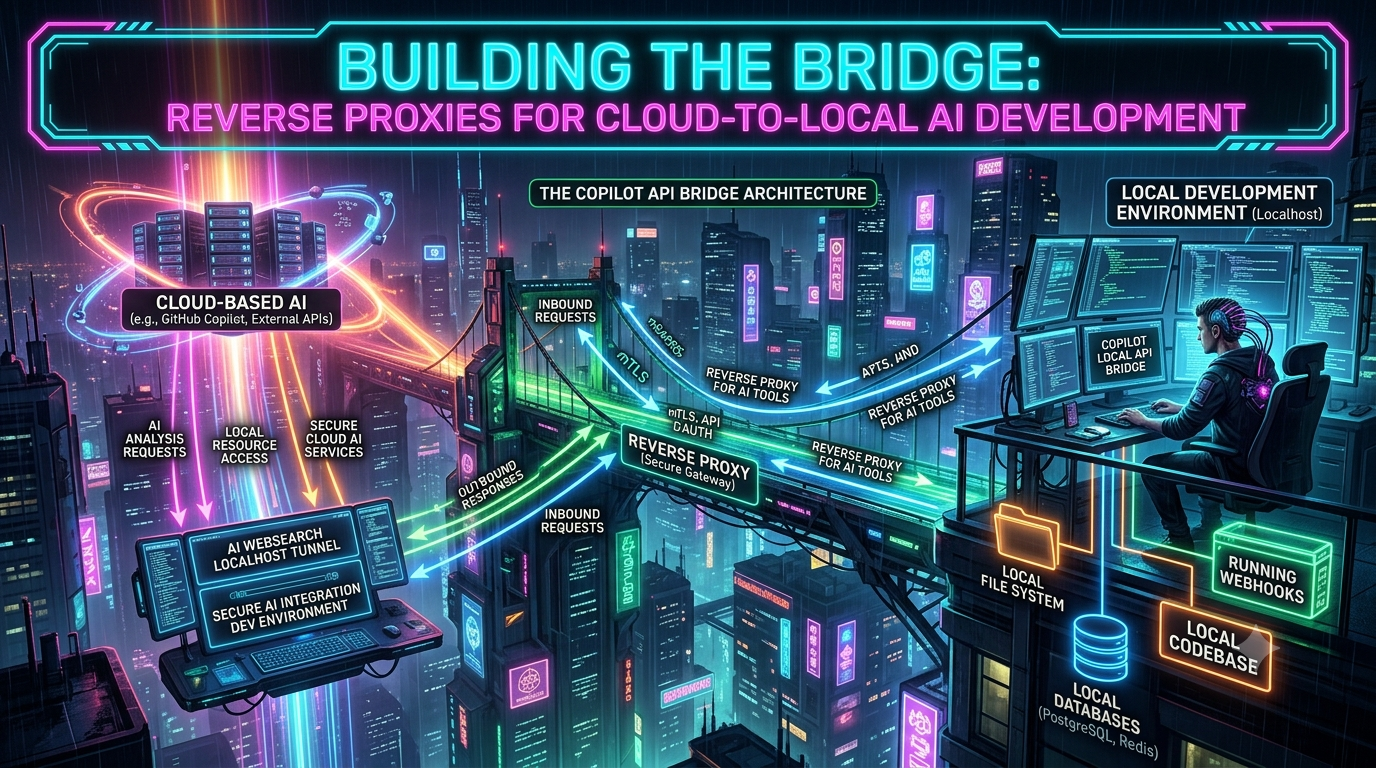
Ce besoin architectural a conduit à la création du pont API local Copilot et de proxys inverses dédiés pour les outils IA. Placés entre les moteurs IA cloud et les environnements locaux, ces proxys agissent comme des plans de contrôle de trafic intelligents, gérant la traduction de protocoles, l’autorisation par token, la sanitisation des en-têtes, et le tunneling sécurisé via des connexions sortantes uniquement.
Ce guide explique l’architecture des ponts IA cloud-vers-local, les patterns d’implémentation concrets, et la construction étape par étape d’un environnement de développement sécurisé pour l’intégration IA.
1. Vue d’ensemble architecturale : Le pont IA cloud-vers-local
Au cœur, une architecture de pont IA résout un problème fondamental de réseau : établir une communication bidirectionnelle, riche en contexte, entre les services IA cloud et les environnements locaux privés sans ouvrir de ports entrants sur un pare-feu d’entreprise.
+-----------------------------------------------------------------------------------+
|                                  LIMITE CLOUD                                   |
|                                                                                     |
|   +-----------------------+                    +------------------------------+    |
|   | Agent IA Cloud / SaaS |                    | API Platform GitHub Copilot   |   |
|   | (Claude, Copilot UI)  |                    | (backend propriétaire GitHub) |   |
|   +-----------+-----------+                    +--------------+--------------+    |
+---------------+----------------------------------------------+-------------------+
                | (Trafic MCP entrant via Tunnel)             | (Appels d'inférence en amont)
                v                                                 v
+---------------+----------------------------------------------+-------------------+
|               |              MACHINE LOCALE DE DEV             |                   |
|               |                                              |                   |
|   +-----------v-----------+                     +--------------v--------------+   |
|   | Tunnel Outbound Sécurisé|                 | Pont API Copilot local      |   |
|   | (Cloudflare/Pinggy)     |                 | (Reverse Proxy sur 127.0.0.1)|   |
|   +-----------+-----------+                     +--------------+--------------+   |
|               |                                              |                   |
|               v                                              v                   |
|   +-----------+-----------+                     +--------------+--------------+   |
|   | Serveur MCP local     |                     | CLI / Agent développeur local |   |
|   | (BD, Index de fichiers, RAG) |             | (Claude Code, agents custom) |   |
|   +------------------------+                    +------------------------------+   |
|                                                                                     |
+-----------------------------------------------------------------------------------+
Le pont fonctionne selon deux directions distinctes :
- Exécution de contexte distant cloud vers local. Un modèle IA hébergé dans le cloud doit déclencher un outil local ou inspecter une base de données locale. La requête voyage via un tunnel sortant crypté vers un serveur MCP (Model Context Protocol) écoutant sur l’interface de boucle (
127.0.0.1). - Emulation de fournisseur cloud vers local. Un outil ou agent CLI local doit communiquer avec un fournisseur LLM. Le proxy local écoute sur un port de boucle, intercepte les appels API format OpenAI ou Anthropic, les traduit en requêtes compatibles en amont, et gère l’authentification de manière transparente.
Dans les deux patterns, le proxy inversé sert de périmètre de sécurité. Il garantit que les systèmes de fichiers locaux bruts ne sont jamais exposés directement à Internet, tout en supprimant les en-têtes clients incompatibles, en normalisant les événements de streaming, et en appliquant une autorisation stricte par token bearer.
2. Patterns clés du pont et traduction de la forme du fil
Lors de l’intégration d’outils IA disparates, les incompatibilités de forme du fil sont courantes. Différents clients utilisent différents protocoles, attendent des schémas JSON variés, et passent des en-têtes personnalisés. Le proxy inverse comble ces écarts de protocole.
Pattern du pont API Copilot
Un petit écosystème actif de proxys inverses — messense/copilot-api-proxy, ericc-ch/copilot-api et ses nombreux forks (betaHi/copilot-api, craz-yq/copilot-api, etc.) — agit comme middleware local entre agents CLI (Claude Code, Codex CLI, scripts d’orchestration personnalisés) et un abonnement GitHub Copilot. Aucun de ces projets n’est supporté par GitHub ; ils sont des reverse-engineerings, explicitement susceptibles de casser, et les termes de GitHub pour Copilot avertissent qu’une utilisation automatisée ou scriptée excessive peut déclencher la détection d’abus et une suspension temporaire. Ce rappel est important avant de les intégrer dans une pipeline CI.
Au lieu de payer séparément pour des clés API dupliquées auprès de plusieurs vendeurs LLM, un développeur exécute un pont local — messense/copilot-api-proxy par défaut sur le port 9876. Le pont propose des endpoints neutres pour les vendeurs :
| Route | Comportement |
|---|---|
POST /v1/chat/completions |
Format OpenAI Chat Completions |
POST /v1/responses |
API Responses d’OpenAI (nécessaire pour la famille gpt-5 et modèles style Codex, qui rejettent /chat/completions) |
POST /v1/messages |
Format Messages Anthropic ; modèles Claude natifs sont directement transférés à /v1/messages de Copilot, conservant le flux tool_use/tool_result Anthropic plutôt que de faire une traduction OpenAI |
POST /v1/messages/count_tokens |
Comptage de tokens compatible Anthropic |
GET /v1/models |
Liste des modèles disponibles selon le plan Copilot |
Lorsqu’une requête atteint le pont, le proxy :
- Valide et rafraîchit le token OAuth de GitHub Copilot en arrière-plan, le stockant à
~/.local/share/copilot-api-proxy/github_tokenavec des permissions0600pour le fichier /0700pour le répertoire. - Injecte les en-têtes requis par le backend GitHub :
Copilot-Integration-Id,X-Initiator(défini àuserouagentselon si la conversation contient déjà des tours d’assistant/outils),Openai-Intent, et un drapeauCopilot-Vision-Requestpour les entrées d’image. Ces en-têtes ont été déterminés après reverse-engineering du trafic officiel du client Copilot Chat dans VS Code ; une requête sansCopilot-Integration-Idest rejetée immédiatement avec une erreur Bad Request. - Gère l’aliasing des noms de modèles pour les requêtes de type Anthropic —
messense/copilot-api-proxymappe les tiers génériquesopus/sonnet/haikuattendus par Claude Code vers des IDs concrets via les variables d’environnementBIG_MODEL/MIDDLE_MODEL/SMALL_MODEL, et limitemax_tokensentreMIN_TOKENS_LIMITetMAX_TOKENS_LIMIT(4096 par défaut) avant de transmettre en amont.
Une correction importante : la gestion de l’effort de raisonnement sur ces ponts n’est pas une simple « clamp tout ce qui n’est pas supporté vers high ». Les modèles de raisonnement de la famille GPT-5 acceptent désormais souvent un niveau xhigh comme valeur de premier ordre (plusieurs forks du proxy le transmettent directement via la variable d’environnement COPILOT_REASONING_EFFORT, et la documentation de Microsoft liste xhigh comme supporté sur les modèles gpt-5.1/gpt-5.2), donc un pont qui réduit silencieusement xhigh à high sur un modèle qui l’accepte serait en train de rejeter une configuration légitime, plutôt que de protéger contre un rejet API. Concevez cet adaptateur de façon défensive — faites passer les niveaux de raisonnement quand le modèle en amont les supporte, et ne les clamp que si rejet confirmé.
Pattern du tunnel MCP
Le protocole Model Context Protocol (MCP) d’Anthropic utilise un schéma JSON-RPC 2.0 standardisé pour exposer outils, ressources, et prompts aux agents IA. Les serveurs MCP locaux communiquent traditionnellement via stdio ; les agents IA hébergés dans le cloud ont besoin d’un transport accessible en réseau.
Il est important d’être précis sur ce transport, car le protocole a changé en 2025. L’ancien transport distant, “HTTP+SSE”, utilisait deux endpoints séparés — un pour les messages POST, un pour un flux SSE longue durée — remplacé à partir de la révision MCP du 26-03-2025 par Streamable HTTP : un seul endpoint (conventionnellement /mcp) acceptant POST pour chaque message JSON-RPC, avec le serveur pouvant répondre par JSON simple ou flux SSE pour cette requête. Le transport HTTP+SSE est maintenant officiellement déprécié selon la politique de cycle de vie des fonctionnalités MCP — les nouveaux serveurs ne doivent pas l’implémenter, mais les clients doivent pouvoir y revenir pour les anciens serveurs. FastMCP reflète cette migration : mcp.run(transport="http", ...) et mcp.run(transport="streamable-http", ...) sont tous deux valides et équivalents, tandis que transport="sse" est explicitement documenté comme “legacy — utiliser HTTP pour les nouveaux projets”. Une révision de brouillon datée du 28-07-2026 va encore plus loin, supprimant le flux SSE en GET et les IDs de session au niveau protocole, en faveur d’une requête JSON-RPC par POST — à surveiller si vous construisez un serveur destiné à rester conforme longtemps, même si ce brouillon n’a pas encore remplacé la version MCP de 2025-11-25.
Pour connecter des modèles cloud à des outils locaux, un tunnel sortant mappe un endpoint HTTPS public vers ce serveur MCP Streamable HTTP local. Le proxy inverse termine TLS à la périphérie, vérifie les signatures HMAC ou tokens bearer entrants, et route les requêtes JSON-RPC valides vers des outils locaux comme vérificateurs de syntaxe, moteurs de requêtes de bases de données, ou pipelines RAG personnalisés.
3. Cas d’usage principaux des ponts IA cloud-vers-local
Cas d’usage 1 : Exposer les bases de données locales & la recherche de code aux agents cloud
Supposons qu’un ingénieur utilise un espace de travail IA cloud pour déboguer une requête SQL complexe. La base de données n’est pas hébergée dans le cloud ; elle tourne dans un conteneur Docker sur la station de travail.
En lançant un serveur MCP local qui interfère avec pg-promise ou SQLAlchemy et en le faisant passer par un tunnel sortant, l’agent cloud peut invoquer directement des outils comme list_tables, describe_schema, ou explain_query contre localhost:5432. Le code et les données restent sur la machine du développeur ; seuls les résultats d’exécution d’outils explicites quittent l’environnement local.
Cas d’usage 2 : Routage unifié de modèles via un abonnement Copilot
Les développeurs préfèrent souvent des workflows spécialisés en ligne de commande — Claude Code, Codex CLI, OpenCode — tout en ayant un abonnement actif à GitHub Copilot.
En utilisant un pont API Copilot local, le développeur configure ses outils CLI pour pointer vers http://localhost:9876. Le pont fait un passthrough natif pour les modèles Claude sur l’endpoint /v1/messages de Copilot, traduit les requêtes pour les modèles GPT/Codex en format Responses d’OpenAI, et applique les plafonds de tokens décrits ci-dessus avant de transmettre. (Une mise en garde : certains README de proxy mentionnent explicitement que faire passer une fenêtre de contexte exceptionnellement grande — par exemple un niveau étendu [1m] pour Claude — risque de déclencher la détection d’abus de GitHub, il est donc recommandé de respecter la taille standard de contexte même pour des modèles supportant plus.)
Cas d’usage 3 : Tunnel de recherche web locale & RAG d’entreprise
Les plateformes LLM cloud restreignent ou facturent lourdement les outils de recherche web intégrés, et la recherche cloud ne peut pas explorer wikis internes, documentation locale, ou serveurs de staging privés.
Un tunnel de recherche web localhost résout cela en exposant un indexeur local ou un navigateur headless à l’IA cloud. Lorsqu’un modèle cloud nécessite un contexte externe, il appelle un outil via le tunnel vers un moteur de recherche local (conteneur SearXNG local, base vectorielle locale), la recherche s’exécute en interne, et le contexte markdown propre est renvoyé au modèle cloud.
4. Implémentation étape par étape : Construire un pont sécurisé
Ce build comporte trois parties : un serveur FastMCP en Python exposant la recherche de fichiers et outils de bases de données, un proxy API local appliquant l’authentification par token bearer et isolant en boucle locale, et un tunnel sécurisé sortant permettant aux modèles IA cloud d’accéder sans ouvrir de ports entrants.
Étape 1 : Créer le serveur d’outils local (FastMCP)
Installer FastMCP :
pip install fastmcp
Créer local_bridge_server.py :
import os
import glob
from fastmcp import FastMCP

# Initialiser le serveur MCP
mcp = FastMCP("LocalDevBridge")

@mcp.tool()
def search_local_files(directory: str, extension: str) -> list[str]:
    """Chercher des fichiers correspondant à une extension spécifique dans un répertoire local."""
    # Protection basique contre la traversée de répertoires
    abs_base = os.path.abspath(directory)
    if not os.path.exists(abs_base):
        return [f"Erreur : le répertoire {directory} n'existe pas."]

    pattern = os.path.join(abs_base, f"**/*.{extension.lstrip('.')}")
    matches = glob.glob(pattern, recursive=True)
    # Retourner les chemins relatifs pour éviter d'exposer inutilement la structure système absolue
    return [os.path.relpath(m, start=abs_base) for m in matches[:50]]

@mcp.tool()
def read_local_file_head(filepath: str, max_lines: int = 100) -> str:
    """Lire les premières N lignes d'un fichier local."""
    if not os.path.exists(filepath):
        return f"Erreur : fichier {filepath} non trouvé."

    try:
        lines = []
        with open(filepath, 'r', encoding='utf-8') as f:
            for _ in range(max_lines):
                line = f.readline()
                if not line:
                    break
                lines.append(line)
        return "".join(lines)
    except Exception as e:
        return f"Erreur lors de la lecture du fichier : {str(e)}"

if __name__ == "__main__":
    # Écouter sur 127.0.0.1 pour une isolation stricte en boucle locale.
    # transport="http" sert au transport Streamable HTTP moderne
    # (FastMCP considère "http" et "streamable-http" comme équivalents).
    print("Démarrage du serveur MCP local sur http://127.0.0.1:8000/mcp")
    mcp.run(transport="http", host="127.0.0.1", port=8000)
Lancer le serveur :
python local_bridge_server.py
Étape 2 : Construire le reverse proxy et la vérification par token
Pour que seuls les outils cloud autorisés puissent atteindre notre serveur MCP local, enveloppez-le dans un proxy inversé léger avec Node.js et http-proxy. Cette couche vérifie strictement le token bearer et filtre les en-têtes suspects.
mkdir ai-bridge-proxy && cd ai-bridge-proxy
npm init -y
npm install http-proxy dotenv
Créer .env :
BRIDGE_TOKEN=super-secret-local-dev-key-2026
Créer proxy.js :
require('dotenv').config();
const http = require('http');
const httpProxy = require('http-proxy');

// Token secret requis pour toutes les requêtes entrantes
const BRIDGE_BEARER_TOKEN = process.env.BRIDGE_TOKEN || "super-secret-local-dev-key-2026";
const TARGET_MCP_SERVER = "http://127.0.0.1:8000";
const PROXY_PORT = 9000;

const proxy = httpProxy.createProxyServer({});

// Gérer les erreurs de proxy gracieusement
proxy.on('error', (err, req, res) => {
    console.error('[Erreur proxy]:', err.message);
    if (!res.headersSent) {
        res.writeHead(502, { 'Content-Type': 'application/json' });
        res.end(JSON.stringify({ error: 'Mauvaise passerelle : serveur d’outils local inaccessible.' }));
    }
});

const server = http.createServer((req, res) => {
    console.log(`[${new Date().toISOString()}] ${req.method} ${req.url}`);

    // Vérification de l'authentification par token Bearer
    const authHeader = req.headers['authorization'];
    if (!authHeader || authHeader !== `Bearer ${BRIDGE_BEARER_TOKEN}`) {
        console.warn('[Tentative d’accès non autorisé] : token Bearer invalide ou manquant');
        res.writeHead(401, { 'Content-Type': 'application/json' });
        return res.end(JSON.stringify({ error: '401 Non autorisé : token de pont invalide' }));
    }

    // Nettoyage des en-têtes avant transfert
    delete req.headers['x-forwarded-host'];
    req.headers['x-ai-bridge-version'] = '1.0.0';

    // Routage vers le serveur MCP interne
    proxy.web(req, res, { target: TARGET_MCP_SERVER });
});

server.listen(PROXY_PORT, '127.0.0.1', () => {
    console.log(`[Proxy de pont] en cours sur http://127.0.0.1:${PROXY_PORT}`);
    console.log(`[Sécurité] Authentification par token Bearer active.`);
});
Démarrer le proxy :
node proxy.js
http-proxy (node-http-proxy) est une bibliothèque mature et largement utilisée pour ce type de passerelle ; si vous souhaitez éviter une dépendance supplémentaire, les modules fetch/http de Node ou undici avec ProxyAgent peuvent faire le même travail pour une cible unique.
Étape 3 : Établir un tunnel sortant sécurisé Zero-Trust
Maintenant que le proxy local gère la validation du token sur le port 9000, exposez ce port de manière sécurisée aux plateformes IA cloud.
Ouvrir des ports sur le routeur (port forwarding) est risqué car cela expose des IPs brutes à des scans publics. Utilisez plutôt un tunnel sortant crypté initié depuis votre réseau privé vers un fournisseur d’edge.
Option A : Tunnel Cloudflare (cloudflared)
Le tableau de bord Cloudflare configure désormais par défaut de nouveaux tunnels en mode token-based, gestion via tableau de bord (dans Networking → Tunnels dans la mise à jour de navigation de mars 2026 — cette section a été déplacée depuis Access → Tunnels). Pour une infrastructure scriptée ou en version contrôlée, la méthode CLI avec certificat reste supportée comme alternative “gérée localement” :
brew install cloudflared
cloudflared tunnel login
cloudflared tunnel create local-ai-bridge
Configurer le routage dans ~/.cloudflared/config.yml :
tunnel: <UUID_TUNNEL>
credentials-file: /Users/dev/.cloudflared/<UUID_TUNNEL>.json

ingress:
  - hostname: ai-bridge.yourdomain.dev
    service: http://127.0.0.1:9000
  - service: http_status:404
Routage DNS et lancement du tunnel :
cloudflared tunnel route dns local-ai-bridge ai-bridge.yourdomain.dev
cloudflared tunnel run local-ai-bridge
Un point à noter : les quick tunnels de Cloudflare (commande cloudflared tunnel --url http://localhost:9000, sans login) limitent à 200 requêtes simultanées et ne supportent pas SSE — ce qui casserait silencieusement la reprise SSE d’un serveur MCP qui doit encore parler à d’anciens clients. Utilisez un tunnel nommé et connecté pour tout usage au-delà d’une démo courte.
Option B : Tunneling SSH (Pinggy / Zrok)
Pour prototypage rapide ou sessions éphémères, les tunnels SSH comme Pinggy offrent des endpoints HTTPS instantanés sans daemons :
ssh -p 443 -R0:localhost:9000 free.pinggy.io
Le terminal affiche une URL HTTPS publique du type https://rnskg-21-24-129-38.run.pinggy-free.link (gratuit ; les comptes Pro peuvent lier un domaine persistant à leur token). Les tunnels Pinggy gratuits sont limités à 60 minutes par session et affichent une page de vérification unique lors du premier chargement — à connaître si c’est intégré dans une pipeline automatisée plutôt qu’un clic humain.
Étape 4 : Connecter la plateforme IA cloud à votre pont local
Avec le tunnel actif, enregistrez l’endpoint de l’outil local dans votre plateforme IA cloud. Pour attacher les outils du pont à une session Claude Code :
claude mcp add --transport http local_dev_bridge https://ai-bridge.yourdomain.dev/mcp \
  --header "Authorization: Bearer super-secret-local-dev-key-2026"
Vérifier la reconnaissance des outils :
claude mcp list
Maintenant, demander à Claude Code : “recherche dans mon dépôt local tous les fichiers de configuration et résume les paramètres de la base” envoie un appel d’outil qui transite via le tunnel Cloudflare, passe la vérification du token du proxy Node.js, s’exécute localement dans FastMCP, et renvoie le contexte fichier en toute sécurité à l’agent.
5. Architecture de sécurité pour les intégrations IA
Exposer les capacités du système local à des boucles d’exécution LLM externes introduit de nouveaux vecteurs d’attaque. Les ingénieurs construisant un environnement sécurisé pour l’intégration IA doivent appliquer une défense en profondeur sur trois couches :
+-----------------------------------------------------------------------------------+
|                        MATRICE DE DÉFENSE À TROIS NIVEAUX                          |
+-----------------------------------------------------------------------------------+
|  1. COUCHE RÉSEAU        | Liaison en boucle locale (127.0.0.1), Tunnels sortants, |
|                         | Liste blanche IP stricte, Pas de ports entrants ouverts |
+-------------------------+---------------------------------------------------------+
|  2. COUCHE APPLICATION   | Authentification par token Bearer obligatoire, Validation |
|                         | de l’en-tête Origin, Sanitation du schéma, Nettoyage des en-têtes, Limitation du débit |
+-------------------------+---------------------------------------------------------+
|  3. COUCHE D’EXÉCUTION   | Scope en lecture seule du système de fichiers, Validation stricte des chemins, |
|                         | Sandbox d’exécution des commandes, Journalisation d’audit |
+-----------------------------------------------------------------------------------+
1. Atténuation des menaces : Injection indirecte de prompt. Si un agent IA recherche dans des fichiers locaux ou pages web internes, un attaquant pourrait insérer des instructions malveillantes dans un commentaire ou un fichier journal local. Mitigation : ne pas donner aux outils de pont local des droits arbitraires d’exécution shell ; utiliser une validation stricte des schémas d’entrée (Pydantic ou Zod) ; limiter les outils de fichiers à des sous-arbres de répertoires explicites ; ne jamais exposer un eval() brut ou un outil bash non restreint via un endpoint public.
2. Rebinding DNS. La spécification du transport HTTP+SSE de MCP exige explicitement que les serveurs valident l’en-tête Origin sur chaque connexion entrante et rejettent celles invalides avec 403 Forbidden, et recommande de lier les serveurs locaux à 127.0.0.1 plutôt qu’à 0.0.0.0 — pour empêcher un site malveillant ouvert dans un onglet de navigateur de communiquer silencieusement avec un serveur MCP local. C’est une exigence protocolaire, pas juste une bonne pratique, et il faut vérifier que votre framework MCP l’implémente (FastMCP le fait).
3. Fuite de tokens & isolation de session. Les proxies inverses locaux qui interfacent avec GitHub Copilot stockent les identifiants localement — ~/.local/share/copilot-api-proxy/github_token dans le cas de messense/copilot-api-proxy. Mitigation : verrouiller les permissions du fichier token à 0600 (lecture/écriture propriétaire uniquement) et celles du répertoire à 0700 ; ne jamais écrire de tokens OAuth Copilot bruts dans des fichiers de configuration CLI accessibles au client ; forcer les applications clientes à s’authentifier contre le proxy avec un token de pont éphémère séparé.
4. Safeguards contre boucle infinie. Les boucles agentiques peuvent rester bloquées dans des cycles de requêtes répétitives, générant des milliers de requêtes en secondes — risquant d’épuiser les quotas API ou de déclencher la détection d’abus de GitHub Copilot, qui mentionne explicitement « requêtes rapides ou en masse, comme via des outils automatisés » comme motif d’avertissement ou suspension temporaire. Mitigation : limiter la concurrence côté client et proxy, et traiter tout pont Copilot comme une opération à taux humain, pas à débit batch CI.
Voici une comparaison actualisée des outils de proxy inverses couramment utilisés en développement IA local :
| Outil / Pattern | Cas d’usage optimal | Capacité d’authentification | Support protocole | Complexité de déploiement |
|---|---|---|---|---|
| Tailscale / WireGuard | Réseau privé entre appareils développeurs | OAuth / SAML SSO | Tout trafic TCP/UDP | Faible (installer client) |
Cloudflare Tunnel (cloudflared) |
Endpoints HTTPS publics pour agents IA cloud | Cloudflare Access + token tunnel | HTTP / SSE / WebSockets | Moyen (DNS requis pour tunnels nommés ; quick tunnels non) |
copilot-api-proxy et forks |
Conversion d’un abonnement Copilot en API compatible OpenAI/Anthropic | OAuth GitHub + token local optionnel | REST / SSE en streaming | Faible (un seul binaire/CLI) |
| FastMCP + Proxy personnalisé | Exposer bases de données, recherche ou scripts locaux spécialisés | Token personnalisé / HMAC | JSON-RPC via Streamable HTTP | Moyen (script de configuration) |
6. Configuration avancée : RAG local avec tunnel web de recherche IA
Pour démontrer la puissance d’un setup hybride cloud-vers-local, considérez un pont de recherche web et de récupération de documents local. Cela permet aux modèles cloud de rechercher dans la documentation interne sans la télécharger.
Un worker local indexe les fichiers .md, .pdf, et pages wiki internes dans une base vectorielle légère (LanceDB ou ChromaDB) sur localhost, et un serveur FastMCP expose un outil query_internal_docs accessible via un endpoint tunnelé :
# extrait du endpoint de recherche locale
from fastmcp import FastMCP
import lancedb

mcp = FastMCP("LocalSearchBridge")
db = lancedb.connect("~/.local_doc_index")
table = db.open_table("dev_docs")

@mcp.tool()
def query_internal_docs(query: str, limit: int = 3) -> list[dict]:
    """Rechercher dans la documentation interne et les ADR."""
    # Exécution de la recherche sémantique locale
    results = table.search(query).limit(limit).to_list()

    formatted_results = []
    for r in results:
        formatted_results.append({
            "title": r["title"],
            "category": r["category"],
            "content": r["text"][:500]  # tronquer la longueur du snippet
        })
    return formatted_results

if __name__ == "__main__":
    mcp.run(transport="http", host="127.0.0.1", port=8001)
En séparant l’index de recherche du modèle LLM, le modèle cloud agit strictement comme moteur de raisonnement : il demande le contexte dynamiquement via le tunnel, reçoit des résultats structurés JSON, et renvoie la réponse à l’utilisateur, tout en conservant les spécifications internes sensibles en local.
7. Une seconde signification : “Tunnels MCP” d’Anthropic
Tout ce qui s’appelle “ tunnel MCP ” en 2026 peut désigner deux choses très différentes, et il est important d’être explicite :
Tout ce qui précède est le pattern communautaire : un tiers (Cloudflare, Pinggy, proxy personnalisé) transporte le trafic dans la machine du développeur pour qu’un agent cloud atteigne un serveur MCP local. Anthropic a aussi lancé une fonctionnalité homonyme, de première partie, qui fonctionne dans la direction opposée. Les tunnels MCP sur la plateforme Claude — en préversion de recherche et disponibles sur demande pour les organisations avec le plan Claude Enterprise — permettent à un agent géré Claude ou à l’API Messages d’atteindre un serveur MCP dans le réseau privé d’une organisation, sans ouvrir de port entrant ni exposer le serveur à Internet. La mécanique est similaire : un petit cloudflared sort de l’intérieur du réseau privé vers l’edge de Cloudflare, et un composant proxy (mcp-proxy, publié par Anthropic) termine une couche TLS avec un certificat détenu par le client, de sorte que Cloudflare ne voit jamais les payloads non chiffrés. Il s’accompagne d’une sandbox auto-hébergée (bêta publique), permettant aux agents gérés d’exécuter des appels d’outils sur l’infrastructure du client — auto-hébergée ou via des fournisseurs gérés comme Cloudflare, Daytona, Modal, Vercel.
La différence pratique : les ponts décrits plus tôt permettent à votre machine locale d’offrir des outils à un agent cloud avec lequel vous interagissez en direct. Les tunnels MCP d’Anthropic permettent à des serveurs MCP en réseau privé d’être accessibles aux agents gérés et à l’API Messages au niveau du compte, selon les termes de fiabilité et support d’Anthropic (aucun en particulier, car en préversion, dépendant de la disponibilité de Cloudflare comme fournisseur de transport tiers). Si votre organisation veut donner un accès durable à des systèmes internes à des agents, cette fonctionnalité propriétaire — accessible via demande de préversion — mérite d’être évaluée avant de construire un pont personnalisé.
8. Liste de vérification opérationnelle pour le déploiement du pont
Avant de déployer un pont IA cloud-vers-local dans une équipe de développement, passez cette checklist :
- [ ] Vérification de la liaison en boucle locale — confirmer que chaque serveur MCP et service proxy est explicitement lié à
127.0.0.1plutôt qu’à0.0.0.0, pour éviter toute exposition non autorisée sur le Wi-Fi local. - [ ] Validation de l’en-tête Origin — confirmer que le serveur MCP rejette les requêtes avec un en-tête
Originmanquant ou invalide (403 Forbidden), conformément à la spécification du transport Streamable HTTP, pour prévenir le rebinding DNS. - [ ] Application du token Bearer — s’assurer que chaque requête entrante via le proxy est protégée par un token secret à haute entropie, stocké séparément du token OAuth en amont.
- [ ] Renforcement du tunnel sortant — faire tourner le daemon du tunnel sous un utilisateur non privilégié, et préférer un tunnel nommé/authentifié plutôt qu’un quick tunnel sans configuration pour tout usage au-delà d’une démo courte.
- [ ] Limites de débit — limiter le nombre de requêtes simultanées et par minute au niveau du proxy, notamment pour les ponts Copilot, pour éviter la détection d’abus de GitHub.
- [ ] Télémétrie & audit — logger toutes les invocations d’outils, timestamps, et origines IP dans un fichier local pour audit.
Perspectives pour les architectures IA cloud-vers-local
La frontière entre intelligence hébergée dans le cloud et environnement de développement local s’estompe. Plutôt que de choisir entre exécution locale pure ou dépendance totale au cloud, l’architecture hybride de pont offre le meilleur des deux mondes.
En déployant un proxy inverse intelligent pour les outils IA, les développeurs peuvent exploiter la puissance de raisonnement du cloud tout en conservant la propriété des fichiers locaux, bases de données privées, et abonnements. Que ce soit pour un pont API Copilot local pour workflows CLI ou un tunnel de recherche web IA local pour récupération sécurisée de documents, un pont bien sécurisé, authentifié par token, maintient l’environnement de développement rapide, riche en contexte, et sécurisé — et il est utile de savoir si le “tunnel MCP” qu’un outil annonce correspond au pattern communautaire de ce guide ou à la fonctionnalité d’entreprise d’Anthropic portant le même nom.
Historique des modifications
Corrections et ajouts vérifiés selon la spécification officielle du Model Context Protocol (modelcontextprotocol.io), la documentation de FastMCP (gofastmcp.com), le README GitHub de messense/copilot-api-proxy, ses forks (ericc-ch/copilot-api, betaHi/copilot-api, craz-yq/copilot-api), la documentation Cloudflare cloudflared, la documentation d’Anthropic pour MCP tunnels, et la documentation officielle du client MCP de Claude :
- Suppression de la structure de métadonnées. Suppression du frontmatter/titre et ligne d’auteur en haut du brouillon, conformément au style de la série.
- Correction majeure — terminologie du transport. La description initiale du transport MCP comme “HTTP/SSE” a été remplacée par Streamable HTTP à partir de la révision MCP du 26-03-2025, qui est maintenant dépréciée (les nouveaux serveurs ne doivent pas l’implémenter). La section Pattern du tunnel MCP a été réécrite pour décrire le transport actuel basé sur POST avec Streamable HTTP, et la révision en brouillon du 28-07-2026 (suppression du flux GET et des IDs de session) a été ajoutée comme note prospective.
- Correction de la gestion de l’effort de raisonnement. La mention selon laquelle les proxys Copilot clampent silencieusement
xhigh/maxàhigha été corrigée :xhighest supporté nativement sur plusieurs modèles actuels, donc un clamp silencieux serait une perte légitime. La recommandation est de faire passer ces niveaux quand supportés, et de clamp uniquement si rejet confirmé. - Vérification et précision des détails du proxy Copilot : port par défaut 9876, chemin de stockage du token (
~/.local/share/copilot-api-proxy/github_token), en-têtes requis (Copilot-Integration-Id,X-Initiator,Openai-Intent,Copilot-Vision-Request), variables d’environnement pour aliasing (BIG_MODEL,MIDDLE_MODEL,SMALL_MODEL) et plafonds (MAX_TOKENS_LIMIT). Ajout d’une note sur le fait que ce sont des forks communautaires non supportés par GitHub, et que les termes de GitHub avertissent contre l’usage automatisé excessif. - Ajout d’un tableau précis des endpoints API (
/v1/chat/completions,/v1/responses,/v1/messages,/v1/messages/count_tokens,/v1/models) basé sur la documentation réelle du proxy. - Section Tunnel Cloudflare : correction du flux de configuration pour indiquer que le paramètre par défaut est maintenant un tunnel géré via dashboard, avec la méthode CLI supportée comme alternative “gérée localement”. Ajout d’un avertissement sur la limite de 200 requêtes et l’absence de support SSE pour les quick tunnels.
- Section Pinggy : exemple d’URL de tunnel réel, limite de 60 minutes, page de vérification unique.
- Code FastMCP : mention que
transport="http"ettransport="streamable-http"sont équivalents et supportés, tandis quetransport="sse"est legacy. - Correction du proxy Node.js : ajout de
require('dotenv').config()et d’un fichier.envpour utiliser la dépendancedotenvcomme indiqué. - Nouvelle section : validation du header
Originpour prévenir le rebinding DNS, recommandation de lier à127.0.0.1. - Disambiguation “MCP tunnel” : pattern communautaire vs fonctionnalité propriétaire d’Anthropic, avec description de leur architecture et usage.
- Checklist opérationnelle : vérification de la liaison en boucle, validation
Origin, sécurité du token, renforcement du tunnel, limites de requêtes, journalisation. - Perspectives : la frontière entre IA cloud et local s’efface, architecture hybride permettant de tirer parti du raisonnement cloud tout en conservant la propriété locale.
Ce document est une traduction fidèle, adaptée pour un public de développeurs, tout en respectant la structure et les termes techniques. La version en français est prête à être intégrée dans votre documentation ou blog.
Related InstaTunnel pages
Continue from this article into the most relevant product guides and workflows.
Related Topics
Keep building with InstaTunnel
Read the docs for implementation details or compare plans before you ship.