Correction du Buffer-Bloat SSE dans les Tunnels Locaux : Garantie d’un Streaming à Zéro Latence pour les LLM Locaux
Éliminez le buffer-bloat SSE dans vos reverse proxies. Apprenez à configurer TCP nodelay et désactiver le buffering HTTP pour un streaming de tokens LLM local sans latence.
Quick answer
Correction du Buffer-Bloat SSE : Streaming à Zéro Latence pour LLM Locaux: webhook testing answer
For local webhook testing, run your app locally, expose it with a public HTTPS tunnel, and paste the stable callback URL into the provider dashboard.
How do I test webhooks on localhost?
Start your local server, open a public HTTPS tunnel to that port, configure the provider webhook URL, and inspect events in your local logs.
Why does a stable webhook URL matter?
Stable URLs prevent provider dashboards from needing manual callback updates every time you restart a tunnel.
Vous venez de déployer un LLM local de pointe en utilisant vLLM, Ollama ou llama.cpp. Lors de vos tests sur localhost, la génération de tokens est une véritable réussite — un flux continu et fluide de texte qui semble instantanément réactif. Mais dès que vous exposez cet endpoint au monde extérieur via un reverse proxy (comme Nginx) ou un tunnel local (tel que Cloudflare Tunnels ou Ngrok), la magie disparaît.
Au lieu d’un flux fluide, votre frontend ne reçoit rien pendant plusieurs secondes, puis un bloc massif de texte arrive tout d’un coup.
Si vous construisez des interfaces d’IA conversationnelle en temps réel, cette sortie “hachée” de tokens détruit l’expérience utilisateur (UX). Elle nuit à vos métriques Time to First Token (TTFT) et donne une impression de lenteur à votre application, peu importe la rapidité de vos GPU pour l’inférence.
Le coupable ? SSE Buffer-Bloat.
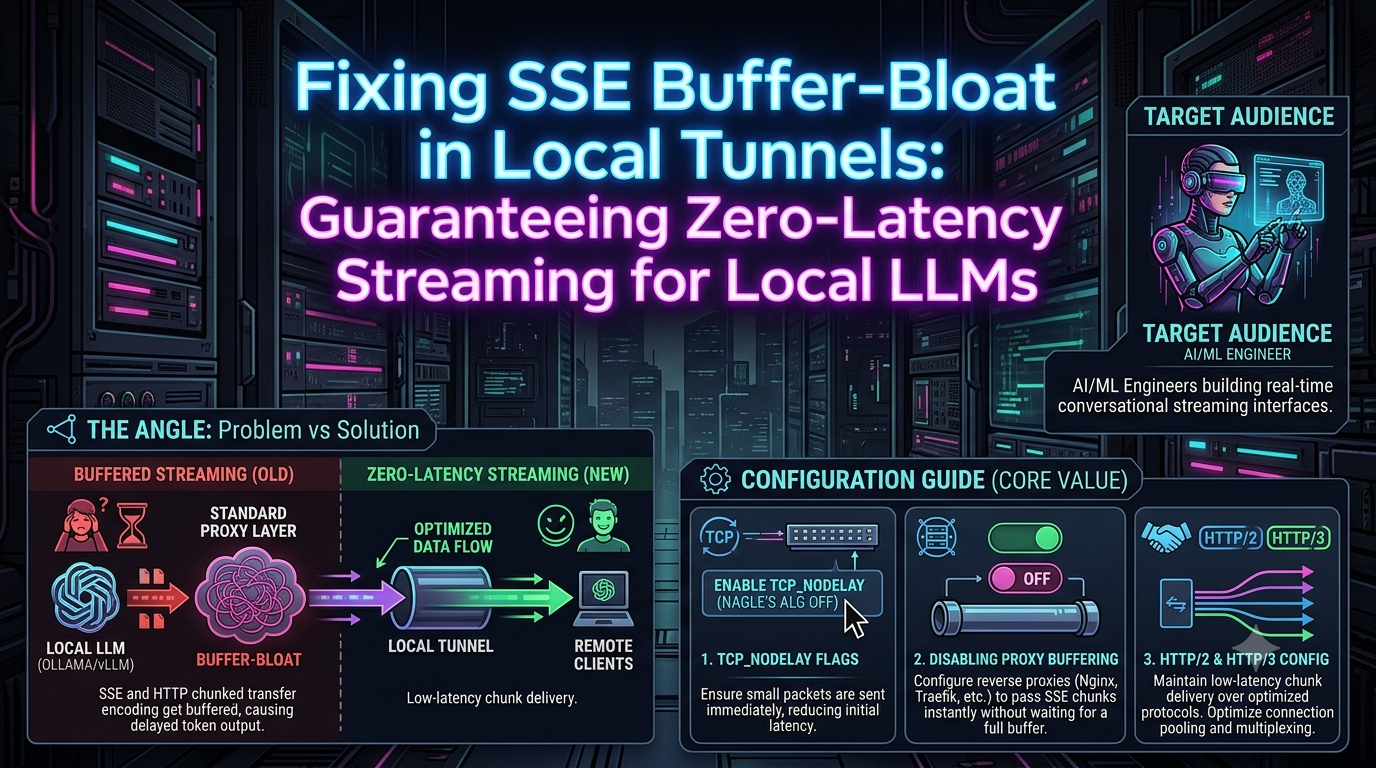
Dans ce guide, nous analyserons pourquoi les couches réseau standard sabotent involontairement les Server-Sent Events (SSE) et l’encodage en chunks HTTP. Plus important encore, nous fournirons un guide de configuration définitif pour désactiver complètement le buffering du proxy, ajuster les flags TCP, et garantir une livraison de chunks à zéro latence pour votre stack AI locale.
La Cause Profonde : Pourquoi les Proxies Brisent le Streaming LLM
Pour comprendre la solution, il faut d’abord comprendre le mode de défaillance. Le streaming LLM repose standardement sur Server-Sent Events (SSE). Dans une connexion SSE, le serveur maintient une seule connexion HTTP ouverte et pousse les données (tokens) dès leur génération, en utilisant Transfer-Encoding: chunked.
L’infrastructure web standard n’a pas été conçue pour cela. Les proxies, équilibrages de charge et tunnels sont historiquement optimisés pour un débit élevé, des charges statiques ou des payloads dynamiques entièrement rendus. Pour économiser la bande passante et les cycles CPU, ils utilisent le buffering.
1. Buffering du Reverse Proxy
Lorsqu’un reverse proxy (comme Nginx) se trouve entre votre LLM et votre client, il bufferise par défaut les réponses. Nginx attend d’accumuler une certaine quantité de données du serveur en amont (par exemple, 4 Ko ou 8 Ko) avant de les transmettre au client. Si votre LLM génère 15 tokens par seconde, cela peut prendre plusieurs secondes pour remplir ce buffer. L’utilisateur voit un écran figé, puis un paragraphe massif apparaît instantanément.
2. L’Algorithme de Nagle (Nagle’s Algorithm)
Au niveau TCP/IP, Nagle’s Algorithm indique que les petits paquets doivent être retardés et regroupés en un seul paquet plus grand pour réduire la congestion réseau. Comme chaque token LLM est minuscule (souvent quelques octets), cet algorithme met en cache ces paquets, injectant une latence artificielle dans votre flux.
3. Incompatibilités des Protocoles de Tunneling
Les outils comme Cloudflare Tunnels (cloudflared) ou Ngrok multiplexent souvent le trafic sur HTTP/2 ou HTTP/3. Alors que le multiplexage HTTP/2 est excellent pour charger simultanément 50 petites images, le buffering agressif par les clients de tunnel peut casser le flux continu et non bufferisé requis par SSE.
Passons en revue ces buffers, couche par couche.
Couche 1 : Réseau & Optimisation Applicative (Désactivation de Nagle)
Avant de corriger le proxy, assurez-vous que votre application n’est pas le goulot d’étranglement. Si vous écrivez un serveur d’inférence personnalisé (par exemple, en Python/FastAPI pour envelopper un modèle ML), vous devez désactiver Nagle en utilisant le flag TCP_NODELAY.
L’activation de TCP_NODELAY indique à la pile TCP d’envoyer les données immédiatement, peu importe la taille du paquet.
Python / FastAPI (Uvicorn)
Si vous utilisez Uvicorn, vous pouvez appliquer cela au niveau du socket. Assurez également que votre générateur au niveau applicatif émet des données sans mise en cache interne.
from fastapi import FastAPI
from fastapi.responses import StreamingResponse
import asyncio

app = FastAPI()

async def token_generator():
    tokens = ["Hello", " world", ",", " this", " is", " streaming", " live!"]
    for token in tokens:
        # Crucial : Formatage en payload SSE correct
        yield f"data: {token}\n\n"
        await asyncio.sleep(0.1) # Simuler le temps d’inférence

@app.get("/stream")
async def stream_llm():
    return StreamingResponse(
        token_generator(),
        media_type="text/event-stream",
        headers={
            "Cache-Control": "no-cache",
            "Connection": "keep-alive",
            "X-Accel-Buffering": "no" # Signale à Nginx de désactiver le buffering
        }
    )
Note : L’en-tête X-Accel-Buffering: no est une astuce majeure. Beaucoup de proxies (notamment Nginx) respectent cet en-tête et désactivent automatiquement le buffering pour cette réponse spécifique.
Couche 2 : Configuration du Reverse Proxy
Si vous placez Ollama ou vLLM derrière un reverse proxy pour gérer la terminaison TLS ou l’authentification par clé API, vous devez explicitement configurer le proxy pour le streaming.
Nginx
Nginx est souvent le principal responsable du buffer-bloat SSE. Par défaut, proxy_buffering est activé. Vous devez le désactiver pour vos endpoints d’inférence. De plus, il faut augmenter les limites de timeout, car la génération LLM peut durer plusieurs minutes.
server {
    listen 443 ssl;
    server_name api.votredomaine.com;

    location /v1/chat/completions {
        proxy_pass http://localhost:8000; # backend vLLM ou Ollama

        # 1. Désactiver le buffering
        proxy_buffering off;
        proxy_cache off;

        # 2. HTTP/1.1 est strictement requis pour WebSockets/SSE dans les anciennes configurations Nginx
        proxy_http_version 1.1;
        proxy_set_header Connection '';

        # 3. Désactiver l’interférence du transfert chunked
        chunked_transfer_encoding on;

        # 4. Éviter les timeouts prématurés pour les prompts longs
        proxy_read_timeout 600s;
        proxy_connect_timeout 600s;
        proxy_send_timeout 600s;

        # En-têtes standards
        proxy_set_header Host $host;
        proxy_set_header X-Real-IP $remote_addr;
    }
}
Caddy
Caddy est généralement plus intelligent sur les standards modernes, mais pour un streaming IA à zéro latence, vous souhaitez explicitement définir l’intervalle de flush pour que les chunks soient envoyés immédiatement.
api.votredomaine.com {
    reverse_proxy localhost:8000 {
        header_up Host {host}
        header_up X-Real-IP {remote}

        # Flush immédiat, désactivant le buffering interne
        flush_interval -1
    }
}
Traefik
Si vous utilisez Traefik dans un environnement Docker/Kubernetes, le buffering peut être désactivé via des labels ou middleware.
# Exemple docker-compose.yml
labels:
  - "traefik.http.middlewares.unbuffer.buffering.maxRequestBodyBytes=0"
  - "traefik.http.middlewares.unbuffer.buffering.memRequestBodyBytes=0"
  - "traefik.http.middlewares.unbuffer.buffering.maxResponseBodyBytes=0"
  - "traefik.http.middlewares.unbuffer.buffering.memResponseBodyBytes=0"
Couche 3 : Naviguer dans les Tunnels Locaux (Cloudflare & Ngrok)
Souvent, les ingénieurs IA ne veulent pas exposer de ports publics ni faire du port forwarding, préférant utiliser des tunnels locaux. Ceux-ci introduisent leurs propres mécanismes de buffering agressifs.
Cloudflare Tunnels (cloudflared)
Cloudflare se place à la périphérie et bufferise souvent les réponses pour appliquer des règles WAF, du caching ou de la compression. Lors du piping SSE via un Tunnel Cloudflare, vous devez respecter deux règles critiques :
- Type de contenu strict : Cloudflare bufferise votre réponse sauf si l’en-tête
Content-Typeest exactementtext/event-stream. Si votre application renvoieapplication/jsonou un type texte simple lors du streaming, Cloudflare attendra la fermeture de la connexion avant de livrer la payload. - Désactiver le buffering dans le Dashboard : Si vous constatez encore des délais, vous pouvez explicitement désactiver le buffering pour votre sous-domaine via des règles de page ou de configuration dans le Dashboard Cloudflare. Créez une règle pour
api.votredomaine.com/*et définissez le Cache Level surBypasset désactivez le Response Buffering.
Note de dépannage : Dans des environnements très sécurisés (comme Cloudflare Zero Trust ou Zscaler), le streaming bidirectionnel HTTP/2 peut être intercepté et bufferisé par la couche de sécurité. Les outils modernes (comme le Cursor AI editor network protocols) sont conçus pour retomber sur HTTP/1.1 SSE lorsque le buffering HTTP/2 est détecté. Si vous avez des problèmes avec cloudflared, forcer HTTP/1.1 sur votre serveur d’origine peut parfois contourner ce buffering agressif.
Ngrok
Ngrok fonctionne généralement bien avec SSE par défaut, à condition que vos en-têtes soient corrects. Cependant, si vous utilisez Ngrok en mode edge, assurez-vous que la compression est désactivée. La compression Gzip/Brotli nécessite un certain buffering avant que l’algorithme de compression ne puisse agir.
Lors du passage de SSE via un tunnel, désactivez explicitement la compression dans vos en-têtes d’application :
Accept-Encoding: identity côté client ou Content-Encoding: identity côté serveur.
Couche 4 : Considérations sur HTTP/2 et HTTP/3
Alors que le web évolue vers HTTP/2 et HTTP/3 (QUIC), le streaming devient plus complexe.
HTTP/2 utilise une seule connexion TCP et multiplexe plusieurs flux dessus. Bien que cela résolve le problème de blocage en tête de ligne pour les assets statiques, les fenêtres de contrôle de flux HTTP/2 peuvent involontairement limiter ou bufferiser les longues connexions SSE à faible débit si elles ne sont pas finement ajustées.
Si vous reverse-proxy une LLM locale sur un réseau à haute latence (par exemple, streaming depuis votre rig à la maison vers un téléphone en 5G), HTTP/3 offre un avantage distinct. Parce que QUIC est basé sur UDP, si un seul paquet contenant un token est perdu, cela ne bloque pas la livraison des tokens suivants (contrairement à TCP, qui suspend le flux pour retransmettre le paquet perdu).
Cependant, de nombreux serveurs d’inférence IA (comme le serveur FastAPI intégré de vLLM) ne supportent pas nativement HTTP/3.
La meilleure stack pour 2026 :
1. Exécutez vLLM/Ollama localement sur du matériel nu (HTTP/1.1).
2. Utilisez Nginx ou Envoy sur la même machine pour terminer TLS, appliquer proxy_buffering off, et exposer une interface HTTP/3 (QUIC) à Internet.
3. Assurez-vous que le client (frontend React/Next.js) utilise un parser SSE supportant les flux fetch modernes sans attendre la fermeture de la connexion.
Liste de vérification pour un streaming IA à zéro latence
Si vos tokens arrivent par morceaux, vérifiez ce qui suit :
- [ ] Niveau Application : Y a-t-il un yield immédiat des données ? (Pas d’ajout massif dans un tableau avant yield)
- [ ] En-têtes : Votre serveur retourne-t-il
Content-Type: text/event-stream? - [ ] En-têtes : Passez-vous
X-Accel-Buffering: nopour désactiver automatiquement le buffering par Nginx ? - [ ] Proxy : La directive
proxy_buffering off;est-elle présente dans votre bloc de localisation Nginx ? - [ ] Compression : La compression Gzip/Brotli est-elle désactivée pour la route SSE ?
- [ ] Tunnels : Si vous utilisez Cloudflare, le Response Buffering est-il désactivé dans vos règles de routage ?
En supprimant systématiquement les buffers de votre stack réseau, vous pouvez restaurer la magie des LLM locaux. Vos utilisateurs (et votre frontend) bénéficieront d’un vrai streaming de tokens en temps réel, avec une latence quasi nulle, pour des interactions aussi rapides que la conversation humaine.
Related InstaTunnel pages
Continue from this article into the most relevant product guides and workflows.
Related Topics
Keep building with InstaTunnel
Read the docs for implementation details or compare plans before you ship.