Architecture de Tunneling à Haute Performance en Edge : Kernel Bypass, XDP et Réglage de BBR
Découvrez comment accélérer le débit des tunnels avec Solarflare Onload, DPDK, filtrage de paquets XDP et réglage TCP BBRv3 pour des réseaux edge haute performance.
Quick answer
Réseautage Low-Level & Optimisation Kernel pour Edge: localhost tunnel answer
A localhost tunnel gives your local app a public HTTPS URL without opening router ports, which is useful for demos, QA, mobile testing, and provider callbacks.
How do I expose localhost without opening ports?
Use a reverse HTTPS tunnel. Your machine connects outbound to the tunnel service, and the public URL forwards requests back to your local app.
When should I use a localhost tunnel?
Use one for webhook testing, OAuth callbacks, client demos, QA previews, mobile device checks, and short-lived development reviews.
Dans les systèmes sensibles à la latence tels que les passerelles de trading, les pipelines de télémétrie et les maillages de relais en edge, la pile réseau Linux générique peut devenir un goulet d’étranglement. Le traitement par paquet dans le kernel ajoute du jitter, et les files d’attente surdimensionnées augmentent la latence. Un relais de tunnel qui forwarding des millions de paquets par seconde ressent ces deux problèmes.
Ce guide couvre trois techniques qui ciblent différentes parties du problème :
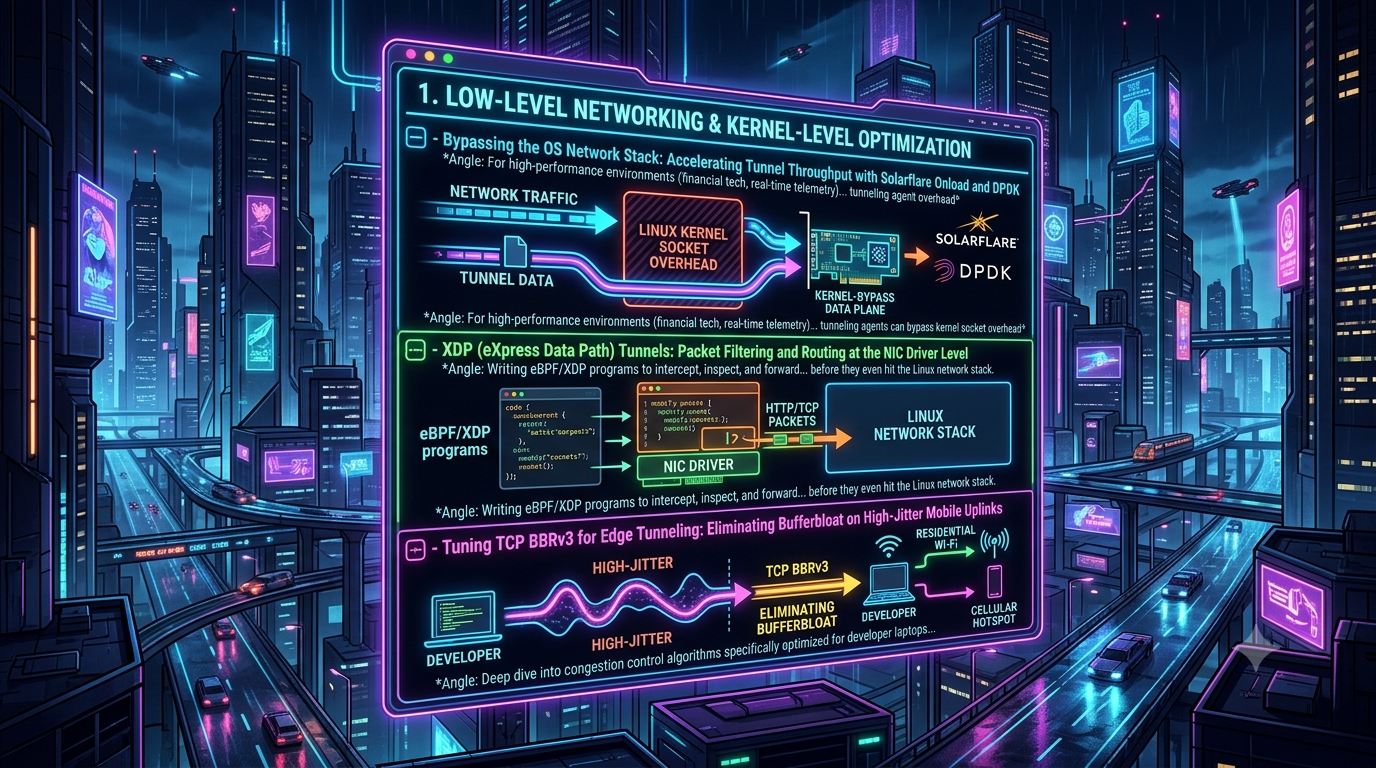
- Data planes en Kernel-bypass avec AMD Solarflare Onload et le Data Plane Development Kit (DPDK).
- eBPF/XDP (eXpress Data Path) pour filtrer et rediriger les paquets au niveau du pilote, avant l’allocation des buffers socket par le kernel.
- Contrôle de congestion BBR pour les chemins avec bande passante variable et buffers profonds, comme les uplinks cellulaires et Wi-Fi résidentiels.
Une réserve s’applique tout au long. Seules le kernel bypass et XDP aident avec le coût CPU par paquet. BBR traite le délai de mise en file d’attente sur le chemin réseau, qui est un problème différent. Choisissez la technique adaptée au goulet d’étranglement que vous avez mesuré.
1. Kernel Bypass : Onload et DPDK
Où la pile standard consomme son temps
Sur le chemin de réception Linux classique, la NIC génère une interruption et la couche NAPI du kernel interroge le périphérique. Le driver alloue un sk_buff, et le paquet passe par les couches de protocole et les hooks netfilter. Enfin, un appel système comme recv copie la charge utile en mémoire utilisateur.
Les kernels modernes regroupent une grande partie de ce travail avec NAPI et la coalescence d’interruptions, évitant une interruption par paquet. Même ainsi, à très haut débit, l’allocation, la copie, le verrouillage et le trafic cache s’accumulent, rendant la latence moins prévisible.
Les designs en Kernel-bypass déplacent le chemin de données en espace utilisateur. La NIC livre les paquets par DMA en mémoire que l’application possède, et celle-ci les traite sans appels système par paquet.
Onload : accélération transparente pour applications socket
Solarflare a été racheté par Xilinx, maintenant partie d’AMD. Son logiciel Onload est toujours développé sous le nom AMD Solarflare, avec le code source disponible en OpenOnload sur GitHub.
- Fonctionnement : OpenOnload est une bibliothèque partagée en espace utilisateur qui intercepte les appels système liés au réseau et implémente la pile TCP/UDP en espace utilisateur. Supporté par des modules kernel, il est compatible binaire avec les applications BSD-sockets existantes. La plupart des applications n’ont donc pas besoin de modifications.
- Chemin matériel : Onload utilise l’interface native
ef_visur les adaptateurs AMD Solarflare.ef_viest une API à très faible latence que les applications peuvent aussi appeler directement. - Autres NICs : Onload peut aussi fonctionner via le mécanisme AF_XDP de Linux, qui ne nécessite pas de matériel Solarflare. La documentation du projet indique que le chemin
ef_vinatif offre une meilleure accélération et des fonctionnalités supplémentaires par rapport au mode AF_XDP. - Matériel actuel : La gamme actuelle AMD comprend la série Alveo X3, avec jusqu’à 4 ports 10⁄25 GbE. Supporte le kernel bypass complet via Onload, TCPDirect et
ef_vi. TCPDirect est une pile utilisateur séparée, décrite par AMD comme ayant une latence encore plus faible qu’Onload. Les anciens adaptateurs SFN8522 et SFN8542 restent listés dans la liste de compatibilité hardware d’Onload. - Support kernel : Le dépôt principal suit les kernels récents, et son README liste actuellement les kernels kernel.org de 6.1 à 7.0. Vérifiez avant de fixer une version de kernel.
DPDK : un cadre de polling à construire
DPDK est un framework en espace utilisateur basé sur des pilotes en mode polling (PMDs). Votre application interroge en boucle active les queues de réception NIC, sans interruption. Les buffers de paquets proviennent de pools mémoire supportés par des hugepages. Contrairement à Onload, DPDK n’est pas transparent : vous écrivez votre boucle de traitement de paquets, et le NIC est détaché de la pile réseau du kernel pendant ce temps.
Pour la planification de release, 25.11 est la version LTS en upstream. DPDK suit un rythme d’environ quatre mois, avec une version prévue 26.11.0 pour le 18 novembre 2026.
Liste de vérification pour déploiements en bypass
- Isoler les cœurs. Dédiez des cœurs aux threads de polling et évitez qu’ils effectuent d’autres tâches. Le guide performance de DPDK recommande
isolcpusavec la réservation de hugepages dans la ligne de commande du kernel. Depuis Linux 6.6, le scheduler par défaut est EEVDF, qui a remplacé CFS. L’isolation des cœurs est importante avec l’un ou l’autre scheduler, car un thread de polling ne doit jamais partager un cœur avec d’autres tâches. - Tout garder en NUMA-local. Le guide DPDK conseille de placer les cœurs de polling et la NIC sur le même socket pour de meilleures performances. Vous pouvez vérifier le nœud d’une NIC dans
/sys/bus/pci/devices/<adresse>/numa_node. Allouez les buffers de paquets depuis ce même nœud. - Réserver des hugepages au démarrage pour les pools mémoire de paquets.
- Planifier les opérations. Une interface bypassée n’apparaît plus dans
tcpdump, iptables ou autres outils d’observabilité classiques. Planifiez votre monitoring et débogage avant la mise en production.
Les vendeurs publient des comparaisons de latence pour ces stacks, comme celles d’AMD pour Onload versus TCP du kernel. Considérez-les comme des mesures vendeurs sur du matériel spécifique, avec des tailles de charge utile et des réglages précis, et benchmarkez votre propre charge.
2. XDP : Traitement de paquets programmable au niveau du pilote
XDP a été introduit dans Linux 4.8 et repose sur eBPF. Avec un support natif du pilote, un programme XDP s’exécute juste après la réception d’un paquet par la NIC, avant l’allocation du buffer socket par le kernel. Cela rend les drops et redirections très peu coûteux. Contrairement à un bypass complet, XDP fonctionne en parallèle avec la pile kernel normale, permettant aux sockets ordinaires, outils et autres composants du système de continuer à fonctionner.
Modes d’exécution
- Mode natif (driver) : par défaut et chemin rapide. Nécessite le support du pilote.
- Mode générique (SKB) : fonctionne sur toute interface en exécutant le hook après l’allocation d’un
sk_buff. Utile pour le développement, mais avec la plupart des bénéfices de performance perdus. - Décalage matériel : le programme s’exécute sur la NIC elle-même. Support rare. Selon la documentation xdp-tools, seules les cartes Netronome/Corigine utilisant le pilote
nfple supportent dans le kernel principal.
Exemple : une liste blanche pour les pairs de tunnel
Ce sketch filtre le trafic UDP vers le port du tunnel sauf si l’adresse source est dans une liste blanche maintenue en espace utilisateur. Le pilote VXLAN de Linux par défaut utilise le port UDP 8472. Le port VXLAN attribué par IANA est 4789, mais Linux a conservé 8472 pour des raisons historiques. VXLAN fonctionne sur UDP, pas TCP. La même logique s’applique à tout tunnel basé sur UDP.
Ce n’est qu’un exemple illustratif, pas un pare-feu renforcé. Construisez et chargez-le avec libbpf et xdp-tools.
#include <linux/bpf.h>
#include <linux/if_ether.h>
#include <linux/in.h>
#include <linux/ip.h>
#include <linux/udp.h>
#include <bpf/bpf_helpers.h>
#include <bpf/bpf_endian.h>

#define TUNNEL_PORT 8472

struct {
    __uint(type, BPF_MAP_TYPE_HASH);
    __uint(max_entries, 1024);
    __type(key, __u32);   /* adresse IPv4 source */
    __type(value, __u8);
} allowed_peers SEC(".maps");

SEC("xdp")
int tunnel_peer_filter(struct xdp_md *ctx)
{
    void *data     = (void *)(long)ctx->data;
    void *data_end = (void *)(long)ctx->data_end;

    struct ethhdr *eth = data;
    if ((void *)(eth + 1) > data_end)
        return XDP_PASS;
    if (eth->h_proto != bpf_htons(ETH_P_IP))
        return XDP_PASS;

    struct iphdr *iph = (void *)(eth + 1);
    if ((void *)(iph + 1) > data_end)
        return XDP_PASS;
    if (iph->protocol != IPPROTO_UDP || iph->ihl < 5)
        return XDP_PASS;

    struct udphdr *udph = (void *)iph + (iph->ihl * 4);
    if ((void *)(udph + 1) > data_end)
        return XDP_PASS;

    if (bpf_ntohs(udph->dest) != TUNNEL_PORT)
        return XDP_PASS;

    __u32 src = iph->saddr;
    if (!bpf_map_lookup_elem(&allowed_peers, &src))
        return XDP_DROP;   /* peer inconnu : drop avant le traitement du stack */

    return XDP_PASS;
}

char _license[] SEC("license") = "GPL";
Actions XDP
XDP_DROP: supprime le paquet au niveau du pilote, buffer recyclé dans la file de réception. Efficace contre les floods et listes noires.XDP_PASS: transmet le paquet, éventuellement modifié, à la pile réseau normale.XDP_TX: renvoie le paquet par la même interface qu’il est arrivé. Utilisé par les load balancers après réécriture d’adresses.XDP_REDIRECT: envoie le paquet ailleurs via une carte de redirection. Cibles courantes : une autre interface XDP (devmap), un autre CPU (cpumap), ou un socket AF_XDP en espace utilisateur (xskmap).
AF_XDP sert de pont avec la section précédente. Il permet à l’espace utilisateur de recevoir des frames brutes d’une queue de pilote sans passer par la pile complète. Un socket AF_XDP se lie à une seule queue netdev, et le type XSKMAP existe depuis Linux 4.18. Il offre un chemin de données en espace utilisateur similaire à DPDK tout en maintenant le NIC sous contrôle du kernel. DPDK possède aussi un PMD AF_XDP, et Onload peut utiliser AF_XDP, comme indiqué ci-dessus.
3. Contrôle de congestion pour liens edge à débit variable
Le problème
Les hotspots mobiles, routeurs résidentiels et stations de base cellulaires maintiennent souvent de grandes files d’attente, ce qui cause le bufferbloat. Un algorithme basé sur la perte comme CUBIC augmente sa fenêtre jusqu’à saturation du buffer. La file reste pleine, la latence augmente pour toutes les flux.
Après une perte, CUBIC réduit sa fenêtre de congestion d’un facteur 0.7 (RFC 9438 indique un facteur de réduction multiplicatif de 0.7, contre 0.5 pour Reno classique). La fenêtre diminue donc d’environ 30%, pas 50.
Ce que fait BBR différemment
BBR est un algorithme basé sur un modèle. Il estime deux propriétés du chemin :
- BtlBw : la bande passante limite, le débit maximal que le chemin peut fournir.
- RTprop : le délai de propagation aller-retour, le délai de référence avec files vides.
Il rythme les paquets selon la bande passante estimée et essaie de maintenir la quantité de données en vol proche du produit bande passante/délai (BDP), soit BtlBw × RTprop. Cela maintient les files courtes et le débit élevé sans dépendre principalement de la perte.
BBRv3 probablement pas dans votre kernel
Configurer net.ipv4.tcp_congestion_control = bbr sur un kernel Linux mainline donne BBRv1, pas v3. Le module tcp_bbr principal est BBRv1 depuis Linux 4.9. La branche v3 de google/bbr est rebased sur des kernels plus récents. En 2025, les mainteneurs indiquaient que le net-next et le mainline portaient encore BBR 1.x. Aucune nouvelle version BBR n’a été annoncée. La valeur sysctl bbr ne permet pas de distinguer v1 de v3. Vérifiez la source de votre kernel, la branche v3 de Google, un kernel distribué ou compilé par un tiers. La documentation BBRv3 indique comment vérifier via sysctl net.ipv4.tcp_available_congestion_control et outils iproute2 patchés.
BBRv3 est en cours de standardisation. Le draft draft-ietf-ccwg-bbr de l’IETF, dernière version (-06, juillet 2026), précise qu’il s’agit de la version 3. Elle devrait devenir une RFC expérimentale.
Par rapport à v1, BBRv2 et v3 prennent en compte la perte et l’ECN pour mieux coexister avec les flux basés sur la perte comme CUBIC.
Où l’appliquer dans une stack de tunneling
Le contrôle de congestion s’exécute côté émetteur des données. Pour un relais de tunnel :
- La configuration du relais contrôle le trafic qu’il envoie vers les clients, comme les téléchargements via le tunnel.
- La configuration du client contrôle ses propres uploads via sa liaison locale.
Changer uniquement le relais n’affecte pas l’upload depuis un laptop sur une liaison cellulaire. Si votre tunnel transporte TCP dans TCP, les contrôleurs de congestion intérieur et extérieur interagissent, ce qui est une source de mauvais comportement. Les tunnels UDP comme WireGuard évitent cette boucle TCP extérieure.
Configuration sysctl de référence
Ajoutez dans /etc/sysctl.d/99-edge-bbr.conf :
# Qdisc de file d'attente équitable : gère le pacing efficacement pour plusieurs flux
net.core.default_qdisc = fq

# Utiliser BBR (v1 sur kernels mainline ; v3 uniquement sur ceux qui le supportent)
net.ipv4.tcp_congestion_control = bbr

# Augmenter les plafonds de buffers pour chemins à haute bande passante et RTT
net.core.rmem_max = 67108864
net.core.wmem_max = 67108864
net.ipv4.tcp_rmem = 4096 87380 33554432
net.ipv4.tcp_wmem = 4096 65536 33554432
Notes sur ces réglages :
fqrecommandé, pas obligatoire. Depuis Linux 4.13, la pile TCP a un fallback de pacing interne, donc BBR fonctionne avec d’autres qdiscs. Le commit kernel indique qu’en l’absence desch_fq, TCP pace avec un timer haute résolution par socket. Le mainteneur Linux Eric Dumazet recommandesch_fqpour de grands déploiements.- Les tailles de buffers doivent correspondre à votre chemin. 32 MiB conviennent pour une liaison d’environ 1 Gbit/s avec 250 ms de RTT (~31 MB BDP). Plus petits pour des chemins plus lents ou courts. Plus grands consomment de la mémoire par connexion.
- Le window scaling et les timestamps sont activés par défaut dans les kernels récents.
ECN : optionnel, à manipuler avec précaution
ECN permet aux routeurs de signaler la congestion en marquant les paquets, plutôt qu’en les dropant. La valeur par défaut net.ipv4.tcp_ecn est 2, acceptant ECN sur connexions entrantes mais ne le demandant pas en sortie. La mettre à 1 demande ECN en sortie aussi.
Cela ne sert que si le routeur limiteur applique réellement ECN. Ne supposez pas que c’est une victoire automatique. La logique ECN de BBRv3 est contrôlée par une option ecn_low par route, adaptée aux environnements où les marques ECN seront DCTCP/L4S. Très différente de la marque RFC 3168 classique. Pour un tunnel standard avec des réseaux last-mile inconnus, désactivez cette option. Activez tcp_ecn = 1 après tests.
Vérification du comportement
Utilisez ss pour inspecter les sockets actifs :
ss -tin '( dport = :443 or sport = :443 )'
Les résultats montrent pacing_rate, delivery_rate et minrtt. Sur kernels BBRv1, un bloc bbr:(...) indique bande passante et RTT estimés. Sur kernels BBRv3, ss affiche des états spécifiques à v3. Ces champs confirment que BBR est actif et ses estimations. Ils ne prouvent pas à eux seuls une latence plus faible. Mesurez la latence sous charge, par exemple avec un ping et un transfert massif, en comparant CUBIC et BBR.
Choisir le bon outil
| Problème | Technique | Coût |
|---|---|---|
| Application Socket-API limitée par CPU et jitter | Onload (transparente) | NICs spécifiques ou mode AF_XDP, plus module kernel Onload |
| Débit élevé avec data plane dédié | DPDK | Réécriture complète avec boucle de polling, cœurs et NICs dédiés |
| Filtrage ou redirection précoces, tout en conservant la pile kernel | XDP / AF_XDP | Développement eBPF, support pilote natif |
| Latence élevée sous charge sur liens last-mile variables | BBR avec fq, testé avec CUBIC |
Vérifiez la version BBR utilisée |
Pour la plupart des relais de tunneling pour développeurs, une liste blanche XDP et un réglage de contrôle de congestion raisonnable sont des premiers pas réalistes. Le kernel bypass complet concerne un ensemble restreint de charges où la pile kernel est identifiée comme goulet d’étranglement.
Références
- Guide de démarrage DPDK Linux : performance NIC sur plateformes Intel
- Minutes de la mise à jour DPDK, août 2026
- Xilinx-CNS/onload sur GitHub
- Adaptateurs AMD Alveo X3
- Documentation Kernel : BPF_MAP_TYPE_XSKMAP
- Page man xdp-loader(8)
- README de google/bbr, branche v3
- Fil de discussion bbr-dev : utiliser BBRv3 avec kernels plus récents
- Draft IETF-ccwg-bbr-06
- RFC 9438 : CUBIC
- Commit Linux 218af599fa63 : pacing TCP interne
- Scheduler EEVDF Linux 6.6 (Phoronix)
Related InstaTunnel pages
Continue from this article into the most relevant product guides and workflows.
Related Topics
Keep building with InstaTunnel
Read the docs for implementation details or compare plans before you ship.