Low-Level Networking & Kernel-Level Optimization : Architecting Ultra-High-Throughput Tunnels in Go and Rust
Maîtrisez le réseau de bas niveau pour les tunnels de développement local. Apprenez à implémenter des appels système zéro-copie, à évoluer avec SO_REUSEPORT, et à corriger le buffer bloat.
Quick answer
Zero-Copy Ingress & Kernel Optimization for High-Throughput: webhook testing answer
For local webhook testing, run your app locally, expose it with a public HTTPS tunnel, and paste the stable callback URL into the provider dashboard.
How do I test webhooks on localhost?
Start your local server, open a public HTTPS tunnel to that port, configure the provider webhook URL, and inspect events in your local logs.
Why does a stable webhook URL matter?
Stable URLs prevent provider dashboards from needing manual callback updates every time you restart a tunnel.
Les systèmes distribués modernes, les outils de tunneling pour le développement local (tels qu’InstaTunnel, ngrok, Cloudflare Tunnels, ou passerelles d’entrée d’entreprise personnalisées), et les routeurs webhook à haute fréquence rencontrent un goulet d’étranglement impitoyable : la frontière entre l’espace noyau Linux et l’espace utilisateur. Lorsqu’on scale des démons proxy pour gérer des centaines de milliers de connexions simultanées traitant des gigabits de télémétrie, de payloads API, ou de transferts de fichiers, les patterns traditionnels de programmation socket (read() et write()) s’effondrent. Les cycles CPU sont gaspillés lors des commutations de contexte, les bus mémoire saturent à cause de copies redondantes de buffers, les caches CPU s’embrouillent, et les latences en fin de file explosent.
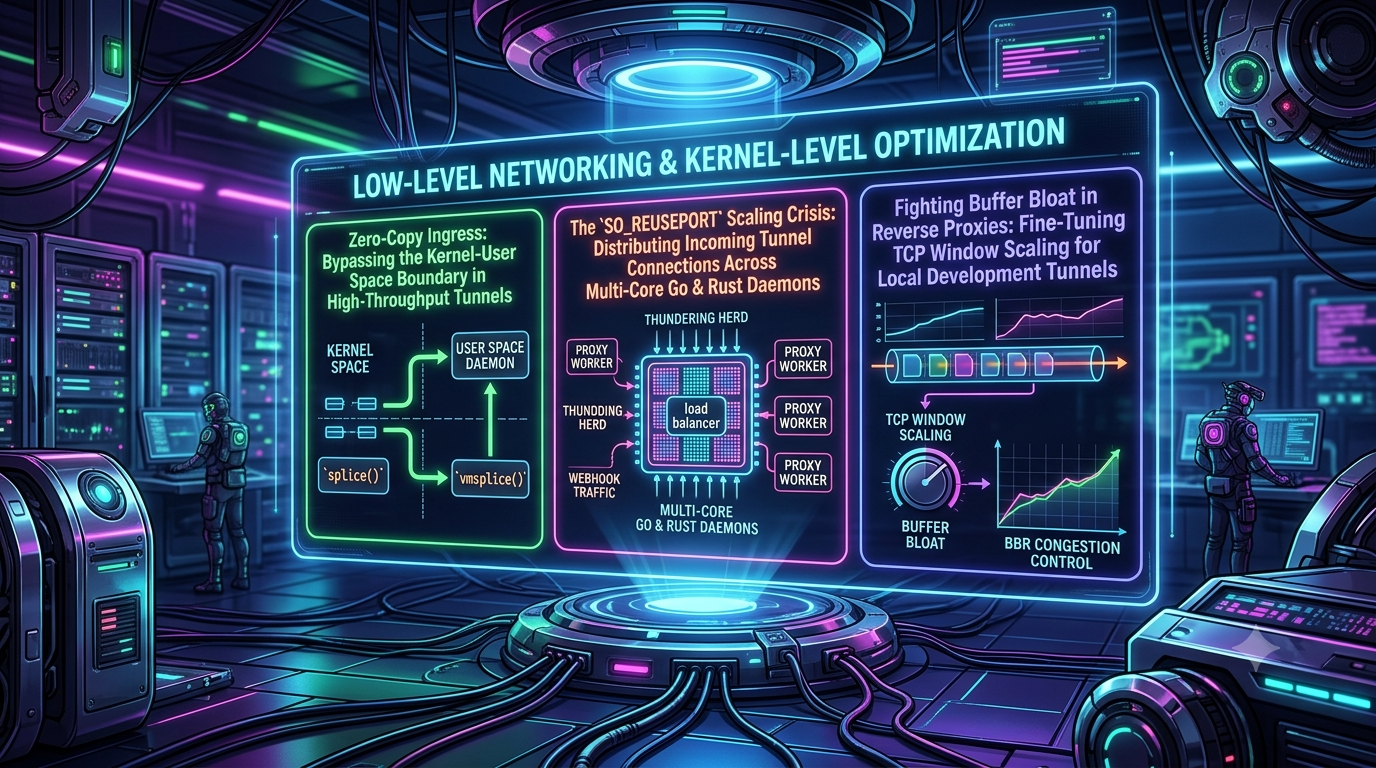
Atteindre des performances de tunneling à la vitesse du fil nécessite une plongée profonde dans la pile réseau Linux. Ce guide complet explore trois piliers critiques de l’optimisation de bas niveau : contourner la frontière noyau-utilisateur avec des primitives zéro-copie comme splice(), résoudre la crise de scalabilité SO_REUSEPORT sur des démons Go et Rust multi-cœurs, et éradiquer le buffer bloat via le contrôle de congestion BBR et le tuning des sockets.
1. Zero-Copy Ingress : Contourner la frontière noyau-utilisateur dans des tunnels à haut débit
Le coût de l’I/O standard dans les proxies
Dans une implémentation classique de démon proxy, déplacer des données d’une socket réseau entrante vers une connexion tunnel sortante implique plusieurs copies mémoire et commutations de contexte. Considérons un chemin de données traditionnel pour une charge utile proxy :
- NIC vers Buffer de socket noyau : La carte réseau (NIC) DMA écrit les paquets entrants dans le buffer circulaire du noyau (sk_buff).
- Commutation de contexte 1 : Le CPU déclenche une interruption matérielle, passant de l’espace noyau à l’espace utilisateur quand l’application appelle
read(). - Copie 1 (Noyau vers Utilisateur) : Le noyau copie les données du buffer de lecture socket noyau dans un buffer utilisateur alloué par le démon proxy (par ex. un slice de bytes en Go ou un
Vec<u8>en Rust). - Commutation de contexte 2 : Le démon proxy traite ou inspecte l’en-tête, puis invoque
write()ousend()pour transmettre la charge utile au backend ou au pair du tunnel, repassant en espace noyau. - Copie 2 (Utilisateur vers Noyau) : Le noyau copie les données du buffer utilisateur dans le buffer d’écriture du socket de destination.
- Noyau vers NIC : Le driver réseau transfère les données du buffer d’écriture noyau vers le NIC via DMA.
Pour un proxy traitant 10 Gbps de trafic, cette architecture force le CPU à copier chaque octet deux fois et à subir des millions de commutations de contexte par seconde. Cela entraîne un embrouillement du cache CPU — car les buffers utilisateur évictent les caches d’instructions chauds et les jeux de travail des caches L1/L2 — et introduit un jitter sévère.
Implémentation de splice() et vmsplice() dans des démons proxy personnalisés
Linux fournit l’appel système splice() (avec vmsplice() et tee()) pour déplacer des données entre deux descripteurs de fichiers sans jamais copier dans l’espace utilisateur. splice() déplace les données vers et depuis un buffer de pipe (pipefs), qui agit comme un buffer circulaire de mémoire dans le noyau.
+---------------------------------------------------------+
| Chemin I/O traditionnel |
| |
| [NIC] -
0 [Socket noyau] ---
0 (Commutation de contexte) |
| ---
0 [Buffer utilisateur] |
| ---
0 (Commutation de contexte) |
| ---
0 [Socket noyau] -
0 [NIC] |
+---------------------------------------------------------+
+---------------------------------------------------------+
| `splice()` zéro-copie |
| |
| [Socket entrant] --\ |
| \ |
| +--
0 [Buffer pipe noyau] |
| / |
| [Socket sortant] -/ |
| (Les données n'entrent jamais dans l'espace utilisateur ; pas de thrashing du cache CPU) |
+---------------------------------------------------------+
Fonctionnement interne de splice()
La signature de splice() en C est :
loff_t splice(int fd_in, loff_t *off_in, int fd_out, loff_t *off_out, size_t len, unsigned int flags);
Lors de la construction d’un démon proxy à haut débit en Rust ou Go, splice() peut être encapsulé via des interfaces de fonctions étrangères (FFI) ou des wrappers d’appels système directs (comme la crate nix en Rust ou golang.org/x/sys/unix en Go).
Pour relier une socket entrante (client_fd) à une socket de tunnel sortant (tunnel_fd) via un pipe intermédiaire :
- Créer un pipe anonyme : Établir une paire de pipes unidirectionnels via
pipe2(O_NONBLOCK)lors de l’initialisation du démon. - Splicer dans le pipe entrant : Appeler
splice(client_fd, NULL, pipe_write_fd, NULL, len, SPLICE_F_MOVE | SPLICE_F_NONBLOCK). Cela indique au noyau de faire pointer les références de page du buffer socket directement dans le buffer du pipe sans copier les octets. - Splicer du pipe vers la sortie : Appeler
splice(pipe_read_fd, NULL, tunnel_fd, NULL, len, SPLICE_F_MOVE | SPLICE_F_NONBLOCK). Le noyau vide les pages du pipe directement dans le buffer du socket cible.
Pièges architecturaux et cas limites
- Contraintes de descripteurs de fichiers : Au moins un des deux descripteurs passés à
splice()doit référencer un pipe. Vous ne pouvez pas faire un splice directement d’une socket A à une socket B ; il faut passer par un pipe intermédiaire. - Sémantiques non bloquantes : Les proxies doivent gérer
EAGAINgracieusement. Si le pipe est plein ou si le buffer du socket ne peut pas accepter plus de données,splice()retourne-1avecerrno = EAGAIN, nécessitant une intégration avec des boucles d’événements epoll/kqueue. - TLS et déchiffrement :
splice()opère uniquement sur des flux d’octets bruts. Si votre tunnel implémente une terminaison TLS au niveau du proxy,splice()ne peut pas être appliqué au ciphertext chiffré à moins d’utiliser le offloading TLS au niveau noyau (KTLS) (setsockoptavecSOL_TCPetTCP_ULP). Avec KTLS activé, le noyau gère la déchiffrement TLS dans l’espace noyau, permettant àsplice()de streamer directement les payloads en clair dans des pipes de routage proxy.
2. La crise de scalabilité SO_REUSEPORT : répartir les connexions entrantes du tunnel sur des démons Go & Rust multi-cœurs
Le problème du troupeau tonitruant et les goulets d’étranglement d’une seule socket
Historiquement, les démons réseau haute performance utilisaient une seule socket d’écoute maître (listenfd). Lorsqu’une nouvelle connexion TCP arrivait via la poignée de main en 3 étapes, le noyau réveillait les threads ou processus bloqués sur accept().
Ce design déclenche le fameux problème du troupeau tonitruant : tous les threads de travail se réveillent simultanément, se disputent le mutex autour de la file d’attente d’accept, et un seul accepte la connexion pendant que les autres se rendorment. Sur un serveur bare-metal de 128 cœurs traitant 100 000 nouvelles connexions par seconde, cela crée une contention de verrou catastrophique sur le lock de socket (sk_lock), faisant exploser la latence.
Introduction de SO_REUSEPORT
Pour éliminer ce goulet d’étranglement, Linux a introduit l’option socket SO_REUSEPORT (étendue significativement à partir de Linux 3.9+). SO_REUSEPORT permet à plusieurs sockets indépendants de se lier à la même adresse IP et port.
Lorsqu’une connexion arrive, la couche TCP du noyau utilise un algorithme de hachage basé sur le tuple 4 (adresse IP source, port source, IP destination, port destination) combiné à une graine spécifique à chaque socket pour router la connexion directement vers un socket d’écoute précis. Chaque thread ou processus de travail maintient son propre socket d’écoute et sa propre file d’attente d’accept, éliminant complètement la contention de verrou.
                         [Paquet SYN TCP entrant]
                                     |
                                     v
                       +---------------------------+
                       | Hash Ring 4-tuple noyau |
                       +---------------------------+
                        /            |            \
                       /             |             \
                      v              v              v
               [Thread de travail 1] [Thread de travail 2] [Thread de travail 3]
               (SO_REUSEPORT)        (SO_REUSEPORT)        (SO_REUSEPORT)
Implémenter SO_REUSEPORT dans des démons Go et Rust
Défi en Go
Le runtime Go gère la surveillance réseau via son netpoller interne (basé sur epoll sous Linux) et abstrait la création de sockets dans le package net. Par défaut, net.Listen standard ne configure pas SO_REUSEPORT.
Pour utiliser SO_REUSEPORT en Go afin de scaler le proxy multi-cœurs, il faut configurer la socket via une callback Control dans net.ListenConfig avant de lier :
package main

import (
	"context"
	"fmt"
	"net"
	"syscall"
)

func createReusePortListener(network, address string, port int) (net.Listener, error) {
	lc := net.ListenConfig{
		Control: func(network, address string, c syscall.RawConn) error {
			var err error
			c.Control(func(fd uintptr) {
				// Définir SO_REUSEADDR
				err = syscall.SetsockoptInt(int(fd), syscall.SOL_SOCKET, syscall.SO_REUSEADDR, 1)
				if err != nil {
					return
				}
				// Définir SO_REUSEPORT
				err = syscall.SetsockoptInt(int(fd), syscall.SOL_SOCKET, syscall.SO_REUSEPORT, 1)
			})
			return err
		},
	}

	addr := fmt.Sprintf("%s:%d", address, port)
	return lc.Listen(context.Background(), network, addr)
}
Implémentation en Rust
En Rust, avec des runtimes asynchrones comme Tokio ou Mio, vous pouvez construire des primitives de socket personnalisées en utilisant la bibliothèque standard ou des crates comme socket2 pour configurer proprement SO_REUSEPORT sur plusieurs threads de travail mappés aux cœurs CPU :
use socket2::{Domain, Protocol, Socket, Type};
use std::net::SocketAddr;

fn create_reuse_listener(addr: SocketAddr) -> std::io::Result<std::net::TcpListener> {
    let domain = Domain::for_address(addr);
    let socket = Socket::new(domain, Type::STREAM, Some(Protocol::tcp()))?;

    // Activer SO_REUSEADDR et SO_REUSEPORT
    socket.set_reuse_address(true)?;
    socket.set_reuse_port(true)?;
    socket.set_nonblocking(true)?;

    socket.bind(&addr.into())?;
    socket.listen(1024)?;

    Ok(socket.into())
}
La crise de scalabilité SO_REUSEPORT : déséquilibre des connexions lors de pics webhook
Bien que SO_REUSEPORT résolve la contention de verrou, elle introduit une crise subtile de scalabilité sous certains trafics — comme un trafic webhook à haute fréquence provenant d’un seul fournisseur cloud (ex. GitHub, Stripe, Slack webhooks).
Cause racine du déséquilibre
La fonction de hachage du 4-tuple du noyau pour SO_REUSEPORT utilise une clé de hachage statique générée lors de la création de la socket. Comme le trafic webhook d’un fournisseur majeur provient souvent d’un pool limité d’IP sources interagissant avec un port proxy destination unique, l’entropie du 4-tuple est fortement contrainte.
En conséquence, la fonction de hachage du noyau peut souffrir de collisions ou de skew, routant 80% des connexions webhook entrantes vers le Thread de travail 1, laissant les autres inactifs. Cela mène à une famine de thread, des backups dans la file, et des timeouts sporadiques.
Stratégies d’atténuation
- Équilibrage BPF (SO_ATTACH_REUSEPORT_CBPF / EBPF) :
Au lieu de se fier à la hachage par défaut du noyau, des proxies avancés attachent un programme eBPF personnalisé aux sockets d’écoute via
setsockoptavecSO_ATTACH_REUSEPORT_EBPF. Le programme eBPF inspecte la charge utile interne, les en-têtes HTTP, ou des clés de routage personnalisées, et dirige explicitement l’index de sélection du socket, assurant une distribution en round-robin parfaite ou basée sur la charge. - Files d’attente d’acceptation à volée : Dans des architectures de démons en espace utilisateur (notamment dans des runtimes Rust asynchrones personnalisés), les threads de travail partagent un buffer circulaire de débordement. Si le taux d’acceptation d’un thread dépasse sa capacité de traitement, les nouveaux descripteurs acceptés sont poussés dans une file globale partagée, que les threads inactifs peuvent piller et traiter.
3. Combattre le Buffer Bloat dans les reverse proxies : ajuster finement le scaling de la fenêtre TCP pour les tunnels de développement local
Qu’est-ce que le Buffer Bloat dans le tunneling ?
Les tunnels de développement local (exposant un port local comme http://localhost:3000 au public via un proxy sécurisé) introduisent des topologies réseau complexes. Les développeurs testent souvent ces tunnels sur des connexions résidentielles à haut débit et haute latence (ex. fibre 500 Mbps avec 30ms–80ms de latence) ou des hotspots mobiles.
Le buffer bloat survient lorsque la capacité excédentaire dans le chemin réseau — que ce soit dans les buffers du routeur, les queues ISP, ou les buffers TCP du noyau Linux — se remplit complètement. Au lieu de perdre des paquets pour signaler la congestion, les buffers intermédiaires les mettent en file d’attente. Pour les reverse proxies gérant de gros uploads ou déploiements d’artifacts via un tunnel, des buffers de socket gonflés causent une latence qui passe de 25ms à plus de 2000ms (latence induite par Bufferbloat), brisant les flux interactifs et déclenchant des timeouts HTTP prématurés.
Diagnostic des pics de latence lors de gros uploads
En inspectant un démon proxy sous charge élevée d’upload avec des outils comme ss, bpftrace, ou ethtool, on observe souvent :
* Queues d’envoi/réception gonflées : Les métriques Send-Q et Recv-Q dans ss -t -i restent obstinément élevées.
* Collapse de congestion CUBIC agressif : Le stack TCP Linux par défaut utilisait la congestion CUBIC, qui augmente rapidement la fenêtre jusqu’à perte de paquets. Sur des liens à haut débit et haute latence (haute BDP), CUBIC surcharge les buffers des routeurs, causant de longues files d’attente.
La formule du BDP (Bandwidth-Delay Product)
Le BDP détermine la quantité de données
Related InstaTunnel pages
Continue from this article into the most relevant product guides and workflows.
Related Topics
Keep building with InstaTunnel
Read the docs for implementation details or compare plans before you ship.