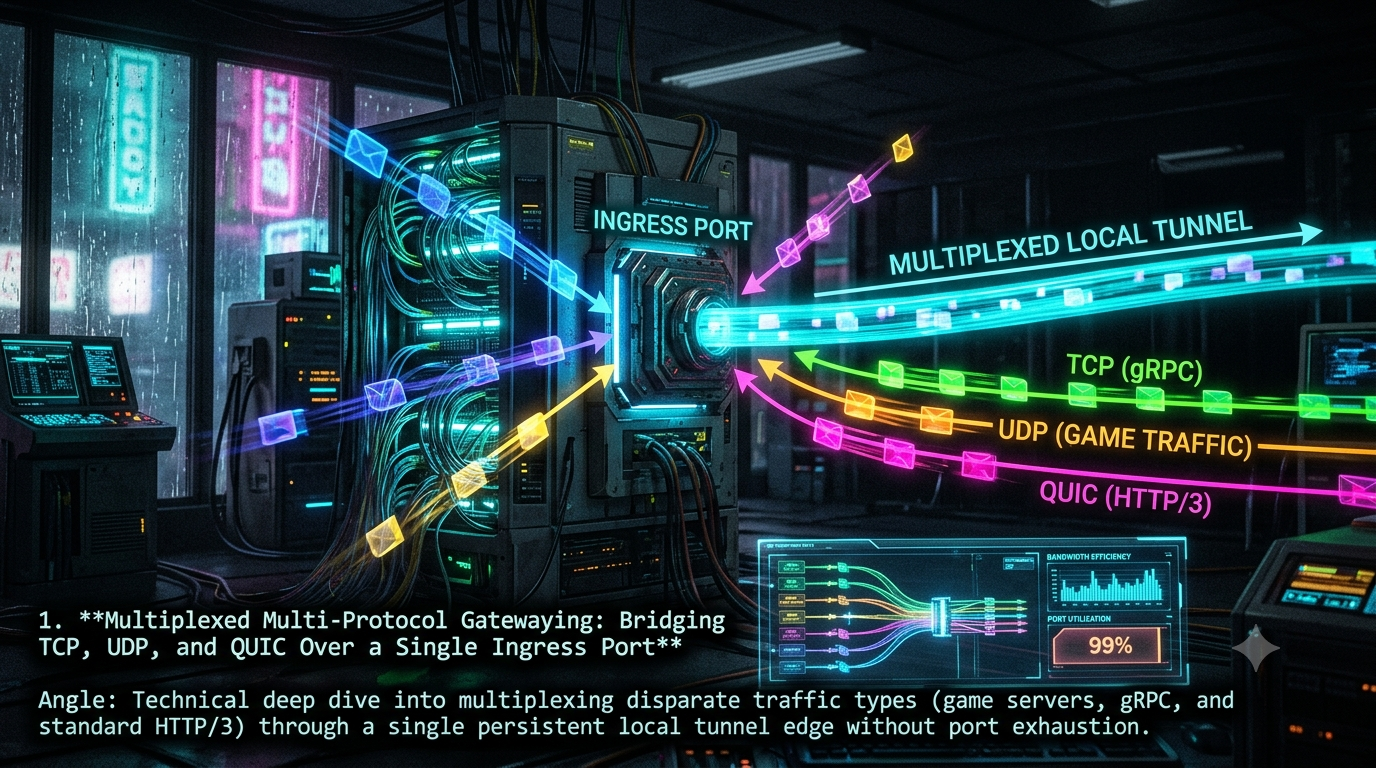
Passerelle multi-protocole multiplexée : relier TCP, UDP et QUIC sur un seul port d'entrée
Découvrez comment la passerelle multiplexée relie TCP, UDP et QUIC sur un seul port d'entrée sans épuisement des ports.
Quick answer
Passerelle multi-protocole multiplexée : relier TCP, UDP: quick comparison answer
Choose the tunnel tool based on the network model: public HTTPS URLs for webhooks and demos, private mesh access for internal apps, and managed infrastructure when policy controls matter most.
Which tunnel tool is best for public webhook testing?
Use a public HTTPS localhost tunnel with stable URLs. InstaTunnel focuses on webhook testing, demos, OAuth callbacks, and MCP endpoint workflows.
When should I choose a private network tool instead?
Choose a private mesh or Zero Trust tool when every user and service should stay inside a controlled private network.
Les backends cloud, serveurs de jeux et réseaux en périphérie cherchent tous à exposer moins de ports. Moins de ports signifient des règles de pare-feu plus simples, moins de load balancers à gérer, et moins de vulnérabilités dans des réseaux stricts d’entreprise ou de fournisseur d’accès. Un seul port public comme 443 ou 8443 peut gérer gRPC et HTTP/2 sur TCP, HTTP/3 sur QUIC, et un protocole UDP personnalisé en temps réel.
L’idée est simple à énoncer et subtile à mettre en œuvre. Ce guide couvre ce que le système d’exploitation fournit gratuitement, comment classifier en toute sécurité le trafic TCP et UDP, où eBPF et XDP apportent leur aide, comment les identifiants de connexion QUIC influencent le routage, et ce qui cause réellement l’épuisement des ports. Il se termine par un petit passerelle en Go, testée, sur laquelle vous pouvez vous appuyer.
1. Que signifie vraiment “port unique”
Un numéro de port n’est pas un espace de noms unique. Le port TCP 443 et le port UDP 443 sont séparés, donc un hôte peut écouter sur les deux en même temps. HTTP/3 fonctionne déjà ainsi : les navigateurs se connectent d’abord via TCP, puis découvrent le point de terminaison HTTP/3 à partir d’un en-tête de réponse Alt-Svc: h3=":443" ou d’un enregistrement DNS HTTPS (RFC 9460). Comme ce point est sur UDP 443, les clients peuvent devoir revenir à TCP si un réseau filtre UDP 443.
Donc “un port” signifie un numéro de port, avec trois problèmes à résoudre en plus :
- Séparation du transport. TCP et UDP sont livrés à des sockets différents par le noyau.
- Sous-protocoles TCP. TLS (et le protocole applicatif qu’il transporte), HTTP/1.1 en clair, HTTP/2 en clair, et les flux de bytes personnalisés arrivent tous sur le même écouteur.
- Sous-protocoles UDP. QUIC et votre propre protocole de datagrammes partagent une seule socket UDP, et UDP ne propose pas de poignée de main pour les différencier.
             ┌───────────────────────────────────────────┐
             │          Port d'entrée public, 443          │
             └───────────┬─────────────────────┬─────────┘
                         │ TCP                 │ UDP
               ┌─────────▼─────────┐   ┌───────▼────────────────┐
               │ Vérification : TLS? PRI?   │   │ Classificateur du premier octet  │
               │ Verbe HTTP? ALPN?  │   │ (RFC 9443 plages)      │
               └───┬─────┬─────┬───┘   └──────┬──────────┬──────┘
                   ▼     ▼     ▼              ▼          ▼
                 gRPC  HTTP/1  personnalisé   QUIC /     UDP personnalisé
                 (h2)          TCP           HTTP/3     (jeu)
Où le 4-tuple ne suffit plus
Quand une adresse socket reçoit plusieurs protocoles, la recherche du noyau (protocole, adresse source et port, adresse destination et port) ne donne que le paquet au bon socket. Tout ce qui suit est votre tâche de classification.
| Transport | Ce que vous pouvez inspecter | Marqueur d’identification | État |
|---|---|---|---|
| TCP (TLS, HTTP/2, gRPC) | Premiers octets du flux | 0x16 = enregistrement de poignée de main TLS ; ALPN dans le ClientHello |
État de la connexion du noyau |
| TCP (en clair) | Premiers octets du flux | PRI * HTTP/2.0… (préambule HTTP/2) ou méthode HTTP |
État de la connexion du noyau |
| UDP (QUIC) | Premier octet de chaque datagramme | Bit élevé = en-tête long ; bits faibles selon RFC 9443 | Identifiants de connexion QUIC, détenus par les endpoints |
| UDP (personnalisé) | Selon votre protocole | Votre propre convention pour le premier octet | À vous de définir |
2. La couche socket : pas besoin de SO_REUSEPORT
Une affirmation courante est que SO_REUSEPORT permet à un socket TCP et à un socket UDP de partager un port. Ce n’est pas le cas. Linux suit les liaisons TCP et UDP dans des tables séparées, donc un écouteur TCP et un socket UDP peuvent lier 0.0.0.0:443 sans options spéciales.
SO_REUSEPORT résout un problème différent : permettre à plusieurs sockets du même protocole de lier la même adresse et le même port, avec le noyau qui répartit les connexions ou datagrammes entrants entre eux. Par défaut, il utilise un hachage sur le 4-tuple, et tous les sockets du groupe doivent appartenir au même UID effectif. C’est ainsi que vous faites évoluer un seul écouteur sur plusieurs threads ou processus.
En Go, la bibliothèque standard suffit :
ln, _ := net.Listen("tcp", "0.0.0.0:443")        // socket TCP
pc, _ := net.ListenPacket("udp", "0.0.0.0:443")  // socket UDP, même port
Utilisez SO_REUSEPORT quand vous souhaitez des écouteurs par cœur ou des redémarrages sans interruption. La section 5 montre comment un programme eBPF peut override son hachage par défaut.
3. Classifier UDP : QUIC versus votre propre protocole
C’est la partie difficile. Un datagramme UDP arrive sans poignée de main, donc le premier octet est tout ce que vous avez.
Ce que garantit (et ne garantit pas) QUIC
RFC 8999 définit uniquement les propriétés qui restent fixes dans toutes les versions de QUIC :
- Le bit le plus significatif du premier octet indique la forme de l’en-tête.
1pour long en-tête,0pour court. - Les en-têtes longs portent un champ Version de 32 bits (
0x00000000réservé pour la négociation de version), puis des identifiants de connexion Destination et Source avec longueur variable. - Les en-têtes courts ne portent que l’ID de connexion Destination, sans champ de longueur, donc un passerelle doit connaître la longueur attendue des ID.
Le bit fixe (0x40) n’est pas invariant. RFC 8999 liste “les paquets QUIC ont toujours le second bit de l’octet (0x40) réglé” parmi les fausses hypothèses qui peuvent être fausses selon la version. En version 1, ce bit est réglé, mais RFC 9287 permet aux endpoints négociant le paramètre de transport grease_quic_bit de le randomiser.
De même, la version 1 de QUIC impose une taille minimale pour les datagrammes initiaux client (1200 octets, RFC 9000 section 14.1), mais cela n’est pas une invariant. Un paquet à en-tête court n’a pas de règle “minimum 3 octets” sur laquelle construire un classificateur.
La méthode standard de multiplexage : RFC 9443
RFC 9443 (qui met à jour RFC 7983) décrit comment démultiplexer STUN, ZRTP, DTLS, TURN, RTP/RTCP, et QUIC sur une seule socket UDP en regardant le premier octet :
| Premier octet | Protocole |
|---|---|
| 0–3 | STUN |
| 4–15 | Ignorer |
| 16–19 | ZRTP |
| 20–63 | DTLS |
| 64–79 | canal TURN si le serveur TURN est connu, sinon QUIC |
| 80–127 | QUIC (en-tête court, bit fixe réglé) |
| 128–191 | RTP / RTCP |
| 192–255 | QUIC (en-tête long, bit fixe réglé) |
Deux conséquences importantes pour une passerelle :
- Ne pas classifier avec “en-tête long OU bit fixe réglé”. Ce test, courant dans les esquisses, correspond à environ trois quarts des premiers octets. Tout protocole personnalisé dont le premier octet tombe dans
0x40–0xFFserait mal routé. RFC 9443 avertit lui-même qu’un classificateur mal implémenté “pourrait potentiellement mal classifier les paquets”. - Les endpoints derrière un multiplexeur ne doivent pas envoyer
grease_quic_bit, car cela casse la méthode du premier octet (RFC 9443, section 1).
Concevoir le protocole personnalisé pour qu’il coexiste
Si vous contrôlez le protocole de jeu, choisissez un premier octet (une version ou un champ de type de message) qui reste dans une plage que QUIC ne peut pas occuper, comme 0–63, ou 128–191 si vous ne transportez pas RTP. Si vous ne pouvez pas changer le protocole, vous devez accepter que la classification par premier octet est une heuristique, ajouter une vérification plus stricte sur le chemin en en-tête long (le champ Version fait 4 octets à l’offset 1, avec des valeurs valides comme 0x00000001 pour QUIC v1 et 0x6b3343cf pour QUIC v2, RFC 9369), et traiter avec précaution tout ce qui est ambigu.
Procédure de décision corrigée
Datagramme reçu
   │
   ▼
octet0 dans 64..127 ou 192..255 ? ──non──► pipeline UDP personnalisé
   │oui
   ▼
En-tête long (octet0 & 0x80) ?
   ├─ oui ► vérifier Version (v1, v2, ou 0 pour négociation) ► QUIC
   └─ non  ► en-tête court : rechercher le DCID dans votre table de connexions
            ├─ trouvé  ► même backend que la connexion
            └─ non trouvé ► abandonner, ou envoyer au backend QUIC (il peut émettre une réinitialisation sans état)
La branche en en-tête court est la plus délicate. Une passerelle en mode transparent ne peut router que les paquets à en-tête court si elle se souvient des identifiants de connexion (étatful) ou si ces identifiants codent la décision de routage (voir section 5). Sans cela, elle ne peut router que par l’adresse client, ce qui pose problème si l’adresse change.
4. Classifier TCP : ALPN, préfaces, et Client Hello chiffré
Pour TCP, la passerelle regarde les premiers octets du flux sans les consommer (recv(..., MSG_PEEK) en C, bufio.Reader.Peek en Go), puis transfère tout, y compris ces octets “en aperçu”, vers le backend choisi.
| Premiers octets | Signification | Routage |
|---|---|---|
0x16 + en-tête TLS |
ClientHello TLS | Analyser ALPN (ci-dessous) |
PRI (PRI * HTTP/2.0\r\n\r\nSM\r\n\r\n) |
HTTP/2 en clair, “connaissance préalable” (h2c), utilisé par gRPC sans TLS | backend HTTP/2 / gRPC |
GET , POST, HEAD, … |
HTTP/1.1 en clair | backend HTTP |
| autre | protocole personnalisé | backend de secours |
Routage ALPN. En TLS 1.3, le ClientHello est non chiffré, et il contient l’extension ALPN (type 16) listant les protocoles applicatifs proposés (h2, http/1.1, ou tokens personnalisés comme game-v1). La passerelle lit la longueur de l’enregistrement TLS depuis l’en-tête de 5 octets, regarde tout l’enregistrement, parcourt les extensions, et routage basé sur ALPN sans terminer TLS. La mise en œuvre en Go dans la section 7 fait exactement cela et a été testée avec de vrais ClientHellos de crypto/tls.
L’avertissement ECH. RFC 9849 standardise l’Encrypted Client Hello. Avec ECH, le client chiffre le contenu sensible du ClientHello, protégeant le SNI et aussi potentiellement ALPN, dans un ClientHello interne. Le ClientHello extérieur ne porte que des valeurs anodines. Une passerelle en mode transparent ne voit donc que ce que le client choisit d’exposer dans le hello extérieur. Avec la croissance du déploiement ECH, le routage basé sur ALPN devient moins fiable, et il faut soit terminer TLS à la passerelle, soit router sur le nom extérieur. Préparez-vous à cela plutôt que de supposer qu’ALPN sera toujours visible.
5. Démultiplexage au niveau du noyau : eBPF, XDP, et steering de socket
Le peek en espace utilisateur coûte un appel système par décision et ne donne pas d’indice au noyau sur où livrer. Deux mécanismes eBPF répondent à cela, et ils résolvent des problèmes différents.
Option A : programmes SK_REUSEPORT (routage vers le bon socket)
Un programme BPF_PROG_TYPE_SK_REUSEPORT remplace le hachage 4-tuple par défaut lors du choix d’un socket dans un groupe SO_REUSEPORT. Pour UDP, la mise à jour du noyau qui l’a introduit décrit directement le cas d’usage : le programme peut regarder dans la charge utile du datagramme pour connaître des informations de connexion applicatives, puis choisir le socket dans une carte BPF. Cela maintient les paquets dans la pile normale du noyau et permet de fixer une connexion QUIC à un worker spécifique par ID de connexion, même si l’adresse du client change. Attachez-le avec setsockopt en utilisant SO_ATTACH_REUSEPORT_EBPF (nécessite CAP_SYS_ADMIN).
Option B : XDP (agir avant la pile réseau)
XDP s’exécute au niveau du driver dès que la NIC livre un paquet, avant que le noyau n’alloue son tampon socket habituel. La couche open-source Katran de Meta, équilibrage de charge de couche 4 basé sur XDP, fonctionne ainsi : “juste après réception par la carte réseau… avant que le noyau n’ait eu la chance de traiter”, en mode driver, avec un mode générique (plus lent) en fallback. XDP peut supprimer, passer, rediriger vers une autre interface, ou rediriger dans une socket AF_XDP.
AF_XDP est important pour la conception, car la redirection vers celui-ci contourne la pile réseau du noyau : le paquet atterrit dans une zone mémoire utilisateur, et vous êtes responsable de tout ce que la pile aurait fait (contrôles UDP, ARP, ICMP, démultiplexage de socket). La documentation du noyau précise aussi plusieurs comportements que les esquisses se trompent souvent :
- Une
XSKMAPest indexée par un entier, et une redirection ne réussit que si le socket à cet index est lié au même périphérique et à la même file de réception que celle du paquet. Sinon, le paquet est rejeté. - Si la carte est vide à cet index, le paquet est rejeté aussi.
- La pratique sûre recommandée est de rechercher d’abord l’index de la file, et de faire
XDP_PASSsi aucun socket AF_XDP n’est lié. - Si vous ne souhaitez que certains trafics en espace utilisateur, orientez-les vers des files spécifiques avec des règles NIC (
ethtool -N … action <file>).
Voici un programme XDP corrigé qui envoie uniquement les datagrammes QUIC dans la plage UDP port 443 vers une socket AF_XDP et laisse passer tout le reste (TCP, UDP personnalisé, ARP, ICMP) dans la pile du noyau. Il se compile avec clang -target bpf; je ne l’ai pas testé en charge sur une NIC.
#include <linux/bpf.h>
#include <linux/if_ether.h>
#include <linux/in.h>
#include <linux/ip.h>
#include <linux/udp.h>
#include <bpf/bpf_helpers.h>
#include <bpf/bpf_endian.h>

#define INGRESS_PORT 443

struct {
    __uint(type, BPF_MAP_TYPE_XSKMAP);
    __uint(max_entries, 64);
    __type(key, __u32);
    __type(value, __u32);
} xsks_map SEC(".maps") ;

SEC("xdp")
int xdp_quic_steer(struct xdp_md *ctx) {
    void *data_end = (void *)(long)ctx->data_end;
    void *data = (void *)(long)ctx->data;

    struct ethhdr *eth = data;
    if ((void *)(eth + 1) > data_end)
        return XDP_PASS;
    if (eth->h_proto != bpf_htons(ETH_P_IP))
        return XDP_PASS;

    struct iphdr *iph = (void *)(eth + 1);
    if ((void *)(iph + 1) > data_end || iph->protocol != IPPROTO_UDP)
        return XDP_PASS;

    struct udphdr *udph = (void *)iph + iph->ihl * 4;
    if ((void *)(udph + 1) > data_end || udph->dest != bpf_htons(INGRESS_PORT))
        return XDP_PASS;

    unsigned char *payload = (void *)(udph + 1);
    if ((void *)(payload + 1) > data_end)
        return XDP_PASS;

    /* RFC 9443 section 3 : premiers octets 64..127 ou 192..255 sont QUIC
     * (64..79 ambigu uniquement pour le trafic d’un TURN ; non géré ici). */
    unsigned char b0 = *payload;
    if (!((b0 >= 64 && b0 <= 127) || b0 >= 192))
        return XDP_PASS; // datagramme UDP personnalisé : laisser à la pile

    __u32 q = ctx->rx_queue_index;
    if (bpf_map_lookup_elem(&xsks_map, &q))
        return bpf_redirect_map(&xsks_map, q, 0);
    return XDP_PASS; // pas de socket AF_XDP sur cette file
}

char _license[] SEC("license") = "GPL";
Ce programme gère IPv4 sans VLAN ni fragmentation IP. Une version de production doit gérer IPv6 et VLAN, et traiter les fragments.
Routage QUIC par ID de connexion entre hôtes
À grande échelle, la question est comment router les paquets à en-tête court sans état par flux. Deux approches existent :
- Routage par ID de serveur. Meta a décrit une méthode sans état lors du Linux Plumbers Conference 2021 où un ID de serveur encodé dans les identifiants permet à l’équilibreur XDP de router TCP et QUIC sans état partagé.
- QUIC-LB. Le draft du groupe de travail QUIC “QUIC-LB : génération d’ID de connexion routables” définit une méthode standard pour encoder des infos de routage dans les ID de connexion choisis par le serveur. Notez que son statut : à cette écriture, c’est un Internet-Draft expiré (dernière révision 21, août 2025), pas une RFC. C’est une référence de conception, pas une norme.
6. Tunnelliser plusieurs protocoles via une seule connexion en périphérie
Un tunnel en périphérie (connexion persistante sortante d’un réseau privé vers un edge public) peut transporter les trois classes de protocoles sur une seule session, évitant d’ouvrir des ports entrants.
                EDGE PUBLIC (port 443)
   Flux TCP ──┐
   Datagrams QUIC ┼──► classificateur ──► multiplexeur de tunnel ══ session extérieure unique ══►
   Datagrams UDP ┘                                                             │
                                                                                ▼
                                          CÔTÉ PRIVÉ : démux par canal ► gRPC :50051
                                                                          ► HTTP/3 :9001
                                                                          ► jeu  :7777
Utiliser la primitive adaptée à chaque trafic
- TCP et autres flux de bytes se mappent naturellement sur des flux (un flux multiplexé par connexion acceptée). Ne les décrivez pas comme “segments” ; le tunnel transporte un flux de bytes, pas des segments TCP.
- UDP et QUIC sont des datagrammes. Les pousser dans un seul flux fiable, ordonné réintroduit le head-of-line blocking et la retransmission, ce que le trafic en temps réel cherche à éviter. Transportez-les dans des datagrammes non fiables. Les standards existants couvrent cela : trames QUIC DATAGRAM (RFC 9221), Datagrammes HTTP (RFC 9297), et CONNECT-UDP (RFC 9298, “Proxying UDP in HTTP”), qui proxyient UDP sur HTTP/2 ou HTTP/3 et peuvent utiliser QUIC datagrams en HTTP/3. Si vous utilisez l’un de ces mécanismes, vous héritez d’un encadrement compatible et du support de proxy.
- WireGuard est un tunnel de couche 3 qui transporte des paquets IP sur UDP, donc il convient comme transport pour des paquets bruts, pas comme substrat de flux.
Un exemple de cadre personnalisé
Si vous construisez votre propre encadrement, gardez-le simple et explicite. Voici une conception d’exemple, pas une norme :
 0                   1                   2                   3
 0 1 2 3 4 5 6 7 8 9 0 1 2 3 4 5 6 7 8 9 0 1 2 3 4 5 6 7 8 9 0 1
+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+
|  Magique (0xA5) | Type de protocole |           ID de canal          |
+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+
|                         Jeton de session                         |
+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+
|        Longueur du payload        |        Données du payload ... |
+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+
| Champ | Taille | Objectif |
|---|---|---|
| Magique | 8 bits | Vérification de cohérence de la trame (0xA5) |
| Type de protocole | 8 bits | 0x01 données de flux, 0x02 datagramme UDP, 0x03 datagramme QUIC |
| ID de canal | 16 bits | Service backend ou locataire |
| Jeton de session | 32 bits | Identifiant client pour la recherche d’état |
| Longueur du payload | 16 bits | Jusqu’à 65 535 octets, pour le plus grand payload UDP |
Un jeton de 32 bits est une clé de recherche, pas une crédentiale. Tout ce qui authentifie un client de tunnel doit venir d’un vrai handshake (TLS, jeton signé, ou clés WireGuard), jamais d’un compteur devinable.
7. Épuisement des ports, état de session, et ce qui limite réellement
L’“épuisement des ports” est souvent blâmé pour beaucoup de choses. Voici ce qui s’applique réellement.
La limite de ports éphémères est par destination. Sur Linux, la plage par défaut sortante est 32768–60999, soit environ 28 232 ports. Une connexion est identifiée par son 4-tuple, donc la même IP source et port peuvent être réutilisés pour des connexions vers différentes destinations. La limite pratique apparaît quand une passerelle ouvre beaucoup de connexions depuis une même IP source vers une IP et un port backend unique : cela atteint la taille de la plage.
Les mitigations, par ordre de préférence :
- Multiplexer plutôt qu’un seul socket par client. Transportez plusieurs flux client sur quelques connexions backend longues (HTTP/2 ou votre propre encadrement). La documentation de Cloudflare sur les ports éphémères souligne cela : des connexions longues et multiplexées surpassent le churn de connexions.
- Étaler sur plusieurs 4-tuple. Utilisez plusieurs adresses ou ports backend, ou plusieurs IP source.
- Élargir ou partitionner la plage. Augmentez-la via
net.ipv4.ip_local_port_range; les noyaux plus récents proposent aussi une option par socketIP_LOCAL_PORT_RANGEpour diviser la plage.
Tables de sessions. Pour le trafic sans connexion, la passerelle doit maintenir une table qui associe un client (ou un ID de connexion) à son chemin en amont, avec un timeout d’inactivité pour supprimer les entrées. Gardez-la limitée et nettoyez-la régulièrement ; une table illimitée est une source de déni de service.
Appareils TUN. Injecter des paquets IP bruts via une interface TUN (/dev/net/tun) permet de faire du routage layer 3, donc votre processus n’alloue pas de ports éphémères par client. Ce n’est pas la même chose que “contourner les limites OS de ports” : si le noyau fait NAT ou masquerading pour atteindre le backend, il alloue quand même des ports source. Utilisez TUN quand vous pouvez faire du routage end-to-end sans NAT.
Migration de connexion QUIC. QUIC sépare une connexion de l’IP et du port du client en utilisant des ID de connexion (RFC 9000, section 5.1). Deux détails changent la façon dont une passerelle doit se comporter :
- Un client migrateur change d’ID de connexion, pas le même sur les deux chemins. RFC 9000 exige que les ID ne soient pas liés par des observateurs et limite chaque ID à une paire d’adresses (sections 5.1 et 9.5). Une passerelle qui suit “ce CID correspond à ce backend” perdra la connexion si le client change de réseau.
- Une passerelle en mode transparent ne peut pas lire les nouveaux ID, car les frames
NEW_CONNECTION_IDvoyagent dans des paquets chiffrés. La solution est que le serveur émette des ID routables (routage par ID de serveur ou QUIC-LB, section 5), ou que la passerelle termine QUIC elle-même. La section 5.2.3 de RFC 9000 décrit la solution de repli pour les équilibrages simples : les serveurs peuvent envoyer le paramètre de transportdisable_active_migration, ou utiliserpreferred_addresspour déplacer les clients vers une adresse dédiée.
Notez aussi que les ID de connexion de longueur zéro sont fragiles derrière une adresse partagée : RFC 9000 interdit d’utiliser une même IP et port pour plusieurs connexions à CID zéro simultanées, sauf si migration et NAT sont exclus.
8. Une passerelle de référence testée en Go
Le programme suivant implémente la conception ci-dessus en utilisant uniquement la bibliothèque standard :
- Il écoute sur un port pour TCP et UDP.
- Pour TCP, il regarde les premiers octets, analyse le ClientHello TLS pour lire ALPN (
h2ouhttp/1.1), reconnait le préambule HTTP/2 en clair et les méthodes HTTP, et routage tout le reste vers un backend de secours. Les octets en aperçu sont rejoués au backend. - Pour UDP, il classe chaque datagramme selon les plages RFC 9443 et maintient une socket en amont par client et backend, avec expiration inactivité, relayant les réponses via la socket d’écoute.
Je l’ai compilé, lancé go vet, et testé avec des backends locaux d’écho. Les tests couvrent le routage en clair (PRI, GET, octets inconnus), le routage UDP sur les frontières de plage (0xC0, 0x45 vers QUIC ; 0x05, 0x3F, 0x90 vers le backend personnalisé), et le parser ALPN avec de vrais crypto/tls ClientHellos (h2, http/1.1, un protocole inconnu, et sans ALPN).
// Passerelle TCP+UDP sur port unique : routage TCP par ALPN TLS / préambule HTTP,
// routage UDP par plages du premier octet RFC 9443. Bibliothèque standard uniquement.
package main

import (
	"bufio"
	"context"
	"io"
	"log"
	"net"
	"os"
	"os/signal"
	"sync"
	"syscall"
	"time"
)

type Config struct {
	Listen      string
	H2Backend   string // gRPC / HTTP/2
	HTTPBackend string // HTTP/1.1
	TCPFallback string // tout autre protocole (TCP personnalisé)
	QUICBackend string // UDP, QUIC / HTTP/3
	GameBackend string // UDP, protocole personnalisé
	UDPIdle     time.Duration
}

func main() {
	cfg := Config{
		Listen: "0.0.0.0:8443", H2Backend: "127.0.0.1:50051", HTTPBackend: "127.0.0.1:8080",
		TCPFallback: "127.0.0.1:9000", QUICBackend: "127.0.0.1:9001", GameBackend: "127.0.0.1:7777",
		UDPIdle: 60 * time.Second,
	}
	ctx, stop := signal.NotifyContext(context.Background(), os.Interrupt, syscall.SIGTERM)
	defer stop()
	go serveTCP(ctx, cfg)
	go serveUDP(ctx, cfg)
	<-ctx.Done()
}

// ---------- TCP ----------

func serveTCP(ctx context.Context, cfg Config) {
	ln, err := net.Listen("tcp", cfg.Listen)
	if err != nil {
		log.Fatalf("tcp listen: %v", err)
	}
	go func() { <-ctx.Done(); ln.Close() }()
	for {
		c, err := ln.Accept()
		if err != nil {
			return
		}
		go handleTCP(c, cfg)
	}
}

func handleTCP(c net.Conn, cfg Config) {
	defer c.Close()
	br := bufio.NewReaderSize(c, 16*1024+5)
	c.SetReadDeadline(time.Now().Add(5 * time.Second)) // délai de détection
	backend := cfg.TCPFallback
	if hdr, err := br.Peek(5); err == nil {
		switch {
		case hdr[0] == 0x16: // enregistrement de poignée de main TLS
			recLen := int(hdr[3])<<8 | int(hdr[4])
			if rec, err := br.Peek(5 + recLen); err == nil {
				switch alpnPick(rec[5:]) {
				case "h2":
					backend = cfg.H2Backend
				case "http/1.1":
					backend = cfg.HTTPBackend
				}
			}
		case string(hdr[:4]) == "PRI ": // préambule HTTP/2 en clair
			backend = cfg.H2Backend
		case isHTTPVerb(hdr):
			backend = cfg.HTTPBackend
		}
	}
	c.SetReadDeadline(time.Time{})
	up, err := net.DialTimeout("tcp", backend, 3*time.Second)
	if err != nil {
		log.Printf("dial %s: %v", backend, err)
		return
	}
	defer up.Close()
	var wg sync.WaitGroup
	wg.Add(2)
	go func() { defer wg.Done(); io.Copy(up, br); closeWrite(up) }() // rejoue les octets en aperçu
	go func() { defer wg.Done(); io.Copy(c, up); closeWrite(c) }()
	wg.Wait()
}

func closeWrite(c net.Conn) {
	if cw, ok := c.(interface{ CloseWrite() error }); ok {
		cw.CloseWrite()
	}
}

func isHTTPVerb(b []byte) bool {
	for _, v := range []string{"GET ", "POST", "HEAD", "PUT ", "DELE", "OPTI", "PATC"} {
		if string(b[:4]) == v {
			return true
		}
	}
	return false
}

// alpnPick retourne le premier protocole ALPN préféré par le client parmi h2/http/1.1,
// ou "" si le ClientHello n’a pas d’extension ALPN (ou ne peut pas être analysé).
func alpnPick(rec []byte) string {
	p := rec
	adv := func(n int) []byte {
		if len(p) < n {
			p = nil
			return nil
		}
		out := p[:n]
		p = p[n:]
		return out
	}
	if h := adv(4); h == nil || h[0] != 0x01 { // type handshake ClientHello + longueur 3 octets
		return ""
	}
	adv(2 + 32) // version legacy + random
	if l := adv(1); l != nil {
		adv(int(l[0])) // session id
	}
	if l := adv(2); l != nil {
		adv(int(l[0])<<8 | int(l[1])) // suites de chiffrement
	}
	if l := adv(1); l != nil {
		adv(int(l[0])) // méthodes de compression
	}
	l := adv(2)
	if l == nil {
		return ""
	}
	exts := adv(int(l[0])<<8 | int(l[1]))
	for len(exts) >= 4 {
		typ := int(exts[0])<<8 | int(exts[1])
		n := int(exts[2])<<8 | int(exts[3])
		if len(exts) < 4+n {
			return ""
		}
		body := exts[4 : 4+n]
		exts = exts[4+n:]
		if typ != 16 || len(body) < 2 { // négociation de protocole de couche application
			continue
		}
		list := body[2:]
		for len(list) > 0 {
			k := int(list[0])
			if len(list) < 1+k {
				return ""
			}
			switch s := string(list[1 : 1+k]); s {
			case "h2", "http/1.1":
				return s
			}
			list = list[1+k:]
		}
	}
	return ""
}

// ---------- UDP ----------

// classifyUDP suit RFC 9443 section 3 : premiers octets 128..191 ou 192..255 sont QUIC;
// 64..79 sont QUIC sauf si venant d’un TURN (non géré ici).
// Gardez votre propre protocole dans 0..63 ou 128..191.
func classifyUDP(first byte) (isQUIC bool) {
	return (first >= 64 && first <= 127) || first >= 192
}

type udpSession struct {
	up   *net.UDPConn
	seen time.Time
}

func serveUDP(ctx context.Context, cfg Config) {
	pc, err := net.ListenPacket("udp", cfg.Listen)
	if err != nil {
		log.Fatalf("udp listen: %v", err)
	}
	conn := pc.(*net.UDPConn)
	go func() { <-ctx.Done(); conn.Close() }()

	quicAddr, _ := net.ResolveUDPAddr("udp", cfg.QUICBackend)
	gameAddr, _ := net.ResolveUDPAddr("udp", cfg.GameBackend)

	var mu sync.Mutex
	sessions := map[string]*udpSession{} // clé : adresse client + backend

	go func() { // nettoyage inactif
		t := time.NewTicker(cfg.UDPIdle / 4)
		defer t.Stop()
		for range t.C {
			mu.Lock()
			for k, s := range sessions {
				if time.Since(s.seen) > cfg.UDPIdle {
					s.up.Close()
					delete(sessions, k)
				}
			}
			mu.Unlock()
		}
	}()

	buf := make([]byte, 65535)
	for {
		n, client, err := conn.ReadFromUDP(buf)
		if err != nil {
			return
		}
		if n == 0 {
			continue
		}
		target := gameAddr
		if classifyUDP(buf[0]) {
			target = quicAddr
		}
		key := client.String() + ">" + target.String()
		mu.Lock()
		s := sessions[key]
		if s == nil {
			up, err := net.DialUDP("udp", nil, target)
			if err != nil {
				mu.Unlock()
				continue
			}
			s = &udpSession{up: up}
			sessions[key] = s
			go func(up *net.UDPConn, client *net.UDPAddr) { // backend -> client
				b := make([]byte, 65535)
				for {
					m, err := up.Read(b)
					if err != nil {
						return
					}
					conn.WriteToUDP(b[:m], client)
				}
			}(up, client)
		}
		s.seen = time.Now()
		mu.Unlock()
		s.up.Write(buf[:n])
	}
}
Ce que cette passerelle ne fait pas délibérément
C’est une base, pas un produit fini. Avant de l’exposer à Internet, prévoyez :
- Préservation de l’adresse client. Les backends voient l’adresse de la passerelle. Utilisez le protocole PROXY pour TCP, ou portez l’adresse client dans l’encadrement du tunnel.
- Conscience de l’ID de connexion QUIC. Les sessions sont indexées par l’adresse client, donc un client qui migre de réseau obtient une nouvelle socket en amont. Combinez avec des ID routables émis par le serveur (section 5) si vous souhaitez que la migration survive.
- Une socket en amont par client UDP. C’est simple et correct, mais chaque socket utilise un port éphémère, donc il hérite des limites de la section 7. Limitez le nombre de sessions et considérez les architectures multiplexées.
- Contrôles d’abus. Il n’y a pas de limites de débit, de connexions, ou de protection contre l’amplification. Les serveurs QUIC doivent limiter ce qu’ils envoient à une adresse non validée à trois fois ce qu’ils ont reçu (RFC 9000, section 8), et une passerelle relayant des réponses à des sources usurpées peut être abusée de la même manière.
- Sniffing à la Slowloris. La limite de délai de 5 secondes limite les connexions inactives, mais il faut aussi limiter le nombre de connexions non classifiées simultanées.
- Comportement en mode fermé en cas d’erreur. Les premiers octets inconnus ou malformés tombent actuellement dans le backend de secours. Décidez si votre déploiement doit les abandonner.
9. Mesurer le bénéfice plutôt que supposer
Consolider les ports est surtout un gain opérationnel : moins de règles de pare-feu, moins d’écouteurs, un seul endroit pour appliquer la politique. Les gains de performance dépendent de la charge, donc mesurez avant de prétendre. Les chiffres “avant/après” publiés ou inventés ne se transfèrent pas entre environnements, et les mécanismes principaux cités nécessitent une attention :
- Latence de handshake. Un port unique ne raccourcit pas un handshake TLS ou QUIC, et ALPN est dans le ClientHello, donc n’ajoute pas de round trip supplémentaire. QUIC 0-RTT ne concerne que la reprise, et RFC 9000 avertit qu’il ne protège pas contre la rejouabilité, donc ce n’est pas un gain de latence général ni une option sûre pour des requêtes non idempotentes.
- Coût par paquet. La classification en espace utilisateur coûte un appel système ou deux par datagramme. La classification côté noyau (
SK_REUSEPORTou XDP) supprime ce coût pour le trafic qu’elle gère. La lecture en batch (recvmmsg, UDP GRO et GSO sur noyaux supportés) réduit encore, sans eBPF. XDP avec AF_XDP échange des fonctionnalités de la pile noyau contre la vitesse, ce qui est rentable à haute fréquence de paquets, pas pour des charges classiques de serveurs de jeux. - Ce qu’il faut mesurer. Temps de mise en connexion (p50/p99), paquets par seconde par cœur à un taux de perte fixé, CPU par Gbit/s, sockets et ports éphémères utilisés (
ss -s), et pertes à chaque étape (NIC, buffers, table de sessions). Testez avec votre vrai mix client, y compris clients QUIC migrateurs et derrière NAT.
10. Liste de vérification de l’implémentation
- Sockets. Liez TCP et UDP au même port avec des écouteurs classiques ; ajoutez
SO_REUSEPORTuniquement pour la montée en charge par cœur. - Classification UDP. Utilisez les plages du RFC 9443, jamais “en-tête long ou bit fixe”. Gardez le premier octet de votre protocole hors des plages QUIC, et ne pas activer
grease_quic_bitsur des endpoints derrière un multiplexeur d’octet. - Routage QUIC. Décidez dès le départ comment les paquets à en-tête court trouvent leur backend : ID de connexion routable émis par le serveur (routage par ID de serveur, QUIC-LB), table de connexions, ou terminaison QUIC à la passerelle. Sans cela, la migration échoue.
- Classification TCP. Peek, ne consomme pas ; analysez ALPN dans le ClientHello ; gérez le préambule
PRIet les méthodes HTTP ; prévoyez ECH. - Accélération noyau. Privilégiez
SK_REUSEPORTavec eBPF (il garde la pile normale) ; utilisez XDP et AF_XDP uniquement si vous avez besoin de vitesse au niveau du driver et pouvez gérer la pile utilisateur. - Tunnels. Transportez flux comme flux, datagrammes comme datagrammes (RFC 9221, RFC 9297, RFC 9298), et authentifiez correctement les clients de tunnel.
- Budgets de ports. Comptez les ports éphémères par 4-tuple backend, pas par hôte, et multiplexez avant d’élargir la plage.
- Renforcement. Limitez chaque table, expirez chaque session, limitez le débit des sources UDP non validées, et décidez du traitement du trafic non classifiable.
Références
- RFC 8999 : Propriétés indépendantes de la version de QUIC
- RFC 9000 : QUIC : un transport multiplexé et sécurisé basé sur UDP
- RFC 9443 : Mises à jour du schéma de multiplexage pour QUIC
- RFC 9849 : Client Hello chiffré TLS
- RFC 9298 : Proxy UDP dans HTTP
- AF_XDP, documentation du noyau Linux
- BPF_PROG_TYPE_SK_REUSEPORT, documentation eBPF
- QUIC-LB : génération d’ID de connexion routables (Internet-Draft)
- Katran, load balancer couche 4 basé sur XDP de Meta
- De XDP à socket, Conférence Linux Plumbers 2021
- Cloudflare : comment éviter la saturation des ports éphémères
- Peakhour : comment les navigateurs décident d’utiliser HTTP/3
Related InstaTunnel pages
Continue from this article into the most relevant product guides and workflows.
Related Topics
Keep building with InstaTunnel
Read the docs for implementation details or compare plans before you ship.