高性能エッジトンネリングアーキテクチャ:Kernel Bypass、XDP、BBRチューニング
Solarflare Onload、DPDK、XDPパケットフィルタリング、TCP BBRv3チューニングを活用し、高性能エッジネットワークのスループットを向上させる方法を解説します。
Quick answer
エッジ向け低レベルネットワーク&カーネル最適化: localhost tunnel answer
A localhost tunnel gives your local app a public HTTPS URL without opening router ports, which is useful for demos, QA, mobile testing, and provider callbacks.
How do I expose localhost without opening ports?
Use a reverse HTTPS tunnel. Your machine connects outbound to the tunnel service, and the public URL forwards requests back to your local app.
When should I use a localhost tunnel?
Use one for webhook testing, OAuth callbacks, client demos, QA previews, mobile device checks, and short-lived development reviews.
遅延に敏感なシステム、例えば取引ゲートウェイ、テレメトリーパイプライン、エッジリレーメッシュでは、汎用Linuxネットワークスタックがボトルネックになることがあります。カーネル内でのパケットごとの処理はジッターを増加させ、経路上の過大なキューは遅延を引き起こします。毎秒数百万のパケットを転送するトンネルリレーは、これらの問題を両方抱えています。
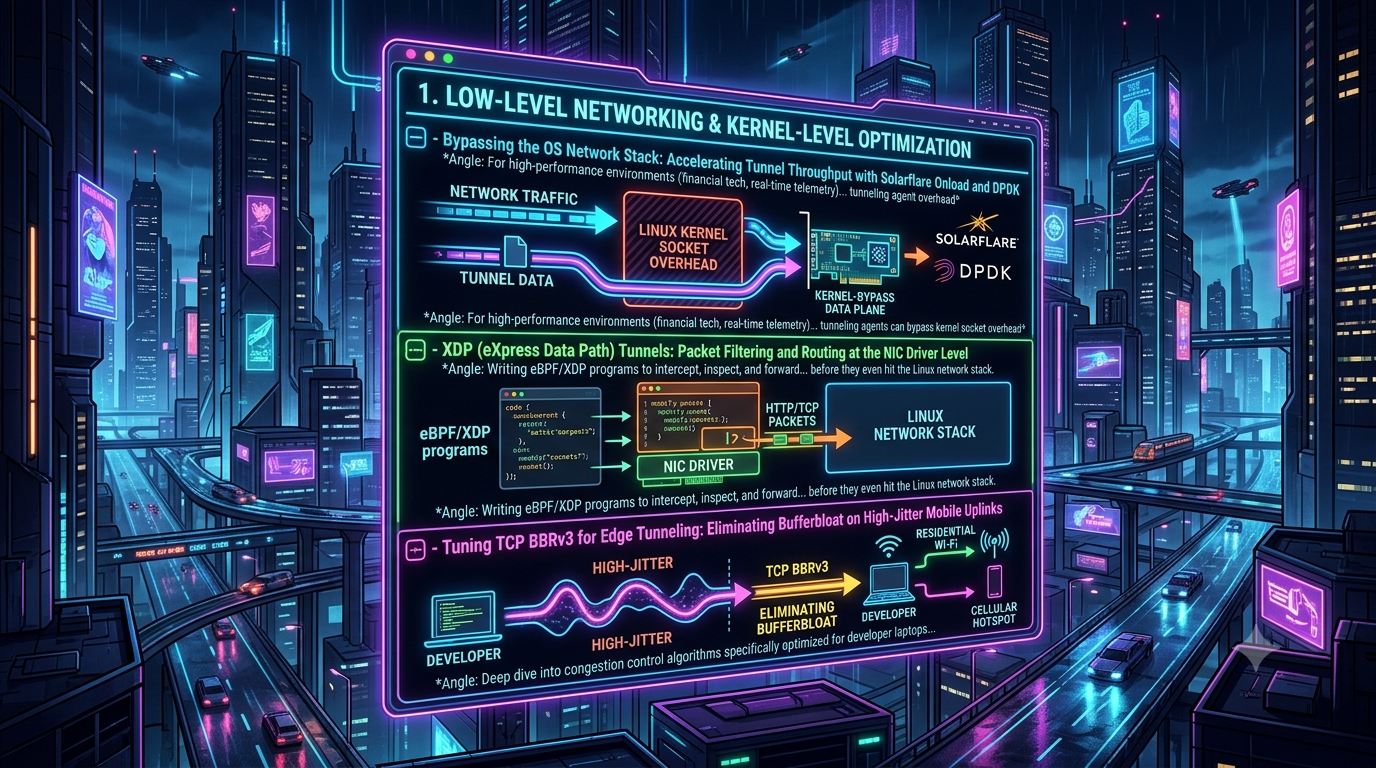
このガイドでは、問題の異なる部分にアプローチする3つの技術を紹介します:
- Kernelバイパスデータプレーン:AMD Solarflare OnloadとData Plane Development Kit (DPDK)を使用。
- eBPF/XDP(eXpress Data Path):ドライバレベルでパケットをフィルタリング・リダイレクトし、ソケットバッファの割り当て前に処理。
- BBR輻輳制御:セルラーや家庭用Wi-Fiアップリンクのような可変帯域幅・深いバッファを持つパス向け。
ただし、全体を通じて一つ注意点があります。パケットごとのCPUコストにはKernelバイパスとXDPだけが効果的です。BBRはネットワークパス上のキュー遅延に対処しますが、これは別の問題です。測定したボトルネックに合った技術を選びましょう。
1. Kernelバイパス:OnloadとDPDK
標準スタックの処理時間
通常のLinux受信パスでは、NICが割り込みを上げ、カーネルのNAPI層がデバイスをポーリングします。ドライバはsk_buffを割り当て、パケットはプロトコル層やnetfilterフックを通過します。最後にrecvのようなシステムコールがペイロードをユーザーメモリにコピーします。
現代のカーネルでは、NAPIや割り込みコアレス化により、多くの処理がバッチ化されており、1パケットごとの割り込みは避けられています。それでも、非常に高いパケットレートでは、割り当てやコピー、ロック、キャッシュトラフィックが積み重なり、遅延の予測性が低下します。
Kernelバイパス設計は、データパスをユーザ空間に移します。NICはDMAを使ってアプリケーションが所有するメモリにパケットを直接届け、アプリケーションはシステムコールなしで処理します。
Onload:ソケットアプリケーションの透過的高速化
SolarflareはXilinxに買収され、現在はAMDの一部です。Onloadソフトウェアは引き続きAMD Solarflare名で開発されており、ソースはGitHubのOpenOnloadとして公開されています。
- 仕組み: OpenOnloadはユーザーレベルの共有ライブラリで、ネットワーク関連のシステムコールをインターセプトし、TCP/UDPプロトコルスタックをユーザ空間で実装します。カーネルモジュールにサポートされており、既存のBSDソケットアプリとバイナリ互換性があります。ほとんどのアプリはコード変更不要です。
- ハードウェアパス: AMD Solarflareアダプタのネイティブ
ef_viインターフェースを使用します。ef_viは低遅延のAPIで、アプリから直接呼び出すことも可能です。 - 他のNIC: OnloadはLinuxのAF_XDPメカニズム上でも動作し、Solarflareハードウェアは不要です。ドキュメントによると、ネイティブ
ef_viパスの方がAF_XDPモードより高速化と追加機能が優れています。 - 対応ハードウェア: AMDの最新ラインはAlveo X3シリーズで、最大4×10/25 GbEポートを搭載。Onload、TCPDirect、
ef_viをサポートします。TCPDirectは、Onloadよりも低遅延を実現するユーザースタックです。古いSFN8522やSFN8542もサポートリストにあります。 - カーネルサポート: upstreamリポジトリは最近のカーネルを追跡し、READMEには現在6.1から7.0までのカーネルが記載されています。バージョン固定前に確認してください。
DPDK:ポーリングを中心としたフレームワーク
DPDKは、pollモードドライバ(PMD)を中心としたユーザースペースフレームワークです。アプリはNICの受信キューをビジーループでポーリングし、データパスに割り込みはありません。パケットバッファは巨大ページバックのメモリプールから取得します。Onloadとは異なり、DPDKは透過的ではなく、自分でパケット処理ループを書き、NICはカーネルネットワークスタックから一時的に取り除かれます。
リリース計画では、25.11が最新のLTSです。DPDKは約4ヶ月ごとに更新され、スケジュールには26.11.0(2026年11月18日)が記載されています。
バイパス展開のためのプロダクションチェックリスト
- コアの隔離: ポーリングスレッド専用のコアを割り当て、他の作業は避ける。DPDKのパフォーマンスガイドは
isolcpusと巨大ページ予約を推奨。Linux 6.6以降はデフォルトスケジューラがEEVDFに変わり、CFSに代わっています。どちらの場合もコアの隔離は重要です。 - NUMAローカルに保つ: 最良のパフォーマンスのため、ポーリングコアとNICは同じソケットに配置します。NICのノードは
/sys/bus/pci/devices/<アドレス>/numa_nodeで確認可能です。同じノードからパケットバッファを確保します。 - 巨大ページの予約: 起動時にパケットメモリプール用に確保します。
- 運用計画: バイパスインターフェースは
tcpdumpやiptables、通常のカーネル観測ツールでは見えなくなります。監視とデバッグの計画を立ててから運用開始してください。
ベンダーはこれらのスタックのレイテンシ比較結果を公開しています。例えばAMDのOnloadとカーネルTCPの結果などです。これらは特定のハードウェア、ペイロードサイズ、チューニング条件での測定値です。自分のワークロードに合わせてベンチマークしましょう。
2. XDP:ドライバレベルのプログラム可能パケット処理
XDPはLinux 4.8で導入され、eBPF上に構築されています。ネイティブドライバサポートにより、NICがパケットを受信した直後にXDPプログラムが実行され、カーネルがソケットバッファを割り当てる前に処理されます。これにより、ドロップやリダイレクトが非常に低コストになります。フルバイパスとは異なり、XDPは通常のカーネルスタックと並行して動作し、普通のソケットやツール、システムはそのまま機能します。
実行モード
- ネイティブ(ドライバ)モード: デフォルトで高速。ドライバサポートが必要。
- ジェネリック(SKB)モード: すべてのインターフェースで動作。スタックが
sk_buffを割り当てた後にフックを実行。開発向けで、パフォーマンスは低下。 - ハードウェアオフロード: NIC上でプログラムが動作。サポートは少ない。xdp-toolsのドキュメントによると、Netronome/Corigineの
nfpドライバを使うカードのみ対応。
例:トンネルピアの許可リスト
このスケッチは、ソースアドレスがユーザースペースで管理される許可リストマップにある場合を除き、UDPトンネルポートへのトラフィックをドロップします。LinuxのVXLANドライバはデフォルトでUDPポート8472を使用しますが、IANA割り当てのVXLANポートは4789です。VXLANはTCPではなくUDP上で動作します。同じロジックは他のUDPベースのトンネルにも適用可能です。
これはあくまで例示用のスケッチであり、堅牢なファイアウォールではありません。libbpfとxdp-toolsを使ってビルド・ロードしてください。
#include <linux/bpf.h>
#include <linux/if_ether.h>
#include <linux/in.h>
#include <linux/ip.h>
#include <linux/udp.h>
#include <bpf/bpf_helpers.h>
#include <bpf/bpf_endian.h>

#define TUNNEL_PORT 8472

struct {
    __uint(type, BPF_MAP_TYPE_HASH);
    __uint(max_entries, 1024);
    __type(key, __u32);   /* IPv4ソースアドレス */
    __type(value, __u8);
} allowed_peers SEC(".maps");

SEC("xdp")
int tunnel_peer_filter(struct xdp_md *ctx)
{
    void *data     = (void *)(long)ctx->data;
    void *data_end = (void *)(long)ctx->data_end;

    struct ethhdr *eth = data;
    if ((void *)(eth + 1) > data_end)
        return XDP_PASS;
    if (eth->h_proto != bpf_htons(ETH_P_IP))
        return XDP_PASS;

    struct iphdr *iph = (void *)(eth + 1);
    if ((void *)(iph + 1) > data_end)
        return XDP_PASS;
    if (iph->protocol != IPPROTO_UDP || iph->ihl < 5)
        return XDP_PASS;

    struct udphdr *udph = (void *)iph + (iph->ihl * 4);
    if ((void *)(udph + 1) > data_end)
        return XDP_PASS;

    if (bpf_ntohs(udph->dest) != TUNNEL_PORT)
        return XDP_PASS;

    __u32 src = iph->saddr;
    if (!bpf_map_lookup_elem(&allowed_peers, &src))
        return XDP_DROP;   /* 未知のピア:スタック前にドロップ */

    return XDP_PASS;
}

char _license[] SEC("license") = "GPL";
XDPのアクション
XDP_DROP: パケットをドライバ側で破棄し、バッファを受信リングに再利用。洪水攻撃やブロックリストに有効。XDP_PASS: パケットを通常のネットワークスタックに渡す(必要に応じて修正も可能)。XDP_TX: 受信したインターフェースからパケットを送り返す。アドレス書き換え後のロードバランサに利用。XDP_REDIRECT: リダイレクトマップを使って他の場所へ送信。ターゲットは別のXDP対応インターフェース(devmap)、別のCPU(cpumap)、またはユーザースペースのAF_XDPソケット(xskmap)など。
AF_XDPは前述のセクションへの橋渡しです。ユーザースペースがドライバキューから生のフレームを受信でき、完全なネットワークスタックを経由しません。AF_XDPソケットは単一のnetdevキューにバインドされ、XSKMAPタイプはLinux 4.18以降に存在します。DPDKのようなユーザースペースのデータパスを提供しつつ、NICはカーネル管理下にあります。OnloadもAF_XDPを利用可能です。
3. 可変レートエッジリンク向け輻輳制御
問題点
モバイルホットスポット、家庭用ルーター、セル基地局はしばしば大きなキューを保持し、バッファブロートを引き起こします。損失ベースのアルゴリズム(例:CUBIC)はウィンドウを増加させ続け、バッファがオーバーフローします。キューは満杯になり、共有するすべてのフローの遅延が増大します。
損失イベント後、CUBICは輻輳ウィンドウを0.7倍に減らします(RFC 9438では乗算減少係数は0.7と定義)。つまり、約30%の削減です(従来のRenoは50%)。
BBRの違い
BBRはモデルベースのアルゴリズムで、二つのパス特性を推定します:
- BtlBw: ボトルネック帯域幅、最大伝送速度
- RTprop: ラウンドトリップ伝搬遅延、空のキュー時の遅延
推定した帯域幅に合わせてパケットを送信し、送信量を帯域幅・遅延積(BDP)に近づけることで、キューを短く保ちつつ高スループットを実現します。これにより、パケット損失に頼らずに遅延とスループットを最適化します。
BBRv3はおそらくカーネルに含まれていません
net.ipv4.tcp_congestion_control = bbrを設定しても、LinuxのメインラインカーネルではBBRv1が有効になります。tcp_bbrモジュールはLinux 4.9以降にマージされ、BBRv1です。GoogleのBBRv3はgoogle/bbrリポジトリの別ブランチ(v3)にあり、より新しいカーネルにリベースされています。2025年のメンテナは、net-nextやメインラインにはまだBBRv1.xしかないと述べています。公式のリリースは未発表です。設定値はbbrのままなので、v1とv3の区別はできません。カーネルの出所(Googleのv3ブランチ、ディストリビューションのパッチ入りカーネル、サードパーティビルド)を確認してください。READMEにはsysctl net.ipv4.tcp_available_congestion_controlで利用可能なアルゴリズムを確認できると記載されています。
また、BBRv3は標準化も進められています。IETFのドラフトdraft-ietf-ccwg-bbrは、2026年7月の最新版(-06)で、バージョン3を規定しています。これはExperimental RFCとして公開予定です。
従来のv1に比べ、BBRv2・v3は損失やECN信号も考慮し、損失ベースのフロー(例:CUBIC)との共存性を向上させています。
トンネリングスタック内での適用箇所
輻輳制御は送信側で動作します。トンネルリレーの場合、以下のようになります:
- リレーの設定は、クライアントに向けて送信するトラフィック(例:ダウンロード)を制御します。
- クライアントの設定は、ローカルアップリンクのアップロードを制御します。
リレーだけを変更しても、セルリンクのラップトップからのアップロードには影響しません。また、TCP内にTCPをカプセル化するトンネルでは、内側と外側の輻輳制御が相互作用し、動作が悪化することがあります。WireGuardのようなUDPベースのトンネルは外側のTCPループを避けます。
基本的なsysctl設定例
/etc/sysctl.d/99-edge-bbr.confに以下を記述します:
# 公平キューイングqdisc:多フローのペース配分を効率化
net.core.default_qdisc = fq

# BBR(v1はメインライン、v3は対応カーネルのみ)
net.ipv4.tcp_congestion_control = bbr

# 高帯域遅延積パス向けにバッファ上限を引き上げ
net.core.rmem_max = 67108864
net.core.wmem_max = 67108864
net.ipv4.tcp_rmem = 4096 87380 33554432
net.ipv4.tcp_wmem = 4096 65536 33554432
これらの設定についての補足
fqは推奨だが必須ではない。 Linux 4.13以降、TCPスタックには内部ペース配分のフォールバック機能があり、他のqdiscとも併用可能です。sch_fqなしでは、TCPは高解像度タイマーでペース配分します。大規模な運用ではsch_fqを推奨します。- バッファサイズはパスに合わせて調整。 例:最大32MiBは約1Gbps、RTT250msのパスに適合(BDP約31MB)。遅いまたは短いパスには小さめで十分です。大きすぎるとメモリを消費します。
- ウィンドウスケーリングとタイムスタンプはデフォルトで有効です。
ECN:任意で設定し、誤りやすい
ECNはルータがパケットをドロップせずに輻輳を通知する仕組みです。カーネルのデフォルト設定はnet.ipv4.tcp_ecn=2で、着信接続に対してECNを受け入れますが、送信側には要求しません。1に設定すると、送信側もECNを要求します。
ただし、実際にECNを適用するルータが必要です。BBRv3のECNは、ecn_lowというルートごとの機能で制御され、RFC 3168のマークと異なるDCTCP/L4Sスタイルのマークを想定しています。一般的なトンネルや未知の最後の一マイルネットワークでは、オフにしておくのが無難です。tcp_ecn=1は実環境でテストしてから有効にしてください。
動作確認
ssコマンドでソケットの状態を確認します:
ss -tin '( dport = :443 or sport = :443 )'
出力にはpacing_rate、delivery_rate、minrttが含まれます。BBRv1カーネルではbbr:(...)のブロックに帯域幅とRTTの推定値が表示されます。BBRv3カーネルでは、ssの出力にv3固有の状態が表示されます。これらの値は、BBRが有効であることと、その推定値を示します。遅延低減の証明にはなりません。負荷下での遅延を測定し、pingや大容量転送と比較してください(例:CUBICとBBR)。
適切なツールの選択
| 問題 | 技術 | コスト |
|---|---|---|
| ソケットAPIアプリがカーネルCPUとジッターに制限される | Onload(透過的) | 特定NICまたはAF_XDPモードとOnloadカーネルモジュール |
| 高パケットレートの専用データプレーン | DPDK | ポーリングループと専用コア・NICを使ったアプリの全面書き換え |
| 早期フィルタリングやリダイレクト、カーネルスタックを維持したい | XDP / AF_XDP | eBPF開発とネイティブモードのドライバサポート |
| 可変最後の一マイルリンクの高遅延 | BBR with fq、CUBICと比較 |
実行中のBBRバージョンを確認してください |
ほとんどの開発者向けトンネリングリレーには、XDPの許可リストと適切な輻輳制御の調整が最初の現実的なステップです。完全なカーネルバイパスは、カーネルスタックがボトルネックと判明した特定のワークロードに限定されます。
参考資料
- DPDK Linux入門ガイド:IntelプラットフォームのNICパフォーマンス
- DPDKリリース状況会議録(2026年8月)
- Xilinx-CNS/onload on GitHub
- AMD Alveo X3シリーズアダプタ
- Kernelドキュメント:BPF_MAP_TYPE_XSKMAP
- xdp-loader(8)マニュアルページ
- google/bbr、v3ブランチREADME
- bbr-devスレッド:新しいカーネルでのBBRv3の使用
- IETF draft-ietf-ccwg-bbr-06
- RFC 9438:CUBIC
- Linuxカーネルコミット218af599fa63:TCP内部ペース配分
- Linux 6.6 EEVDFスケジューラ(Phoronix)
Related InstaTunnel pages
Continue from this article into the most relevant product guides and workflows.
Related Topics
Keep building with InstaTunnel
Read the docs for implementation details or compare plans before you ship.