Low-Level Networking & Kernel-Level Optimization: 高スループットなトンネルをGoとRustで設計
ローカル開発用トンネルの低レベルネットワーキングを習得。ゼロコピーシステムコールの実装、SO_REUSEPORTによるスケーリング、バッファブロートの解決方法を学ぶ。
Quick answer
ゼロコピーIngressとカーネル最適化による高スループット: webhook testing answer
For local webhook testing, run your app locally, expose it with a public HTTPS tunnel, and paste the stable callback URL into the provider dashboard.
How do I test webhooks on localhost?
Start your local server, open a public HTTPS tunnel to that port, configure the provider webhook URL, and inspect events in your local logs.
Why does a stable webhook URL matter?
Stable URLs prevent provider dashboards from needing manual callback updates every time you restart a tunnel.
現代の分散システムやローカル開発用トンネルツール(ngrok、Cloudflare Tunnels、またはカスタムエンタープライズゲートウェイ)および高頻度Webhookルーターは、妥協のないボトルネックに直面しています:Linuxカーネルとユーザースペースの境界。数十万の同時接続を処理し、ギガビット規模のテレメトリ、APIペイロード、またはファイル転送を行うプロキシデーモンをスケールさせる際、従来のソケットプログラミングパターン(read()やwrite())は崩壊します。CPUサイクルはコンテキストスイッチに浪費され、メモリバスは冗長なバッファコピーで飽和し、CPUキャッシュはスラッシュし、レイテンシは急上昇します。
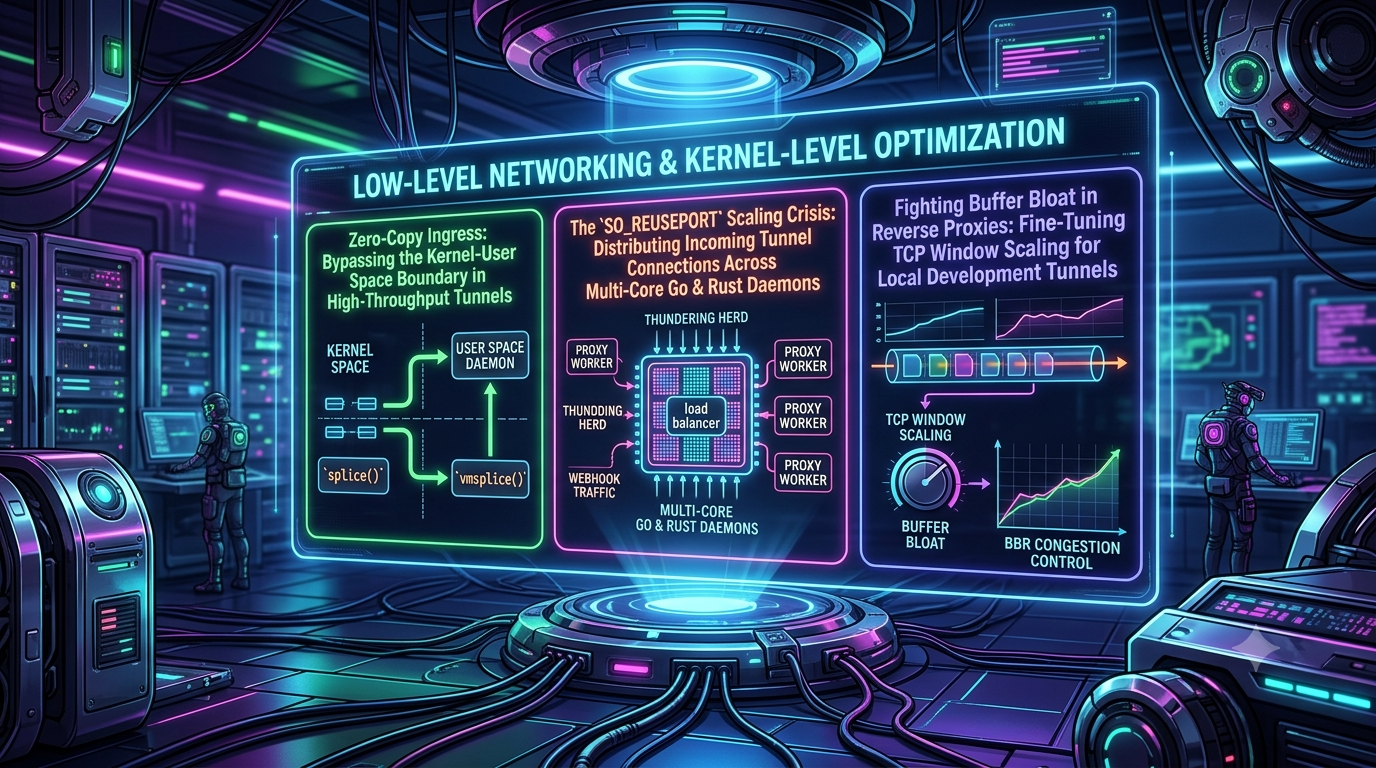
ワイヤースピードのトンネル性能を実現するには、Linuxネットワーキングスタックの深部に潜る必要があります。本ガイドでは、低レベル最適化の3つの重要な柱を探ります:splice()などのゼロコピープリミティブを用いたカーネルユーザースペース境界のバイパス、マルチコアGoとRustデーモン間のSO_REUSEPORTスケーリング問題の解決、そしてBBR輻輳制御とソケットチューニングによるバッファブロートの撲滅。
1. ゼロコピーIngress:高スループットトンネルにおけるカーネル-ユーザースペース境界のバイパス
プロキシにおける標準I/Oのコスト
標準的なプロキシデーモンの実装では、ネットワークソケットからトンネル接続へデータを移動させる際、多重のメモリコピーとコンテキストスイッチが発生します。従来のデータパス例は以下の通りです:
- NICからカーネルソケットバッファへ: NICのDMAが受信パケットをカーネルリングバッファ(sk_buff)に書き込み
- コンテキストスイッチ1: CPUがハードウェア割り込みをトリガーし、
read()呼び出し時にカーネル空間からユーザースペースへ - コピー1(カーネルからユーザ): カーネルがデータをプロキシの割り当てたユーザーバッファにコピー
- コンテキストスイッチ2: プロキシがヘッダーを処理または検査し、
write()やsend()を呼び出してペイロードをバックエンドまたはトンネルピアへ送信 - コピー2(ユーザからカーネル): カーネルがユーザーバッファからソケットの書き込みバッファへコピー
- カーネルからNICへ: ネットワークドライバが書き込みバッファからNICへDMAで送信
10Gbpsのトラフィックを扱うプロキシでは、このアーキテクチャはCPUに対し、すべてのバイトを2回コピーさせ、毎秒何百万ものコンテキストスイッチを強いるため、CPUキャッシュのスラッシュや遅延の増大を引き起こします。
splice()とvmsplice()を用いたカスタムプロキシデーモンの実装
Linuxはsplice()(およびvmsplice()やtee())システムコールを提供し、データをユーザースペースにコピーせずに2つのファイルディスクリプタ間で移動させることを可能にします。splice()はデータをパイプバッファ(pipefs)に移動し、これはカーネル内のリングバッファとして動作します。
+---------------------------------------------------------+
|                  従来のI/Oパス                          |
|                                                         |
|  [NIC] - [Kernel Socket] --- (コンテキストスイッチ)     |
|                          --- [ユーザースペースバッファ] |
|                          --- (コンテキストスイッチ)     |
|                          --- [Kernel Socket] - [NIC]  |
+---------------------------------------------------------+

+---------------------------------------------------------+
|                     ゼロコピー`splice()`                |
|                                                         |
|  [インバウンドソケット] --                                   |
|                                                        |
|                       +-- [カーネル内パイプバッファ]      |
|                      /                                  |
|  [アウトバウンドソケット] -/                                   |
|  (データはユーザースペースに入らず、CPUキャッシュのスラッシュなし) |
+---------------------------------------------------------+
splice()の動作原理
splice()のC言語におけるシグネチャは以下の通りです:
loff_t splice(int fd_in, loff_t *off_in, int fd_out, loff_t *off_out, size_t len, unsigned int flags);
RustやGoで高スループットのプロキシデーモンを構築する際、splice()はFFIや直接のシステムコールラッパー(RustのnixクレートやGoのgolang.org/x/sys/unix)を通じてラップできます。
インカミングソケット(client_fd)とアウトゴーイングトンネルソケット(tunnel_fd)を中間のパイプを経由して接続する例:
- 匿名パイプの作成:
pipe2(O_NONBLOCK)を用いて一方向パイプペアを作成し、デーモン起動時に設定 - インバウンドをパイプにスプライス:
splice(client_fd, NULL, pipe_write_fd, NULL, len, SPLICE_F_MOVE | SPLICE_F_NONBLOCK)を呼び出し、カーネルにソケットバッファのページ参照をコピーせずにパイプバッファリングに直接リンクさせる - パイプからアウトバウンドへスプライス:
splice(pipe_read_fd, NULL, tunnel_fd, NULL, len, SPLICE_F_MOVE | SPLICE_F_NONBLOCK)を呼び出し、カーネルがパイプのページを直接ターゲットソケットに流し込む
アーキテクチャの注意点とエッジケース
- ファイルディスクリプタの制約:
splice()に渡す2つのファイルディスクリプタのうち少なくとも一つはパイプを指している必要があります。ソケットAからソケットBへの直接スプライスはできず、中間のパイプを経由させる必要があります。 - ノンブロッキングのセマンティクス: プロキシは
EAGAINを適切に処理する必要があります。パイプが満杯またはソケットバッファが受け入れられない場合、splice()は-1とerrno=EAGAINを返し、epollやkqueueのイベントループと連携させる必要があります。 - TLSと復号化:
splice()は生のバイトストリーム上で動作します。トンネルがプロキシ層でTLS終端を行う場合、標準のsplice()は暗号化された暗号文には適用できません。ただし、カーネルレベルのTLS(KTLS)オフロード(setsockoptでSOL_TCPとTCP_ULPを設定)を利用すれば、カーネル内でTLS復号化を行い、splice()でクリアテキストペイロードを直接プロキシルーティングパイプにストリームできます。
2. SO_REUSEPORTのスケーリング問題:マルチコアGo&Rustデーモン間のインカミングトンネル接続の分散
サンダリングハード問題とシングルソケットのボトルネック
従来、高性能ネットワークデーモンは単一のリスニングソケット(listenfd)に依存していました。新しいTCP接続が3ウェイハンドシェイクを経て到着すると、カーネルはaccept()待ちのワーカースレッドやプロセスを起動します。
この設計は有名なサンダリングハード問題を引き起こします:すべてのワーカーが同時に起き上がり、acceptキューのミューテックスロックを争い、最終的に一つだけが接続を受け入れ、残りは再び待機状態に戻る。128コアのサーバーで毎秒10万の新規接続を処理する場合、これは致命的なCPUロックコンテンドを生み出し、レイテンシを爆発的に増加させます。
SO_REUSEPORTの登場
このシングルリスナーのボトルネックを解消するために、LinuxはSO_REUSEPORTソケットオプション(Linux 3.9以降で大幅に拡張)を導入しました。SO_REUSEPORTは複数の独立したソケットが同じIPアドレスとポートにバインドできるようにします。
接続が到着すると、カーネルのTCP層は4つ組(送信元IP、送信元ポート、宛先IP、宛先ポート)に基づくハッシュアルゴリズムを用いて、受信した接続を特定のリスナーソケットに直接ルーティングします。各ワーカースレッドやプロセスは独立したリスナーソケットとacceptキューを持ち、ロックコンテンドを完全に排除します。
                         [着信TCP SYNパケット]
                                     |
                                     v
                       +---------------------------+
                       | カーネル4-組ハッシュリング |
                       +---------------------------+
                        /            |            \
                       /             |             \
                      v              v              v
               [ワーカースレッド1] [ワーカースレッド2] [ワーカースレッド3]
               (SO_REUSEPORT)    (SO_REUSEPORT)    (SO_REUSEPORT)
GoとRustでのSO_REUSEPORTの実装
Goの実装課題
Goのランタイムはnetパッケージ内のネットポーラー(epollを利用)を管理し、ソケット作成を抽象化しています。標準のnet.ListenはSO_REUSEPORTを設定しません。
GoでSO_REUSEPORTを利用してマルチコアスケーリングを行うには、バインド前にsyscallコールバックを用いてソケットを設定する必要があります:
package main

import (
	"context"
	"fmt"
	"net"
	"syscall"
)

func createReusePortListener(network, address string, port int) (net.Listener, error) {
	lc := net.ListenConfig{
		Control: func(network, address string, c syscall.RawConn) error {
			var err error
			c.Control(func(fd uintptr) {
				// SO_REUSEADDRを設定
				err = syscall.SetsockoptInt(int(fd), syscall.SOL_SOCKET, syscall.SO_REUSEADDR, 1)
				if err != nil {
					return
				}
				// SO_REUSEPORTを設定
				err = syscall.SetsockoptInt(int(fd), syscall.SOL_SOCKET, syscall.SO_REUSEPORT, 1)
			})
			return err
		},
	}

	addr := fmt.Sprintf("%s:%d", address, port)
	return lc.Listen(context.Background(), network, addr)
}
Rustの実装
Rustでは、TokioやMioのような非同期ランタイムを用いて、socket2クレートなどを使い、SO_REUSEPORTを設定したカスタムソケットを複数のワーカースレッドに渡すことが可能です:
use socket2::{Domain, Protocol, Socket, Type};
use std::net::SocketAddr;

fn create_reuse_listener(addr: SocketAddr) -> std::io::Result<std::net::TcpListener> {
    let domain = Domain::for_address(addr);
    let socket = Socket::new(domain, Type::STREAM, Some(Protocol::tcp()))?;
    // SO_REUSEADDRとSO_REUSEPORTを有効化
    socket.set_reuse_address(true)?;
    socket.set_reuse_port(true)?;
    socket.set_nonblocking(true)?;
    socket.bind(&addr.into())?;
    socket.listen(1024)?;
    Ok(socket.into())
}
SO_REUSEPORTのスケーリング危機:Webhookバースト時の接続偏り
SO_REUSEPORTはロックコンテンドを解消しますが、特定のトラフィック分布下では微妙なスケーリング問題を引き起こすことがあります。特に、GitHubやStripe、SlackのWebhookなど、単一のクラウドプロバイダーからの高頻度Webhookトラフィックです。
不均衡の根本原因
SO_REUSEPORTのハッシュ関数は、ソケット作成時に生成される静的なハッシュキーを使用します。Webhookトラフィックは、特定の大手プロバイダーからのもので、ソースIPのプールが限定的なため、4-組のエントロピーが制約されます。
結果として、カーネルのハッシュ関数はハッシュ衝突や偏りを起こし、Webhook接続の80%をワーカースレッド1にルーティングし、他のワーカーはアイドル状態になることがあります。これにより、スレッドの飢餓状態やキューのバックアップ、タイムアウトの発生につながります。
対策
- BPFロードバランシング(
SO_ATTACH_REUSEPORT_CBPF/ EBPF): 既定のハッシュに頼らず、高度なプロキシはsetsockoptのSO_ATTACH_REUSEPORT_EBPFを用いてカスタムeBPFプログラムをリスナーソケットにアタッチします。eBPFはペイロードやHTTPヘッダー、カスタムルーティングキーを検査し、ソケット選択インデックスを明示的に制御し、ラウンドロビンや負荷分散を最適化します。 - ワークステーリング受け入れキュー: ユーザースペースのデーモンアーキテクチャでは、ワーカーはオーバーフローループバッファを共有します。ワーカーの受け入れ速度が処理能力を超える場合、新たに受け入れたファイルディスクリプタは共有のワークキューにプッシュされ、アイドルワーカーがプルして処理します。
3. リバースプロキシにおけるバッファブロート対策:TCPウィンドウスケーリングの微調整
トンネルにおけるバッファブロートとは
ローカル開発用トンネル(例:http://localhost:3000を公開インターネットに公開)は複雑なネットワークトポロジーを伴います。開発者は、500 Mbpsの光ファイバーや30ms〜80msの遅延を持つ家庭用回線、またはモバイルホットスポットを通じてこれらのトンネルをテストします。
バッファブロートは、ルータやISPのキュー、LinuxカーネルのTCPソケット受信/送信バッファの過剰容量が満杯になる現象です。中間バッファはパケットをドロップせずにキューに溜め込み、遅延を増大させます。大容量ファイルアップロードやアーティファクト展開を伴う逆プロキシは、バッファの膨張により遅延が25msから2000ms超に跳ね上がり、インタラクティブなストリームを破壊し、HTTPゲートウェイタイムアウトを引き起こします。
大容量ファイルアップロード時の遅延スパイクの診断
ssやbpftrace、ethtoolなどのツールでプロキシデーモンを調査すると、次のような現象が観測されます:
* 膨張した送受信キュー: ss -t -iのSend-QとRecv-Qが高いまま維持
* 積極的なCUBIC輻輳崩壊: LinuxのTCPスタックは従来CUBICを用いており、ウィンドウサイズを積極的に増加させ、パケットロスで調整します。高帯域遅延リンク(高BDP)では、CUBICはルータバッファを過剰に満たし、巨大なキュー遅延を引き起こします。
BDP(帯域遅延積)の計算式
BDPは、ネットワークリンクを完全に飽和させるために「飛んでいる」データ量を示します:
$$\text{BDP (ビット)} = \text{帯域幅 (bps)} \times \text{ラウンドトリップタイム (秒)}$$
例:100 MbpsのトンネルとRTT50ms(0.050秒)の場合:
$$\text{BDP} = 100,000,000 \times 0.050 = 5,000,000 \text{ビット} = 625,000 \text{バイト} \approx 610 \text{KB}$$
Linuxのソケットバッファ(net.ipv4.tcp_wmem)が16MBに静的に設定されていると、TCPスタックはこの容量を超えるデータをバッファに流し込み、ローカルNICや中継バッファが膨張し、インタラクティブ性が失われます。
BBR輻輳制御とソケットバッファの微調整
1. BBR(Bottleneck Bandwidth and RTT)への切り替え
CUBICはパケットロスに反応しますが、GoogleのBBRはネットワークのボトルネックをモデル化し、最大伝送速度と最小RTTを継続的に測定します。パケットの送信間隔を実路の容量に合わせて調整し、バッファの過充填を避けます。
LinuxのプロキシサーバにBBRを有効にするには:
# 利用可能な輻輳制御アルゴリズムの確認
sysctl net.ipv4.tcp_available_congestion_control

# BBRを即時有効化
sudo sysctl -w net.core.default_qdisc=fq
sudo sysctl -w net.ipv4.tcp_congestion_control=bbr

# 永続化設定(/etc/sysctl.confに追加)
echo "net.core.default_qdisc=fq" | sudo tee -a /etc/sysctl.conf
echo "net.ipv4.tcp_congestion_control=bbr" | sudo tee -a /etc/sysctl.conf
2. 動的ソケットバッファ調整(tcp_rmemとtcp_wmem)
静的設定や過剰なメモリ割り当てを避け、/etc/sysctl.confで高BDPトンネルに適した動的調整を行います:
# 最小値、デフォルト値、最大値(バイト単位)
net.ipv4.tcp_rmem = 4096 87380 16777216

# 送信バッファの最小値、デフォルト値、最大値
net.ipv4.tcp_wmem = 4096 65536 16777216

# TCPウィンドウスケーリング(RFC 1323)の有効化
net.ipv4.tcp_window_scaling = 1

# MTUディスカバリの有効化
net.ipv4.tcp_mtu_discovery = 1
3. GoとRustのプロキシデーモンでのプログラム的ソケット調整
システム全体のsysctl設定に加え、実行時にソケットのバッファサイズや輻輳制御を明示的に設定します。
Rustによる設定例(輻輳制御とバッファサイズの設定):
use socket2::{Socket, Domain, Type, Protocol};
use std::os::unix::io::AsRawFd;

fn tune_proxy_socket(socket: &Socket) -> std::io::Result<()> {
    // 例:バッファを2MBに設定
    socket.set_send_buffer_size(2 * 1024 * 1024)?;
    socket.set_recv_buffer_size(2 * 1024 * 1024)?;
    // BBRに設定
    let bbr = b"bbr\0";
    unsafe {
        let ret = libc::setsockopt(
            socket.as_raw_fd(),
            libc::IPPROTO_TCP,
            libc::TCP_CONGESTION,
            bbr.as_ptr() as *const libc::c_void,
            bbr.len() as libc::socklen_t,
        );
        if ret != 0 {
            return Err(std::io::Error::last_os_error());
        }
    }
    Ok(())
}
Goによる設定例(ソケットオプションの設定):
import (
	"net"
	"syscall"
)

func configureSocketBuffers(c net.Conn) error {
	tcpConn, ok := c.(*net.TCPConn)
	if !ok {
		return nil
	}

	rawConn, err := tcpConn.SyscallConn()
	if err != nil {
		return err
	}

	var sockErr error
	err = rawConn.Control(func(fd uintptr) {
		// 送信バッファを2MBに設定
		sockErr = syscall.SetsockoptInt(int(fd), syscall.SOL_SOCKET, syscall.SO_SNDBUF, 2*1024*1024)
		if sockErr != nil {
			return
		}
		// 受信バッファを2MBに設定
		sockErr = syscall.SetsockoptInt(int(fd), syscall.SOL_SOCKET, syscall.SO_RCVBUF, 2*1024*1024)
		if sockErr != nil {
			return
		}
		// BBRに設定
		sockErr = syscall.SetsockoptString(int(fd), syscall.IPPROTO_TCP, syscall.TCP_CONGESTION, "bbr")
	})

	if err != nil {
		return err
	}
	return sockErr
}
まとめとアーキテクチャのチェックリスト
高スループット・低レイテンシのトンネルプロキシを構築するには、単純なアプリケーション層の抽象化を超え、Linuxカーネルのネットワーキングサブシステムを深く理解する必要があります。以下の技術を導入することで、主要なパフォーマンスボトルネックを排除できます:
- CPUキャッシュのスラッシュを排除:
splice()やvmsplice()を用いたゼロコピーIngressルーティングと、KTLSによる大容量ペイロードのカーネル内処理 - マルチコアデーモンの安全なスケーリング:
SO_REUSEPORTとカスタムeBPFパケットフィルタを併用し、Webhookやトンネル接続をワーカースレッドに均等に分散 - バッファブロートの撲滅: 旧式のCUBICからBBRへ切り替え、Fair Queueing (
fq)を有効化し、ソケットの送受信バッファを動的に調整
これらの低レベル最適化を実装することで、プロキシデーモンは数百万リクエスト、ギガビット規模のスループット、サブミリ秒のレイテンシを維持し、極端なネットワーク変動下でも安定して動作します。
Related InstaTunnel pages
Continue from this article into the most relevant product guides and workflows.
Related Topics
Keep building with InstaTunnel
Read the docs for implementation details or compare plans before you ship.